






Captura de HTML renderizado
Capture o DOM após o JavaScript finalizar a página
Algumas páginas públicas retornam conteúdo útil na primeira resposta HTML. Outras enviam uma estrutura fina e constroem o artigo, lista de produtos, tabela, rota ou resultado de busca apenas após a execução do JavaScript do lado do navegador. HTML renderizado é para esse segundo caso: quando o parser precisa do DOM final, não apenas da marcação de origem.
ScraperFly permite que as equipes comparem HTML bruto com HTML renderizado pelo navegador, e então habilitem a renderização apenas para alvos que provem que precisam disso. Você mantém páginas simples rápidas e acessíveis, enquanto ainda tem um caminho de atualização limpo para conteúdo público construído em JavaScript.
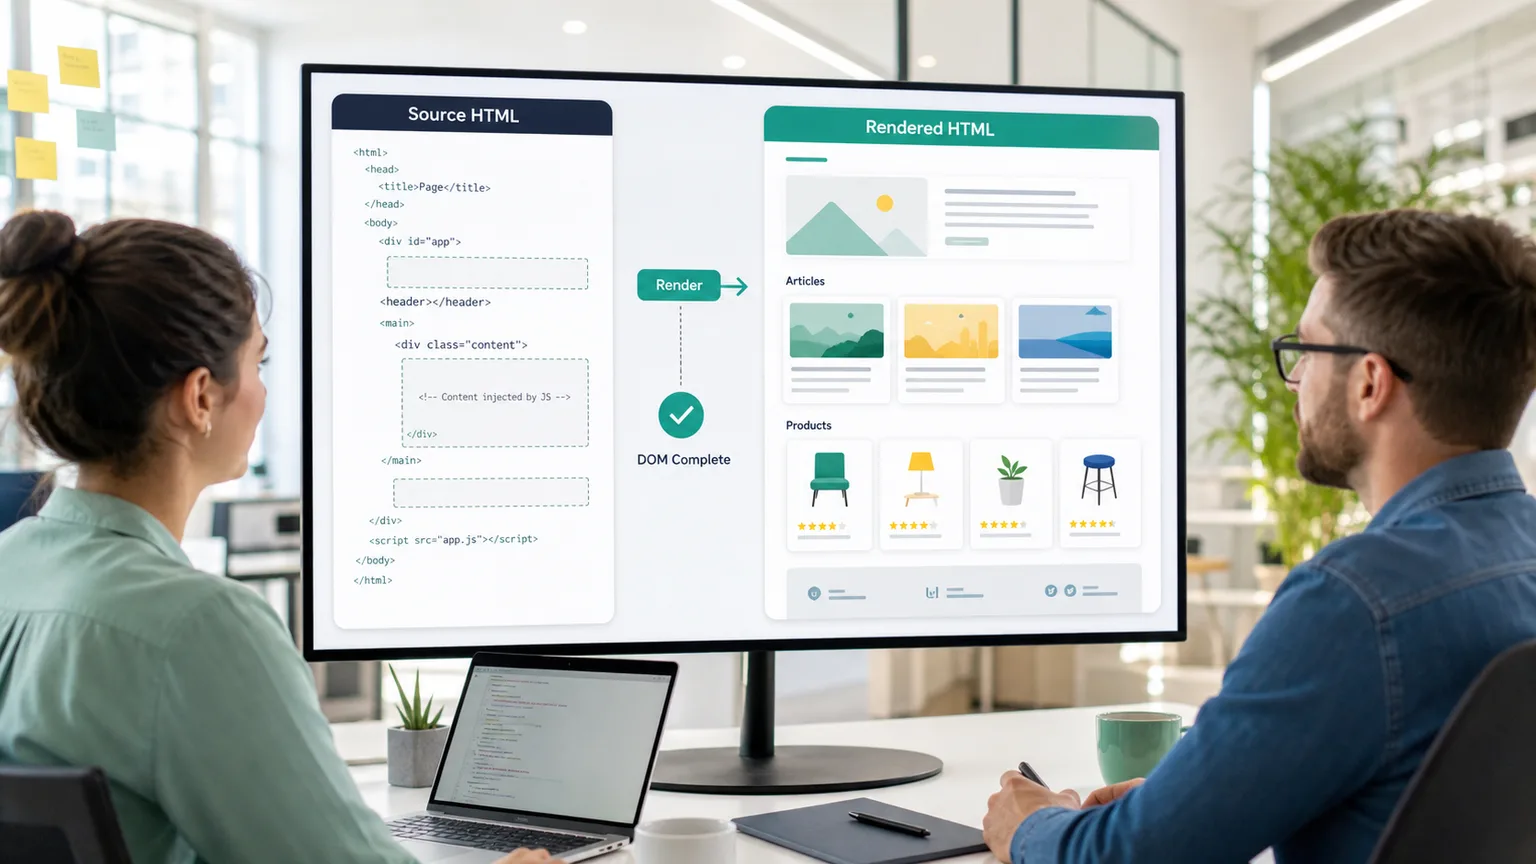
O que é uma API de HTML renderizado?
Uma API de HTML renderizado busca uma página pública, executa JavaScript do lado do navegador, espera o estado da página se estabilizar e retorna a marcação HTML resultante. Em vez de analisar a resposta de origem original, sua aplicação recebe o DOM após o frontend ter tido a chance de criar o conteúdo útil.
Isso é diferente de uma captura de tela ou PDF. Uma captura de tela prova como a página parecia. Um PDF fornece um registro visual portátil. HTML renderizado mantém a página como marcação, para que os parsers ainda possam inspecionar cabeçalhos, links, tabelas, atributos, cartões de produtos, corpos de artigos, paginação, dados incorporados e padrões de DOM repetidos.
Conclusão prática: use HTML renderizado quando o JavaScript altera a marcação que seu parser precisa, não quando uma simples solicitação de origem já retorna conteúdo completo.
Quando uma página deve usar HTML renderizado em vez de HTML bruto?
A decisão deve vir de evidências. Comece com HTML bruto, inspecione o que retorna e compare com uma captura renderizada. Se a resposta de origem já contém o corpo útil do artigo, tabela, dados do produto, links ou metadados, mantenha a solicitação leve. Se a resposta de origem estiver faltando o conteúdo, contiver contêineres de rota vazios ou apenas expuser espaços reservados, HTML renderizado é a melhor entrada.
| Comportamento alvo | O que HTML bruto mostra | Melhor solicitação |
|---|---|---|
| Página pública estática | Texto completo, links e metadados aparecem na primeira resposta. | Use HTML bruto, texto ou Markdown sem renderização do navegador. |
| Página renderizada pelo cliente | A resposta contém uma estrutura de aplicativo, contêiner de rota ou área de conteúdo vazia. | Use HTML renderizado para que o parser veja o DOM completo. |
| Conteúdo atrasado | Cartões ou tabelas importantes aparecem apenas após a conclusão de solicitações assíncronas. | Use renderização com uma espera medida em vez de tentativas cegas. |
| Prova de layout necessária | O parser precisa de marcação, mas os revisores também precisam de evidência visual. | Use HTML renderizado para análise e capturas de tela ou PDFs apenas para registros de prova selecionados. |
| Conteúdo regional ou com estado | O resultado visível muda por idioma, localização, cookies ou estado anterior. | Teste cabeçalhos, roteamento por país ou sessões antes de tornar a renderização o padrão. |
O que as equipes podem extrair de HTML renderizado?
HTML renderizado ainda é HTML. Isso o torna útil quando o código a montante precisa de seletores, atributos, relações estruturais, links canônicos, paginação, cartões de produtos, comentários carregados, corpos de artigos hidratados ou qualquer seção da página que aparece após a execução do frontend. Ele fornece ao seu parser a marcação final sem forçar um humano a ler uma captura de tela.
A API não elimina a necessidade de regras específicas para o alvo. Sua aplicação ainda decide quais campos importam, como os registros são validados, como duplicatas são tratadas e para onde os dados extraídos vão. ScraperFly lida com o lado da captura: execução do navegador, opções de solicitação, formatos de resposta, metadados e controles de entrega.
| Necessidade do parser | HTML renderizado ajuda porque | Saída útil acompanhante |
|---|---|---|
| Cartões de produtos ou listagens | O DOM final contém elementos repetidos que a resposta de origem pode não incluir. | Metadados JSON para status e URL final. |
| Captura do corpo do artigo | Conteúdo hidratado pode ser analisado como marcação após a execução do navegador. | Texto ou Markdown para revisão legível. |
| Páginas de busca ou categoria | Seções renderizadas expõem links, filtros, paginação e ordenação visível. | Captura de tela para prova ocasional de QA. |
| Fluxos de trabalho de monitoramento | O parser pode comparar marcação completa em vez de estruturas vazias. | Metadados e tamanho da resposta para diagnósticos de mudança. |
| Ingestão de IA ou RAG | HTML renderizado pode ser convertido em texto ou Markdown mais limpo após o conteúdo dinâmico aparecer. | Markdown para contexto pronto para modelo. |
Para decisões de formato mais amplas, compare os formatos de resposta da API de web scraping. Se seu fluxo de trabalho precisar do caminho completo de execução do navegador, revise a página da API de renderização JavaScript também.
Como as equipes devem testar HTML renderizado antes da produção?
Escolha algumas URLs públicas representativas e teste-as no API Builder. Compare HTML de origem bruto, HTML renderizado, tamanho da resposta, URL final, tipo de conteúdo e tempo de espera. O objetivo não é ativar a renderização em todos os lugares. O objetivo é identificar quais grupos-alvo precisam disso e quais podem permanecer em um perfil de solicitação mais barato e rápido.
Quando uma solicitação renderizada está vazia, não reescreva imediatamente o parser. Primeiro, verifique se a página redirecionou, retornou um estado de consentimento ou bloqueio, precisou de uma espera mais longa, mudou por país ou idioma, ou retornou uma resposta que é grande demais para a captura pretendida. Um bom depurador separa problemas de captura de problemas de parser.
Conclusão prática: HTML renderizado deve ser validado contra páginas-alvo reais antes de se tornar parte de um fluxo de trabalho recorrente.
Como HTML renderizado afeta custo e confiabilidade?
O trabalho do navegador é mais pesado do que uma busca básica. É exatamente por isso que ScraperFly trata a renderização como um controle de solicitação deliberado. Uma página pública simples não deve pagar o mesmo custo operacional que uma página pesada em JavaScript que precisa de execução do navegador, esperas, capturas de tela, arquivos, roteamento por país ou entrega premium.
Use créditos gratuitos para testar resultados brutos e renderizados. Mantenha capturas simples em HTML de origem, texto ou Markdown. Adicione renderização apenas onde isso melhora a completude. Use créditos pay-as-you-go enquanto os alvos e volumes ainda são incertos, depois mova cargas de trabalho renderizadas recorrentes previsíveis para créditos mensais uma vez que o padrão esteja provado. A página de preços e o calculador de custo de crédito ajudam a mapear o peso da solicitação para o comportamento real do alvo.
Onde o HTML renderizado se encaixa no fluxo de trabalho do ScraperFly?
HTML renderizado fica entre a captura básica de HTML e a saída totalmente visual. Comece com a API de scraping de HTML quando a marcação de origem estiver completa. Mova para HTML renderizado quando o JavaScript criar o DOM útil. Escolha texto ou Markdown quando o consumidor a montante precisar de conteúdo legível em vez de seletores. Adicione capturas de tela ou PDFs quando o fluxo de trabalho precisar de prova de aparência.
Isso permite que as equipes mantenham a primeira solicitação simples, tornem a escalada baseada em evidências e forneçam aos parsers a marcação que realmente precisam. O resultado é menos infraestrutura de navegador personalizada, menos tentativas cegas e um caminho mais limpo do teste de alvo à captura de produção.







