






Рендеринг HTML захвата
Захватите DOM после завершения JavaScript на странице
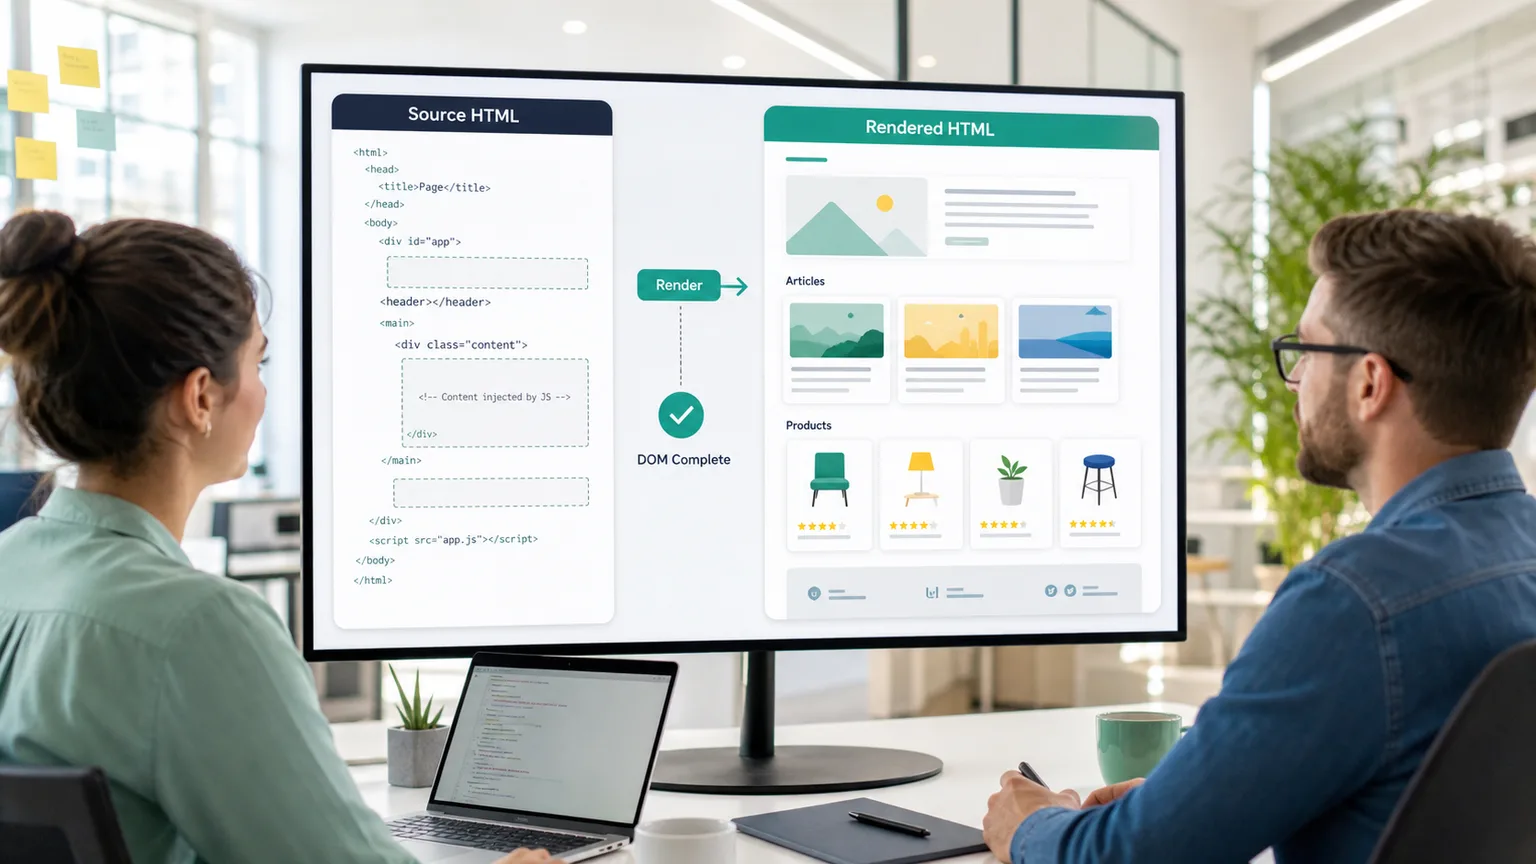
Некоторые публичные страницы возвращают полезный контент в первом HTML-ответе. Другие отправляют тонкую оболочку и строят статью, список продуктов, таблицу, маршрут или результат поиска только после выполнения JavaScript на стороне браузера. Рендеринг HTML предназначен для второго случая: когда парсеру нужен окончательный DOM, а не просто исходная разметка.
ScraperFly позволяет командам сравнивать сырой HTML с HTML, отрендеренным браузером, а затем включать рендеринг только для целей, которые доказывают, что они в этом нуждаются. Вы сохраняете простые страницы быстрыми и доступными, при этом имея чистый путь к обновлению для публичного контента, созданного с помощью JavaScript.
Что такое API рендеринга HTML?
API рендеринга HTML получает публичную страницу, выполняет JavaScript на стороне браузера, ждет, пока состояние страницы стабилизируется, и возвращает результирующую HTML-разметку. Вместо того чтобы парсить оригинальный исходный ответ, ваше приложение получает DOM после того, как фронтенд успел создать полезный контент.
Это отличается от скриншота или PDF. Скриншот подтверждает, как выглядела страница. PDF предоставляет переносимый визуальный отчет. Рендеринг HTML сохраняет страницу в виде разметки, так что парсеры все еще могут проверять заголовки, ссылки, таблицы, атрибуты, карточки продуктов, тела статей, пагинацию, встроенные данные и повторяющиеся шаблоны DOM.
Практическое замечание: используйте рендеринг HTML, когда JavaScript изменяет разметку, необходимую вашему парсеру, а не когда простой исходный запрос уже возвращает полный контент.
Когда странице следует использовать рендеринг HTML вместо сырого HTML?
Решение должно основываться на доказательствах. Начните с сырого HTML, проверьте, что возвращается, и сравните это с рендерингом. Если исходный ответ уже содержит полезное тело статьи, таблицу, данные о продукте, ссылки или метаданные, оставьте запрос легким. Если исходный ответ не содержит контента, содержит пустые контейнеры маршрутов или только показывает заполнители, рендеринг HTML является лучшим вариантом.
| Целевое поведение | Что показывает сырой HTML | Лучший запрос |
|---|---|---|
| Статическая публичная страница | Полный текст, ссылки и метаданные появляются в первом ответе. | Используйте сырой HTML, текст или Markdown без рендеринга браузера. |
| Страница, рендеренная клиентом | Ответ содержит оболочку приложения, контейнер маршрута или пустую область контента. | Используйте рендеринг HTML, чтобы парсер видел завершенный DOM. |
| Задержанный контент | Важные карточки или таблицы появляются только после завершения асинхронных запросов. | Используйте рендеринг с измеренной задержкой, а не слепыми повторными попытками. |
| Нужна проверка макета | Парсеру нужна разметка, но рецензенты также нуждаются в визуальных доказательствах. | Используйте рендеринг HTML для парсинга и скриншоты или PDF только для выбранных доказательств. |
| Региональный или состоящий контент | Видимый результат меняется в зависимости от языка, местоположения, файлов cookie или предыдущего состояния. | Проверьте заголовки, маршрутизацию по странам или сессии перед тем, как сделать рендеринг по умолчанию. |
Что команды могут извлечь из рендеринга HTML?
Рендеринг HTML все еще является HTML. Это делает его полезным, когда последующий код нуждается в селекторах, атрибутах, структурных отношениях, канонических ссылках, пагинации, карточках продуктов, загруженных комментариях, гидратированных телах статей или любом разделе страницы, который появляется после выполнения фронтенда. Он предоставляет вашему парсеру окончательную разметку, не заставляя человека читать скриншот.
API не отменяет необходимость в специфических для цели правилах. Ваше приложение все еще решает, какие поля важны, как проверяются записи, как обрабатываются дубликаты и куда идет извлеченные данные. ScraperFly обрабатывает захват: выполнение браузера, параметры запроса, форматы ответов, метаданные и управление доставкой.
| Нужда парсера | Рендеринг HTML помогает, потому что | Полезный сопутствующий вывод |
|---|---|---|
| Карточки продуктов или списков | Окончательный DOM содержит повторяющиеся элементы, которые могут отсутствовать в исходном ответе. | JSON-метаданные для статуса и окончательного URL. |
| Захват тела статьи | Гидратированный контент может быть распарсен как разметка после выполнения браузера. | Текст или Markdown для удобного просмотра. |
| Страницы поиска или категории | Рендеренные секции открывают ссылки, фильтры, пагинацию и видимый порядок. | Скриншот для периодического QA-доказательства. |
| Мониторинг рабочих процессов | Парсер может сравнивать завершенную разметку вместо пустых оболочек. | Метаданные и размер ответа для диагностики изменений. |
| Ингеста AI или RAG | Рендеринг HTML может быть преобразован в более чистый текст или Markdown после появления динамического контента. | Markdown для контекста, готового для модели. |
Для более широких решений по форматам сравните форматы ответов API веб-скрапинга. Если ваш рабочий процесс требует полного пути выполнения браузера, также ознакомьтесь со страницей API рендеринга JavaScript.
Как командам тестировать рендеринг HTML перед производством?
Выберите несколько представительных публичных URL и протестируйте их в API Builder. Сравните сырой исходный HTML, рендеринг HTML, размер ответа, окончательный URL, тип контента и время ожидания. Цель не в том, чтобы включить рендеринг повсюду. Цель состоит в том, чтобы определить, какие целевые группы нуждаются в этом, а какие могут оставаться на более дешевом, быстром профиле запроса.
Когда рендеринг запроса пуст, не спешите переписывать парсер. Сначала проверьте, перенаправила ли страница, вернула ли состояние согласия или блокировки, требовала ли более длительного ожидания, изменилась ли по стране или языку, или вернула ответ, который слишком велик для предполагаемого захвата. Хорошая отладка отделяет проблемы захвата от проблем парсера.
Практическое замечание: рендеринг HTML должен быть проверен на реальных целевых страницах, прежде чем он станет частью повторяющегося рабочего процесса.
Как рендеринг HTML влияет на стоимость и надежность?
Работа браузера тяжелее, чем простой запрос. Именно поэтому ScraperFly рассматривает рендеринг как целенаправленное управление запросами. Простая публичная страница не должна нести такие же операционные расходы, как страница с тяжелым JavaScript, которая требует выполнения браузера, ожидания, скриншотов, файлов, маршрутизации по странам или премиум-доставки.
Используйте бесплатные кредиты для тестирования сырых и рендеренных результатов. Сохраняйте простые захваты на исходном HTML, тексте или Markdown. Добавляйте рендеринг только там, где это улучшает полноту. Используйте кредиты по мере необходимости, пока цели и объем все еще неопределенны, затем переместите предсказуемые повторяющиеся рендеренные рабочие нагрузки на месячные кредиты, как только шаблон будет доказан. Страница цены и калькулятор стоимости кредитов помогут сопоставить вес запроса с реальным поведением цели.
Где рендеринг HTML вписывается в рабочий процесс ScraperFly?
Рендеринг HTML находится между базовым захватом HTML и полностью визуальным выводом. Начните с API захвата HTML, когда исходная разметка завершена. Перейдите к рендерингу HTML, когда JavaScript создает полезный DOM. Выбирайте текст или Markdown, когда последующий потребитель нуждается в читаемом контенте вместо селекторов. Добавляйте скриншоты или PDF, когда рабочий процесс требует доказательства внешнего вида.
Это позволяет командам сохранять первый запрос простым, делать эскалацию основанной на доказательствах и предоставлять парсерам необходимую разметку. Результат — меньше индивидуальной инфраструктуры браузера, меньше слепых повторных попыток и более чистый путь от тестирования цели к захвату в производстве.







