






Захоплення рендереного HTML
Захопіть DOM після завершення JavaScript на сторінці
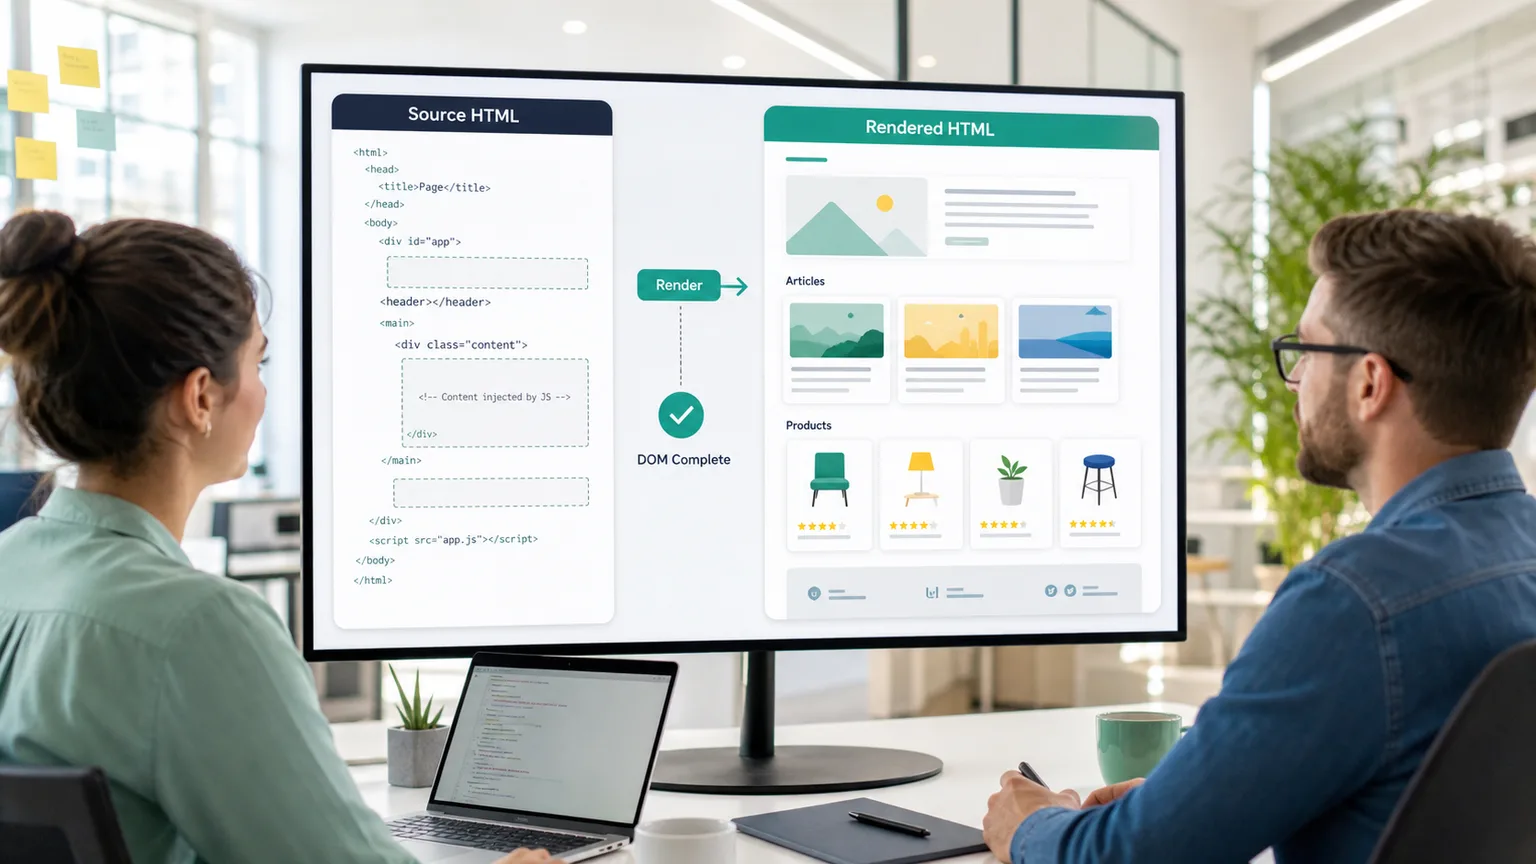
Деякі публічні сторінки повертають корисний контент у першій HTML-відповіді. Інші надсилають тонку оболонку і формують статтю, список продуктів, таблицю, маршрут або результати пошуку лише після виконання JavaScript на стороні браузера. Рендерений HTML призначений для другого випадку: коли парсеру потрібен фінальний DOM, а не просто вихідний розмітка.
ScraperFly дозволяє командам порівнювати сирий HTML з рендереним HTML, а потім активувати рендеринг лише для цілей, які доводять, що вони його потребують. Ви зберігаєте прості сторінки швидкими та доступними, при цьому маючи чистий шлях для оновлення публічного контенту, створеного за допомогою JavaScript.
Що таке API рендереного HTML?
API рендереного HTML отримує публічну сторінку, виконує JavaScript на стороні браузера, чекає, поки стан сторінки стабілізується, і повертає отриману HTML-розмітку. Замість того, щоб парсити оригінальну відповідь, ваш додаток отримує DOM після того, як фронтенд має можливість створити корисний контент.
Це відрізняється від скріншота або PDF. Скріншот підтверджує, як виглядала сторінка. PDF надає портативний візуальний запис. Рендерений HTML зберігає сторінку як розмітку, тому парсери все ще можуть перевіряти заголовки, посилання, таблиці, атрибути, картки продуктів, тіла статей, пагінацію, вбудовані дані та повторювані шаблони DOM.
Практичний висновок: використовуйте рендерений HTML, коли JavaScript змінює розмітку, яку потребує ваш парсер, а не коли проста вихідна запит вже повертає повний контент.
Коли слід використовувати рендерений HTML замість сирого HTML?
Рішення має базуватися на доказах. Почніть з сирого HTML, перевірте, що повертається, і порівняйте це з рендереним захопленням. Якщо вихідна відповідь вже містить корисне тіло статті, таблицю, дані продукту, посилання або метадані, зберігайте запит легким. Якщо вихідна відповідь не містить контенту, містить порожні контейнери маршрутів або лише відкриває заповнювачі, рендерений HTML є кращим варіантом.
| Цільова поведінка | Що показує сирий HTML | Кращий запит |
|---|---|---|
| Статична публічна сторінка | Повний текст, посилання та метадані з'являються у першій відповіді. | Використовуйте сирий HTML, текст або Markdown без рендерингу браузера. |
| Сторінка, що рендериться клієнтом | Відповідь містить оболонку програми, контейнер маршруту або порожню область контенту. | Використовуйте рендерений HTML, щоб парсер бачив завершений DOM. |
| Затриманий контент | Важливі картки або таблиці з'являються лише після завершення асинхронних запитів. | Використовуйте рендеринг з виміряним очікуванням, а не сліпими повторними спробами. |
| Потрібно підтвердження макета | Парсеру потрібна розмітка, але рецензенти також потребують візуальних доказів. | Використовуйте рендерений HTML для парсингу, а скріншоти або PDF лише для вибраних доказів. |
| Регіональний або станний контент | Видимий результат змінюється залежно від мови, місця, куків або попереднього стану. | Перевірте заголовки, маршрути країни або сесії перед тим, як зробити рендеринг за замовчуванням. |
Що можуть витягувати команди з рендереного HTML?
Рендерений HTML все ще є HTML. Це робить його корисним, коли подальший код потребує селекторів, атрибутів, структурних відносин, канонічних посилань, пагінації, карток продуктів, завантажених коментарів, гідратованих тіл статей або будь-якої секції сторінки, яка з'являється після виконання фронтенду. Це дає вашому парсеру фінальну розмітку без необхідності змушувати людину читати скріншот.
API не усуває необхідність у правилах, специфічних для цілей. Ваш додаток все ще вирішує, які поля важливі, як перевіряються записи, як обробляються дублікати та куди йдуть витягнуті дані. ScraperFly обробляє захоплення: виконання браузера, параметри запиту, формати відповідей, метадані та контролі доставки.
| Потреба парсера | Рендерений HTML допомагає, тому що | Корисний супутній вихід |
|---|---|---|
| Картки продуктів або списків | Фінальний DOM містить повторювані елементи, які можуть не бути включені у вихідну відповідь. | JSON-метадані для статусу та фінальної URL. |
| Захоплення тіла статті | Гідратований контент може бути проаналізований як розмітка після виконання браузера. | Текст або Markdown для зручного перегляду. |
| Сторінки пошуку або категорій | Рендерені секції відкривають посилання, фільтри, пагінацію та видиме упорядкування. | Скріншот для періодичного підтвердження якості. |
| Моніторинг робочих процесів | Парсер може порівнювати завершену розмітку замість порожніх оболонок. | Метадані та розмір відповіді для діагностики змін. |
| AI або RAG поглинання | Рендерений HTML може бути перетворений на чистіший текст або Markdown після появи динамічного контенту. | Markdown для контексту, готового до моделі. |
Для ширших рішень щодо форматів порівняйте формати відповідей API веб-скрапінгу. Якщо ваш робочий процес потребує повного шляху виконання браузера, перегляньте також сторінку API рендерингу JavaScript.
Як команди повинні тестувати рендерений HTML перед виробництвом?
Виберіть кілька репрезентативних публічних URL-адрес і протестуйте їх у API Builder. Порівняйте сирий вихідний HTML, рендерений HTML, розмір відповіді, фінальну URL, тип контенту та час очікування. Мета не в тому, щоб увімкнути рендеринг скрізь. Мета полягає в тому, щоб визначити, які цільові групи потребують цього, а які можуть залишитися на дешевшому, швидшому профілі запиту.
Коли рендерений запит порожній, не переписуйте парсер відразу. Спочатку перевірте, чи перенаправилася сторінка, повернула стан згоди або блокування, потребувала довшого очікування, змінилася за країною або мовою, або повернула відповідь, яка занадто велика для запланованого захоплення. Хороша налагодження розділяє проблеми захоплення від проблем парсера.
Практичний висновок: рендерений HTML повинен бути перевірений на реальних цільових сторінках, перш ніж він стане частиною повторюваного робочого процесу.
Як рендерений HTML впливає на вартість і надійність?
Робота браузера є важчою, ніж просте отримання. Саме тому ScraperFly розглядає рендеринг як контроль запиту. Проста публічна сторінка не повинна платити таку ж експлуатаційну вартість, як сторінка з великою кількістю JavaScript, яка потребує виконання браузера, очікувань, скріншотів, файлів, маршрутизації по країні або преміум-доставки.
Використовуйте безкоштовні кредити для тестування сирих і рендерених результатів. Зберігайте прості захоплення на вихідному HTML, тексті або Markdown. Додавайте рендеринг лише там, де це покращує повноту. Використовуйте кредити за фактом, поки цілі та обсяги ще невизначені, а потім перемістіть передбачувані повторювані рендерингові навантаження на місячні кредити, як тільки шаблон буде доведено. Сторінка цін та калькулятор вартості кредитів допомагають зіставити вагу запиту з реальною поведінкою цілей.
Де рендерений HTML вписується в робочий процес ScraperFly?
Рендерений HTML знаходиться між базовим захопленням HTML і повністю візуальним виходом. Почніть з API скрапінгу HTML, коли вихідна розмітка завершена. Перейдіть до рендереного HTML, коли JavaScript створює корисний DOM. Виберіть текст або Markdown, коли подальший споживач потребує читабельного контенту замість селекторів. Додайте скріншоти або PDF, коли робочий процес потребує підтвердження зовнішнього вигляду.
Це дозволяє командам зберігати перший запит простим, робити ескалацію на основі доказів і надавати парсерам розмітку, яку вони насправді потребують. Результат - менше спеціальної інфраструктури браузера, менше сліпих повторних спроб і чистіший шлях від тестування цілей до захоплення в виробництві.







