






Captura de HTML renderizado
Captura el DOM después de que JavaScript termina la página
Algunas páginas públicas devuelven contenido útil en la primera respuesta HTML. Otras envían una estructura delgada y construyen el artículo, lista de productos, tabla, ruta o resultado de búsqueda solo después de que se ejecuta JavaScript del lado del navegador. El HTML renderizado es para ese segundo caso: cuando el analizador necesita el DOM final, no solo la marca de origen.
ScraperFly permite a los equipos comparar HTML en bruto con HTML renderizado por el navegador, y luego habilitar la renderización solo para los objetivos que demuestran que la necesitan. Mantienes las páginas simples rápidas y asequibles, mientras aún tienes un camino de actualización limpio para el contenido público construido con JavaScript.
¿Qué es una API de HTML renderizado?
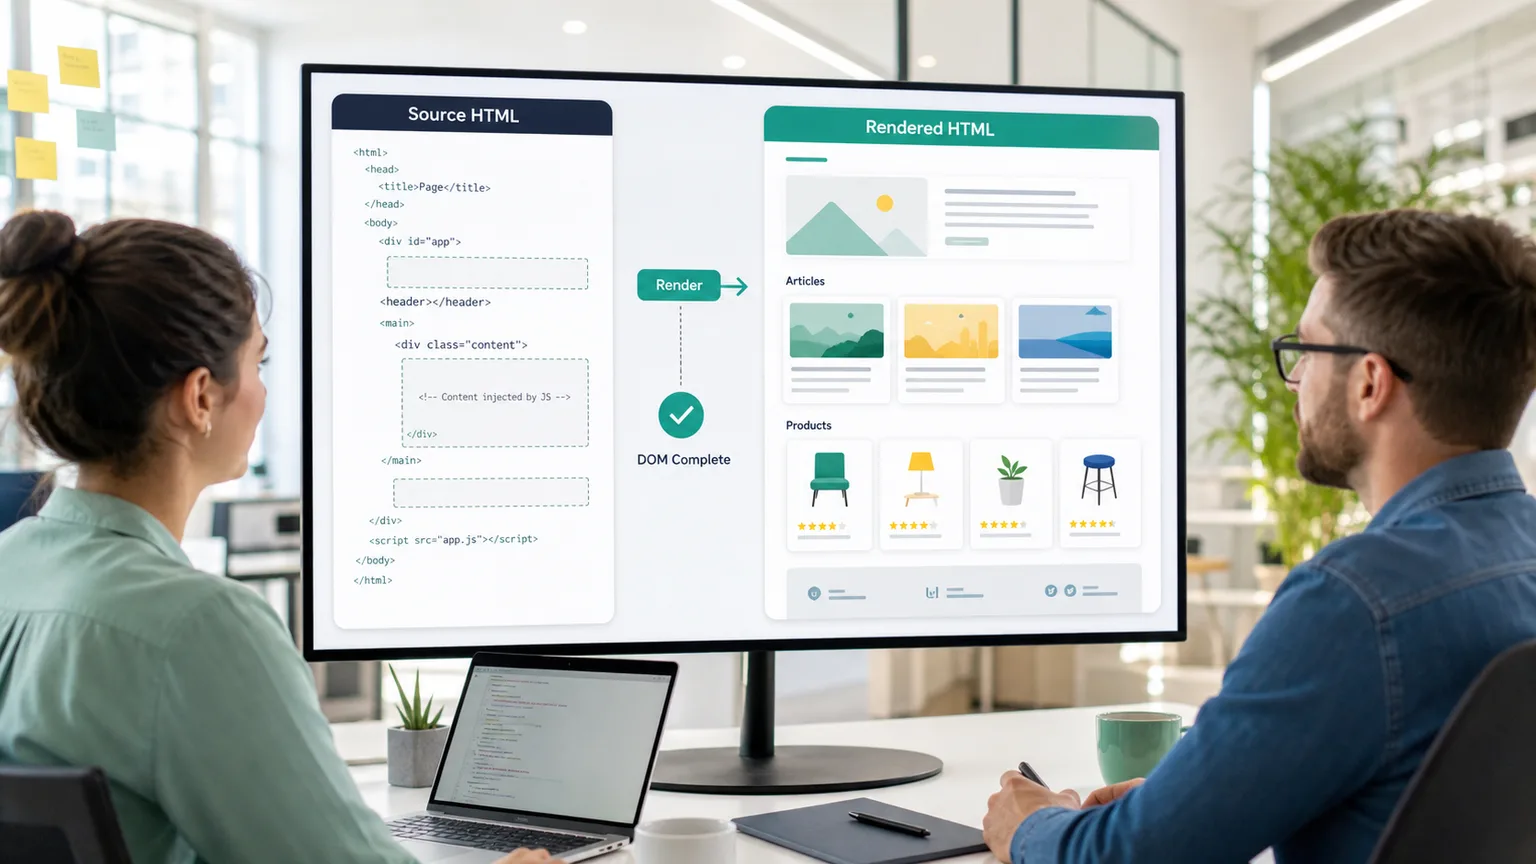
Una API de HTML renderizado obtiene una página pública, ejecuta JavaScript del lado del navegador, espera a que el estado de la página se estabilice y devuelve la marca HTML resultante. En lugar de analizar la respuesta de origen original, tu aplicación recibe el DOM después de que el frontend ha tenido la oportunidad de crear el contenido útil.
Esto es diferente de una captura de pantalla o un PDF. Una captura de pantalla prueba cómo se veía la página. Un PDF proporciona un registro visual portátil. El HTML renderizado mantiene la página como marca, por lo que los analizadores aún pueden inspeccionar encabezados, enlaces, tablas, atributos, tarjetas de productos, cuerpos de artículos, paginación, datos incrustados y patrones de DOM repetidos.
Conclusión práctica: usa HTML renderizado cuando JavaScript cambie la marca que tu analizador necesita, no cuando una simple solicitud de origen ya devuelva contenido completo.
¿Cuándo debería una página usar HTML renderizado en lugar de HTML en bruto?
La decisión debe basarse en evidencia. Comienza con HTML en bruto, inspecciona lo que regresa y compáralo con una captura renderizada. Si la respuesta de origen ya contiene el cuerpo del artículo útil, tabla, datos de productos, enlaces o metadatos, mantén la solicitud ligera. Si la respuesta de origen carece de contenido, contiene contenedores de ruta vacíos o solo expone marcadores de posición, HTML renderizado es la mejor entrada.
| Comportamiento objetivo | Lo que muestra HTML en bruto | Mejor solicitud |
|---|---|---|
| Página pública estática | Texto completo, enlaces y metadatos aparecen en la primera respuesta. | Usa HTML en bruto, texto o Markdown sin renderización del navegador. |
| Página renderizada por el cliente | La respuesta contiene una estructura de aplicación, contenedor de ruta o área de contenido vacía. | Usa HTML renderizado para que el analizador vea el DOM completado. |
| Contenido retrasado | Tarjetas o tablas importantes aparecen solo después de que finalizan las solicitudes asíncronas. | Usa renderización con una espera medida en lugar de reintentos ciegos. |
| Prueba de diseño necesaria | El analizador necesita marca, pero los revisores también necesitan evidencia visual. | Usa HTML renderizado para análisis y capturas de pantalla o PDFs solo para registros de prueba seleccionados. |
| Contenido regional o con estado | El resultado visible cambia por idioma, ubicación, cookies o estado previo. | Prueba encabezados, enrutamiento por país o sesiones antes de hacer que la renderización sea la predeterminada. |
¿Qué pueden extraer los equipos del HTML renderizado?
El HTML renderizado sigue siendo HTML. Eso lo hace útil cuando el código posterior necesita selectores, atributos, relaciones estructurales, enlaces canónicos, paginación, tarjetas de productos, comentarios cargados, cuerpos de artículos hidratados o cualquier sección de la página que aparece después de la ejecución del frontend. Le da a tu analizador la marca final sin forzar a un humano a leer una captura de pantalla.
La API no elimina la necesidad de reglas específicas para el objetivo. Tu aplicación aún decide qué campos importan, cómo se validan los registros, cómo se manejan los duplicados y a dónde va la data extraída. ScraperFly maneja el lado de la captura: ejecución del navegador, opciones de solicitud, formatos de respuesta, metadatos y controles de entrega.
| Necesidad del analizador | HTML renderizado ayuda porque | Salida complementaria útil |
|---|---|---|
| Tarjetas de productos o listados | El DOM final contiene elementos repetidos que la respuesta de origen puede no incluir. | Metadatos JSON para estado y URL final. |
| Captura del cuerpo del artículo | El contenido hidratado puede ser analizado como marca después de que el navegador se ejecute. | Texto o Markdown para revisión legible. |
| Páginas de búsqueda o categoría | Secciones renderizadas exponen enlaces, filtros, paginación y orden visible. | Captura de pantalla para prueba ocasional de QA. |
| Flujos de trabajo de monitoreo | El analizador puede comparar la marca completada en lugar de estructuras vacías. | Metadatos y tamaño de respuesta para diagnósticos de cambios. |
| Ingesta de IA o RAG | HTML renderizado puede ser convertido en texto más limpio o Markdown después de que aparezca contenido dinámico. | Markdown para contexto listo para el modelo. |
Para decisiones de formato más amplias, compara los formatos de respuesta de la API de web scraping. Si tu flujo de trabajo necesita el camino completo de ejecución del navegador, revisa la página de API de renderización de JavaScript también.
¿Cómo deberían los equipos probar HTML renderizado antes de la producción?
Elige algunas URL públicas representativas y pruébalas en el API Builder. Compara HTML fuente en bruto, HTML renderizado, tamaño de respuesta, URL final, tipo de contenido y tiempo de espera. El objetivo no es activar la renderización en todas partes. El objetivo es identificar qué grupos objetivo la necesitan y cuáles pueden permanecer en un perfil de solicitud más barato y rápido.
Cuando una solicitud renderizada está vacía, no reescribas inmediatamente el analizador. Primero verifica si la página redirigió, devolvió un estado de consentimiento o bloqueado, necesitó una espera más larga, cambió por país o idioma, o devolvió una respuesta que es demasiado grande para la captura prevista. Un buen depurado separa los problemas de captura de los problemas del analizador.
Conclusión práctica: el HTML renderizado debe ser validado contra páginas objetivo reales antes de que se convierta en parte de un flujo de trabajo recurrente.
¿Cómo afecta el HTML renderizado al costo y la confiabilidad?
El trabajo del navegador es más pesado que una obtención básica. Esa es exactamente la razón por la que ScraperFly trata la renderización como un control de solicitud deliberado. Una página pública simple no debería pagar el mismo costo operativo que una página pesada en JavaScript que necesita ejecución del navegador, esperas, capturas de pantalla, archivos, enrutamiento por país o entrega premium.
Usa créditos gratuitos para probar resultados en bruto y renderizados. Mantén las capturas simples en HTML fuente, texto o Markdown. Agrega renderización solo donde mejore la completitud. Usa créditos de pago por uso mientras los objetivos y el volumen aún son inciertos, luego mueve cargas de trabajo renderizadas recurrentes predecibles a créditos mensuales una vez que el patrón esté probado. La página de precios y el calculador de costo de créditos ayudan a mapear el peso de la solicitud al comportamiento real del objetivo.
¿Dónde encaja el HTML renderizado en el flujo de trabajo de ScraperFly?
El HTML renderizado se sitúa entre la captura básica de HTML y la salida completamente visual. Comienza con la API de scraping de HTML cuando la marca de origen está completa. Pasa a HTML renderizado cuando JavaScript crea el DOM útil. Elige texto o Markdown cuando el consumidor posterior necesita contenido legible en lugar de selectores. Agrega capturas de pantalla o PDFs cuando el flujo de trabajo necesita prueba de apariencia.
Esto permite a los equipos mantener la primera solicitud simple, hacer que la escalación se base en evidencia y dar a los analizadores la marca que realmente necesitan. El resultado es menos infraestructura de navegador personalizada, menos reintentos ciegos y un camino más limpio desde la prueba del objetivo hasta la captura de producción.







