






Evidência do produto
Capture páginas de produtos com preço, disponibilidade, alegações e contexto de origem intactos
A pesquisa de produtos depende de evidências públicas espalhadas por páginas de produtos, listagens de marketplaces, páginas de categorias, avaliações, páginas de preços, documentação, changelogs e páginas de lançamento. O ScraperFly ajuda as equipes a capturar essas fontes em formatos práticos antes de investirem em normalização, enriquecimento ou monitoramento recorrente.
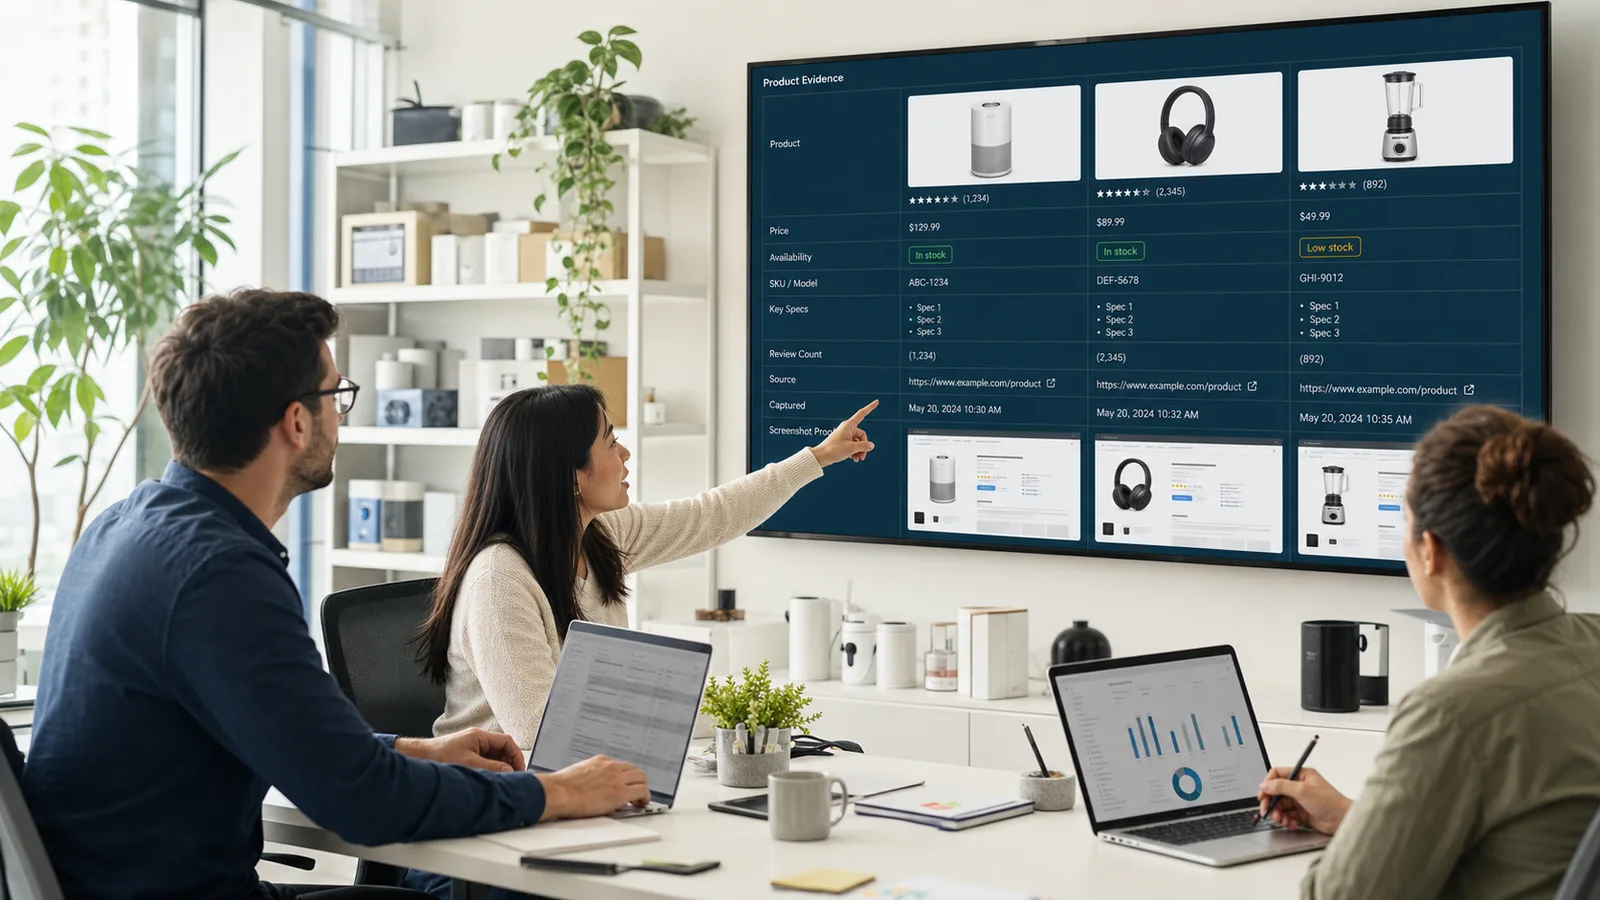
O valor não está apenas em buscar uma URL. Um registro de produto útil deve explicar de onde veio, quando foi capturado, qual variante ou estado do vendedor estava visível, qual formato de resposta foi utilizado e se a renderização ou prova visual alterou o resultado. Esse contexto mantém o trabalho de pesquisa fundamentado quando fontes, categorias e cadência ainda estão mudando.
O que é web scraping para pesquisa de produtos?
Web scraping para pesquisa de produtos significa capturar páginas públicas relacionadas a produtos para que as equipes possam estudar mercados, categorias, concorrentes, sortimento, preços, alegações de produtos, avaliações, disponibilidade e estrutura de catálogo. As fontes podem incluir páginas de detalhes de produtos, listagens de marketplaces, páginas de categorias, páginas de marcas, páginas de lojas, páginas de avaliações, documentação de produtos, páginas de comparação e anúncios de lançamento.
O ScraperFly se encaixa como a camada de captura. Ele recupera a página pública e retorna HTML, HTML renderizado, texto, Markdown, metadados, capturas de tela ou PDFs, dependendo do que o fluxo de trabalho precisa. O sistema de produtos a jusante pode então extrair campos, normalizar atributos, mesclar registros duplicados, mapear categorias, pontuar oportunidades de produtos ou encaminhar amostras para revisão.
Essa separação é importante. O ScraperFly não finge que cada fonte de produto tem o mesmo esquema ou que cada página se torna um catálogo limpo automaticamente. Ele fornece às equipes captura de fonte confiável e evidência de resposta para que a pesquisa de produtos possa começar com o comportamento real da página em vez de suposições frágeis.
Conclusão prática: use scraping de produtos para preservar a evidência da fonte pública primeiro, depois normalize e compare registros no sistema que entende seu modelo de produto.
Quais fontes de produtos valem a pena capturar?
Os melhores fluxos de trabalho de pesquisa de produtos começam com um mapa de fontes. Páginas de detalhes de produtos revelam título, marca, SKU, variante, preço, disponibilidade, imagens, descrição, especificações, classificações e contexto do vendedor. Páginas de categorias revelam sortimento, posicionamento, classificação, filtros e paginação. Listagens de marketplaces revelam vendedores, estado do estoque, ofertas concorrentes, dicas de envio e linguagem promocional. Páginas de avaliações podem adicionar contexto de reputação pública, enquanto documentação e changelogs podem expor capacidades do produto e movimentação de lançamentos.
Não escale cada fonte de uma vez. Teste um pequeno grupo de páginas representativas de produtos, categorias e marketplaces. Compare o HTML da fonte com a saída renderizada. Verifique se os campos aparecem de forma consistente. Verifique se preço e disponibilidade variam por região, vendedor, estado de cookies ou seleção de variantes. Em seguida, transforme apenas os tipos de fonte comprovados em captura recorrente.
| Tipo de fonte | Evidência útil | Risco comum | Melhor escolha de captura |
|---|---|---|---|
| Páginas de detalhes de produtos | Título, marca, SKU, preço, imagens, especificações, disponibilidade | Variantes, JavaScript, ofertas regionais, mudanças de vendedor | HTML ou HTML renderizado com metadados |
| Páginas de categorias | Sortimento, filtros, classificação, paginação, cartões de produtos | Classificação dinâmica, colocações patrocinadas, produtos duplicados | HTML, Markdown, amostras de captura de tela |
| Listagens de marketplaces | Vendedor, preço, estado do estoque, dicas de envio, contexto da oferta | Personalização, disponibilidade regional, comportamento anti-bot | Captura renderizada, evidência de roteamento, amostras de prova |
| Páginas de avaliações | Classificação, contagem de avaliações, trechos públicos, temas | Paginamento, prompts de login, contagens que mudam frequentemente | Texto, Markdown, metadados, capturas de tela selecionadas |
| Documentos e páginas de lançamento | Alegações de recursos, notas de lançamento, especificações, linguagem de posicionamento | Ruído de template, seções dinâmicas, caminhos de documentos alterados | Markdown ou texto com metadados da fonte |
Quais campos de produto as equipes devem definir primeiro?
Um esquema de pesquisa de produtos deve ser específico o suficiente para apoiar uma decisão. Campos comuns incluem título do produto, marca, SKU ou modelo, categoria, variante, vendedor, preço, moeda, desconto, estado do estoque, URL da imagem, descrição, especificações, classificação, contagem de avaliações, URL da fonte, URL final, timestamp, status da resposta e formato de saída. Para registros sensíveis, uma captura de tela pode preservar a prova visível do estado do produto.
O esquema exato depende do trabalho. A pesquisa de sortimento pode se preocupar com categoria, marca e família de produtos. Verificações de preços precisam de moeda, vendedor, variante e contexto de promoção. O enriquecimento de catálogo pode precisar de especificações e imagens. A descoberta de produtos pode precisar de descrições, alegações, avaliações e texto de comparação. O monitoramento precisa de timestamps e contexto de fonte suficiente para explicar por que um campo mudou.
| Grupo de campo | Exemplos | Por que isso importa | Nota de captura |
|---|---|---|---|
| Identidade | Título, marca, SKU, modelo, categoria, URL da fonte | Ajuda a combinar registros de produtos entre fontes. | Mantenha a URL final e o timestamp para rastreabilidade. |
| Estado comercial | Preço, moeda, desconto, estoque, vendedor, dica de envio | Suporta verificações de preços e comparação de ofertas. | Preserve o contexto de variante e regional. |
| Detalhe do produto | Descrição, especificações, imagens, compatibilidade, alegações de recursos | Suporta enriquecimento de catálogo e descoberta de produtos. | Use HTML para campos estruturados ou Markdown para revisão. |
| Reputação | Classificação, contagem de avaliações, trechos públicos | Adiciona contexto de mercado sem substituir a análise. | Mantenha a evidência da fonte e evite tratar trechos como sentimento completo. |
| Prova | Captura de tela, PDF, metadados de resposta, configurações de captura | Torna amostras de alto valor mais fáceis de auditar. | Use para QA e registros importantes alterados. |
Quando as páginas de produtos precisam de renderização ou entrega mais forte?
Muitas páginas de produtos incluem campos úteis no HTML da fonte. Essas páginas podem permanecer leves. Outras páginas constroem preço, estado do estoque, variantes, avaliações, galerias de imagens, recomendações ou cartões de produtos após a execução do JavaScript. A renderização é útil quando altera a evidência que o fluxo de trabalho de produtos precisa. O tempo de espera é útil quando o conteúdo aparece tarde. Entrega mais forte ou roteamento regional é útil quando a página retorna conteúdo incompleto, bloqueado ou específico do mercado.
O melhor caminho é baseado em evidências. Capture o HTML da fonte primeiro, compare a saída renderizada em amostras representativas, inspecione a URL final e o tamanho da resposta, e então decida se renderização, esperas, cabeçalhos, sessões, direcionamento de país ou roteamento premium devem fazer parte desse perfil de fonte. A API de renderização JavaScript, direcionamento de país e formatos de resposta ajudam as equipes a tomar essas decisões de forma deliberada.
Conclusão prática: mantenha fontes de produtos simples leves e reserve controles mais pesados para páginas onde amostras provem que melhoram a qualidade do campo.
Como as equipes devem lidar com a qualidade dos dados do produto?
Os dados do produto ficam bagunçados rapidamente. O mesmo produto pode aparecer sob diferentes nomes, vendedores, moedas, categorias ou variantes. Uma listagem pode mostrar um desconto em uma região e o preço cheio em outra. Contagens de avaliações mudam. Imagens rotacionam. Especificações de produtos podem estar ocultas atrás de abas. Uma página de categoria pode incluir produtos patrocinados ou personalização. A camada de captura deve preservar evidências suficientes para que o sistema a jusante normalize essas diferenças.
O ScraperFly ajuda tornando a captura de fonte repetível e inspecionável. Preserve a URL da fonte, URL final, status, tipo de conteúdo, tamanho da resposta, timestamp, formato de saída e artefatos de prova quando necessário. Em seguida, use seu modelo de produto para deduplicar, mapear categorias, limpar atributos, mesclar ofertas de vendedores e decidir quais campos são confiáveis o suficiente para análise ou automação.
Como a pesquisa de produtos scraping pode permanecer acessível?
A pesquisa de produtos geralmente começa de forma exploratória: uma categoria, um concorrente, um marketplace, algumas famílias de produtos, um punhado de regiões. Não deve exigir uma grande assinatura fixa antes que a qualidade da fonte seja comprovada. Comece com créditos gratuitos, teste páginas representativas, compre créditos pay-as-you-go para pesquisa desigual e mova a coleta recorrente para créditos mensais apenas quando a cadência da fonte e o perfil de solicitação estiverem claros.
Peso de solicitação também importa. HTML, texto e Markdown podem cobrir muitas páginas de pesquisa. Renderização, esperas, capturas de tela, roteamento de país, sessões e entrega premium pertencem a fontes onde melhoram a evidência capturada. O calculador de custo de crédito e a página de preços ajudam a estimar o impacto antes de expandir categorias ou marketplaces.
Por que usar o ScraperFly para pesquisa de produtos?
O ScraperFly fornece às equipes de produto, crescimento, dados e pesquisa uma camada de API para captura de fontes públicas de produtos. Ele pode retornar HTML bruto para extração, HTML renderizado quando o JavaScript é importante, texto ou Markdown para revisão, metadados para registro e capturas de tela ou PDFs para prova visual. Ele também mantém os controles de entrega explícitos, para que as equipes possam escolher sessões, cabeçalhos, direcionamento de país, esperas ou roteamento premium apenas quando a evidência apoiar a solicitação mais pesada.
Isso torna a pesquisa de produtos mais fácil de começar e mais segura para escalar. As equipes podem testar fontes de forma econômica, preservar o contexto da fonte, comparar formatos de resposta e transformar páginas comprovadas em fluxos de trabalho recorrentes sem construir primeiro uma infraestrutura frágil de captura, renderização, proxy, captura de tela e limpeza.











































