






Evidencia del producto
Captura páginas de productos con precio, disponibilidad, afirmaciones y contexto de origen intactos
La investigación de productos depende de la evidencia pública dispersa en páginas de productos, listados de mercado, páginas de categorías, reseñas, páginas de precios, documentación, registros de cambios y páginas de lanzamiento. ScraperFly ayuda a los equipos a capturar esas fuentes en formatos prácticos antes de invertir en normalización, enriquecimiento o monitoreo recurrente.
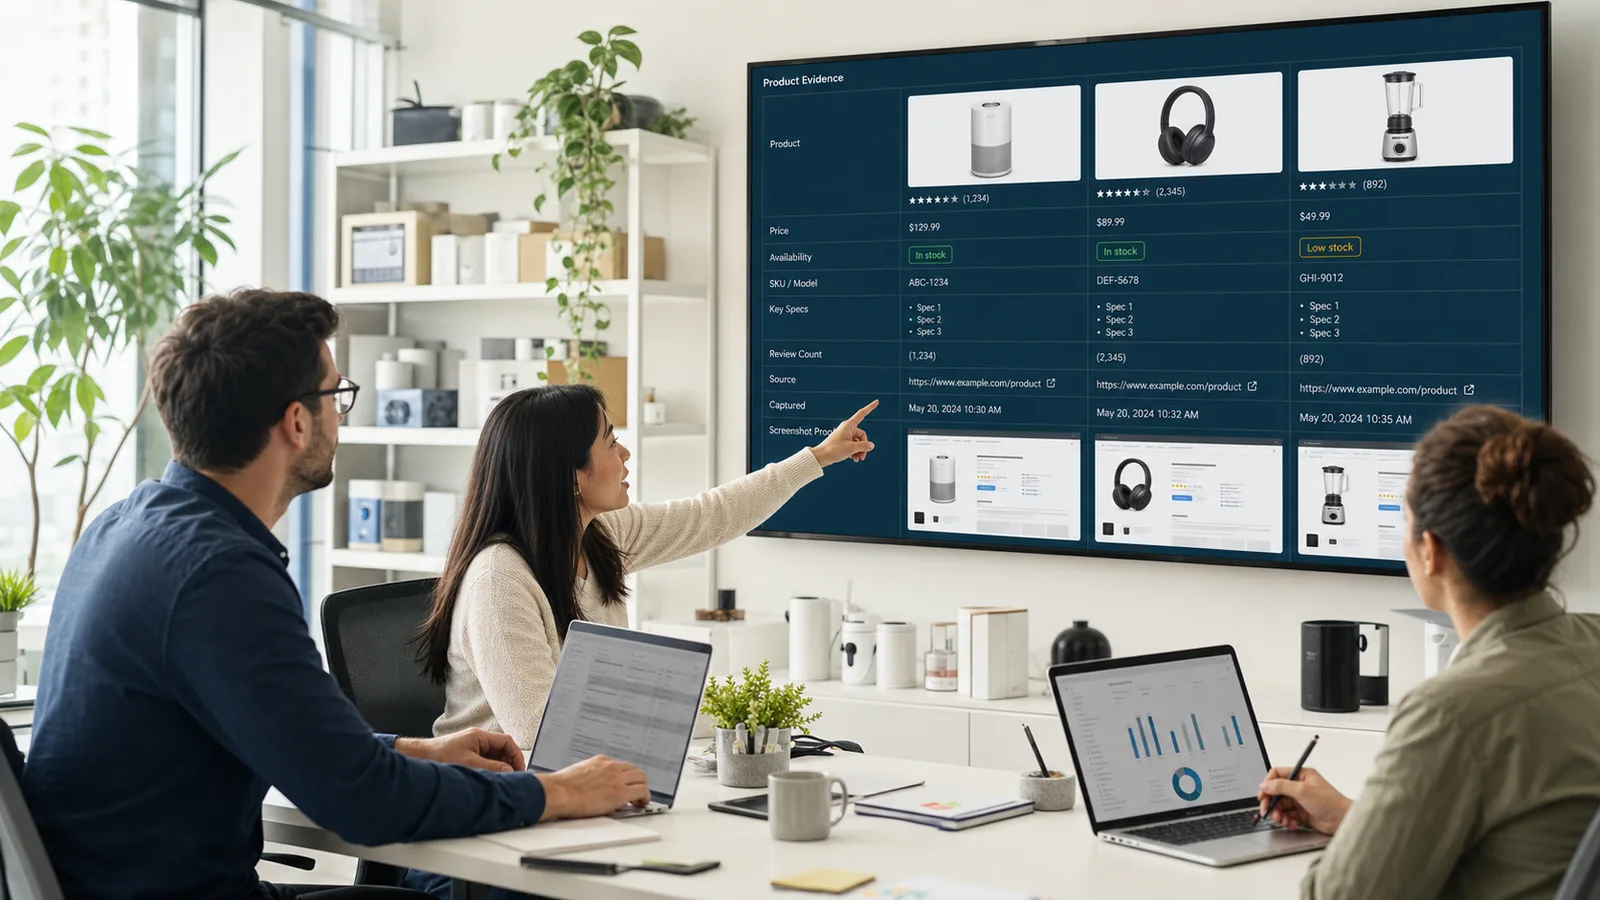
El valor no está solo en obtener una URL. Un registro de producto útil debe explicar de dónde proviene, cuándo fue capturado, qué variante o estado de vendedor era visible, qué formato de respuesta se utilizó y si la representación o la prueba visual cambiaron el resultado. Ese contexto mantiene el trabajo de investigación fundamentado cuando las fuentes, categorías y cadencias aún están cambiando.
¿Qué es el web scraping para la investigación de productos?
El web scraping para la investigación de productos significa capturar páginas públicas relacionadas con productos para que los equipos puedan estudiar mercados, categorías, competidores, surtidos, precios, afirmaciones de productos, reseñas, disponibilidad y estructura de catálogo. Las fuentes pueden incluir páginas de detalles de productos, listados de mercado, páginas de categorías, páginas de marcas, páginas de tiendas, páginas de reseñas, documentación de productos, páginas de comparación y anuncios de lanzamiento.
ScraperFly se adapta como la capa de captura. Recupera la página pública y devuelve HTML, HTML renderizado, texto, Markdown, metadatos, capturas de pantalla o PDFs dependiendo de lo que necesite el flujo de trabajo. El sistema de productos aguas abajo puede luego extraer campos, normalizar atributos, fusionar registros duplicados, mapear categorías, puntuar oportunidades de productos o dirigir muestras para revisión.
Esta separación es importante. ScraperFly no pretende que cada fuente de producto tenga el mismo esquema o que cada página se convierta automáticamente en un catálogo limpio. Proporciona a los equipos una captura de fuente confiable y evidencia de respuesta para que la investigación de productos pueda comenzar con el comportamiento real de la página en lugar de suposiciones frágiles.
Conclusión práctica: utiliza el scraping de productos para preservar primero la evidencia de fuentes públicas, luego normaliza y compara registros en el sistema que entiende tu modelo de producto.
¿Qué fuentes de productos valen la pena capturar?
Los mejores flujos de trabajo de investigación de productos comienzan con un mapa de fuentes. Las páginas de detalles de productos revelan título, marca, SKU, variante, precio, disponibilidad, imágenes, descripción, especificaciones, calificaciones y contexto del vendedor. Las páginas de categorías revelan surtido, posicionamiento, clasificación, filtros y paginación. Los listados de mercado revelan vendedores, estado de stock, ofertas competidoras, pistas de envío y lenguaje de promoción. Las páginas de reseñas pueden agregar contexto de reputación pública, mientras que la documentación y los registros de cambios pueden exponer capacidades del producto y movimientos de lanzamiento.
No escales cada fuente a la vez. Prueba un pequeño grupo de páginas representativas de productos, categorías y mercados. Compara el HTML de la fuente con la salida renderizada. Verifica si los campos aparecen de manera consistente. Verifica si el precio y la disponibilidad varían según la región, vendedor, estado de cookies o selección de variante. Luego convierte solo los tipos de fuente probados en captura recurrente.
| Tipo de fuente | Evidencia útil | Riesgo común | Mejor opción de captura |
|---|---|---|---|
| Páginas de detalles de productos | Título, marca, SKU, precio, imágenes, especificaciones, disponibilidad | Variantes, JavaScript, ofertas regionales, cambios de vendedor | HTML o HTML renderizado con metadatos |
| Páginas de categorías | Surtido, filtros, clasificación, paginación, tarjetas de productos | Ordenamiento dinámico, ubicaciones patrocinadas, productos duplicados | HTML, Markdown, muestras de captura de pantalla |
| Listados de mercado | Vendedor, precio, estado de stock, pistas de envío, contexto de oferta | Personalización, disponibilidad regional, comportamiento anti-bot | Captura renderizada, evidencia de enrutamiento, muestras de prueba |
| Páginas de reseñas | Calificación, conteo de reseñas, fragmentos públicos, temas | Paginación, solicitudes de inicio de sesión, conteos que cambian frecuentemente | Texto, Markdown, metadatos, capturas de pantalla seleccionadas |
| Documentos y páginas de lanzamiento | Afirmaciones de características, notas de lanzamiento, especificaciones, lenguaje de posicionamiento | Ruido de plantilla, secciones dinámicas, rutas de documentos cambiadas | Markdown o texto con metadatos de fuente |
¿Qué campos de producto deben definir primero los equipos?
Un esquema de investigación de productos debe ser lo suficientemente específico como para apoyar una decisión. Los campos comunes incluyen título del producto, marca, SKU o modelo, categoría, variante, vendedor, precio, moneda, descuento, estado de stock, URL de imagen, descripción, especificaciones, calificación, conteo de reseñas, URL de fuente, URL final, marca de tiempo, estado de respuesta y formato de salida. Para registros sensibles, una captura de pantalla puede preservar la prueba visible del estado del producto.
El esquema exacto depende del trabajo. La investigación de surtido puede preocuparse por la categoría, la marca y la familia de productos. Las verificaciones de precios necesitan moneda, vendedor, variante y contexto de promoción. El enriquecimiento del catálogo puede necesitar especificaciones e imágenes. El descubrimiento de productos puede necesitar descripciones, afirmaciones, reseñas y texto de comparación. El monitoreo necesita marcas de tiempo y suficiente contexto de fuente para explicar por qué un campo cambió.
| Grupo de campos | Ejemplos | Por qué es importante | Nota de captura |
|---|---|---|---|
| Identidad | Título, marca, SKU, modelo, categoría, URL de fuente | Ayuda a hacer coincidir registros de productos entre fuentes. | Mantén la URL final y la marca de tiempo para trazabilidad. |
| Estado comercial | Precio, moneda, descuento, stock, vendedor, pista de envío | Soporta verificaciones de precios y comparación de ofertas. | Preserva el contexto de variante y regional. |
| Detalle del producto | Descripción, especificaciones, imágenes, compatibilidad, afirmaciones de características | Soporta el enriquecimiento del catálogo y el descubrimiento de productos. | Usa HTML para campos estructurados o Markdown para reseñas. |
| Reputación | Calificación, conteo de reseñas, fragmentos públicos | Agrega contexto de mercado sin reemplazar el análisis. | Mantén la evidencia de fuente y evita tratar fragmentos como sentimiento completo. |
| Prueba | Captura de pantalla, PDF, metadatos de respuesta, configuraciones de captura | Facilita la auditoría de muestras de alto valor. | Usa para QA y registros importantes cambiados. |
¿Cuándo necesitan las páginas de productos renderización o entrega más fuerte?
Muchas páginas de productos incluyen campos útiles en HTML de origen. Esas páginas pueden mantenerse ligeras. Otras páginas construyen precio, estado de stock, variantes, reseñas, galerías de imágenes, recomendaciones o tarjetas de productos después de que JavaScript se ejecute. La renderización es útil cuando cambia la evidencia que necesita el flujo de trabajo del producto. El tiempo de espera es útil cuando el contenido aparece tarde. Una entrega más fuerte o enrutamiento regional es útil cuando la página devuelve contenido incompleto, bloqueado o específico del mercado.
El mejor camino es basado en evidencia. Captura HTML de origen primero, compara la salida renderizada en muestras representativas, inspecciona la URL final y el tamaño de respuesta, luego decide si la renderización, esperas, encabezados, sesiones, orientación por país o enrutamiento premium deberían ser parte de ese perfil de fuente. La API de renderización de JavaScript, orientación por país, y formatos de respuesta ayudan a los equipos a tomar esas decisiones deliberadamente.
Conclusión práctica: mantén las fuentes de productos simples ligeras y reserva controles más pesados para páginas donde las muestras demuestren que mejoran la calidad del campo.
¿Cómo deben los equipos manejar la calidad de los datos de productos?
Los datos de productos se desordenan rápidamente. El mismo producto puede aparecer bajo diferentes nombres, vendedores, monedas, categorías o variantes. Un listado puede mostrar un descuento en una región y el precio completo en otra. Los conteos de reseñas cambian. Las imágenes rotan. Las especificaciones del producto pueden estar ocultas detrás de pestañas. Una página de categoría puede incluir productos patrocinados o personalización. La capa de captura debe preservar suficiente evidencia para que el sistema aguas abajo normalice esas diferencias.
ScraperFly ayuda al hacer que la captura de fuentes sea repetible e inspeccionable. Preserva la URL de fuente, la URL final, el estado, el tipo de contenido, el tamaño de respuesta, la marca de tiempo, el formato de salida y los artefactos de prueba cuando sea necesario. Luego usa tu modelo de producto para eliminar duplicados, mapear categorías, limpiar atributos, fusionar ofertas de vendedores y decidir qué campos son lo suficientemente confiables para análisis o automatización.
¿Cómo puede el scraping de investigación de productos mantenerse asequible?
La investigación de productos a menudo comienza de manera exploratoria: una categoría, un competidor, un mercado, algunas familias de productos, un puñado de regiones. No debería requerir una gran suscripción fija antes de que se pruebe la calidad de la fuente. Comienza con créditos gratuitos, prueba páginas representativas, compra créditos de pago por uso para investigación desigual y mueve la colección recurrente a créditos mensuales solo cuando la cadencia de la fuente y el perfil de solicitud estén claros.
El peso de la solicitud también importa. HTML, texto y Markdown pueden cubrir muchas páginas de investigación. La renderización, esperas, capturas de pantalla, enrutamiento por país, sesiones y entrega premium pertenecen a fuentes donde mejoran la evidencia capturada. La calculadora de costos de crédito y la página de precios ayudan a estimar el impacto antes de expandir categorías o mercados.
¿Por qué usar ScraperFly para la investigación de productos?
ScraperFly proporciona a los equipos de producto, crecimiento, datos e investigación una capa de API para la captura de fuentes públicas de productos. Puede devolver HTML en bruto para extracción, HTML renderizado cuando JavaScript es importante, texto o Markdown para revisión, metadatos para registro y capturas de pantalla o PDFs para prueba visual. También mantiene los controles de entrega explícitos, para que los equipos puedan elegir sesiones, encabezados, orientación por país, esperas o enrutamiento premium solo cuando la evidencia respalde la solicitud más pesada.
Eso hace que la investigación de productos sea más fácil de comenzar y más segura de escalar. Los equipos pueden probar fuentes de manera económica, preservar el contexto de la fuente, comparar formatos de respuesta y convertir páginas probadas en flujos de trabajo recurrentes sin construir primero una infraestructura frágil de captura, renderización, proxy, captura de pantalla y limpieza.











































