






ScraperFlyWebdaten-API für KI

use cases

Web Scraping für Produktforschung Quellennachweise

ScraperFly hilft Teams, öffentliche Produktseiten, Marktplatzangebote, Preise, Verfügbarkeiten, Bewertungen, Spezifikationen, Quell-URLs, Zeitstempel und Nachweisaufzeichnungen für die von ihnen kontrollierten Forschungsabläufe zu erfassen.

Produktbeweise

Produktseiten mit Preis, Verfügbarkeit, Ansprüchen und Kontext der Quelle intakt erfassen

Produktforschung hängt von öffentlichen Beweisen ab, die auf Produktseiten, Marktplatzangeboten, Kategorieseiten, Bewertungen, Preisseiten, Dokumentationen, Änderungsprotokollen und Launch-Seiten verstreut sind. ScraperFly hilft Teams, diese Quellen in praktischen Formaten zu erfassen, bevor sie in Normalisierung, Anreicherung oder wiederkehrende Überwachung investieren.

Der Wert besteht nicht nur darin, eine URL abzurufen. Ein nützlicher Produktdatensatz sollte erklären, woher er stammt, wann er erfasst wurde, welcher Variant oder Verkäuferstatus sichtbar war, welches Antwortformat verwendet wurde und ob das Rendering oder der visuelle Beweis das Ergebnis verändert hat. Dieser Kontext hält die Forschungsarbeit geerdet, wenn sich Quellen, Kategorien und Frequenz weiterhin ändern.
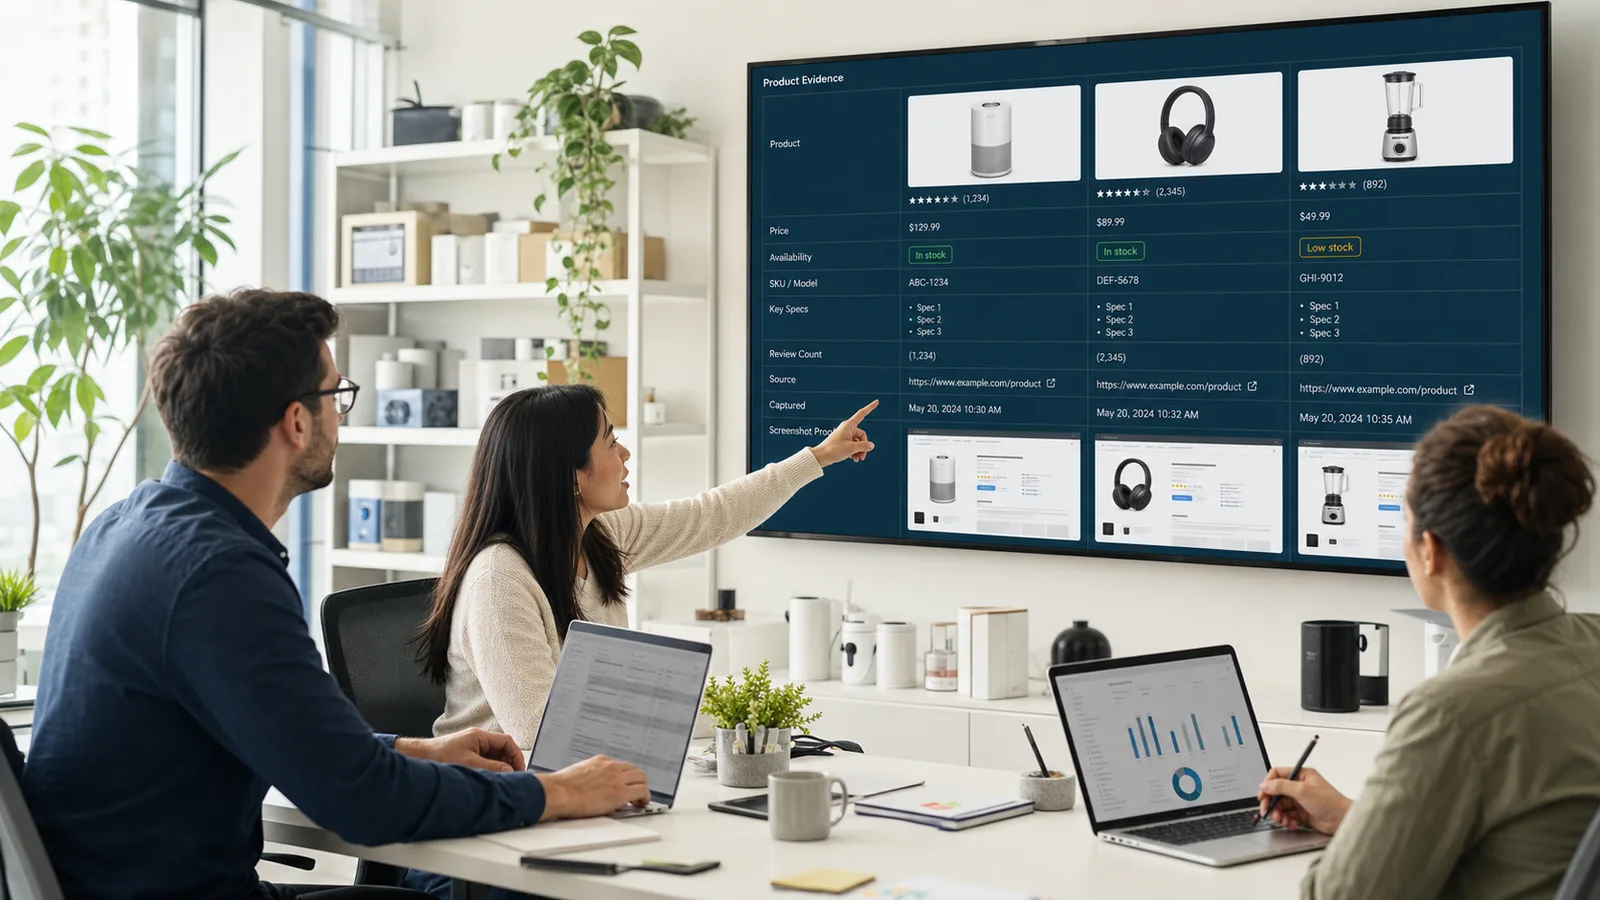
SKU-BeweisePreisstatusVerfügbarkeitVisueller Beweis
Produktforschungsteam überprüft öffentliche Produktseitenbeweise, Preise, Verfügbarkeit, SKU-Felder und Screenshot-Beweise

Was ist Web Scraping für Produktforschung?

Web Scraping für Produktforschung bedeutet, öffentliche produktbezogene Seiten zu erfassen, damit Teams Märkte, Kategorien, Wettbewerber, Sortimente, Preise, Produktansprüche, Bewertungen, Verfügbarkeit und Katalogstrukturen studieren können. Die Quellen können Produktdetailseiten, Marktplatzangebote, Kategorieseiten, Marken-Seiten, Shop-Seiten, Bewertungsseiten, Produktdokumentationen, Vergleichsseiten und Launch-Ankündigungen umfassen.

ScraperFly fungiert als Erfassungsschicht. Es ruft die öffentliche Seite ab und gibt HTML, gerendertes HTML, Text, Markdown, Metadaten, Screenshots oder PDFs zurück, je nachdem, was der Workflow benötigt. Das nachgelagerte Produktsystem kann dann Felder extrahieren, Attribute normalisieren, doppelte Datensätze zusammenführen, Kategorien zuordnen, Produktchancen bewerten oder Proben zur Überprüfung weiterleiten.

Diese Trennung ist wichtig. ScraperFly tut nicht so, als ob jede Produktquelle dasselbe Schema hat oder dass jede Seite automatisch zu einem sauberen Katalog wird. Es bietet Teams zuverlässige Quellenerfassung und Antwortbeweise, sodass die Produktforschung mit echtem Seitenverhalten beginnen kann, anstatt mit brüchigen Annahmen.

Praktische Erkenntnis: Verwenden Sie Produkt-Scraping, um zuerst öffentliche Quellenbeweise zu bewahren, und normalisieren und vergleichen Sie dann Datensätze in dem System, das Ihr Produktmodell versteht.

Welche Produktquellen sind es wert, erfasst zu werden?

Die besten Produktforschungs-Workflows beginnen mit einer Quellenkarte. Produktdetailseiten zeigen Titel, Marke, SKU, Variante, Preis, Verfügbarkeit, Bilder, Beschreibung, Spezifikationen, Bewertungen und Verkäuferkontext. Kategorieseiten zeigen Sortiment, Positionierung, Ranking, Filter und Paginierung. Marktplatzangebote zeigen Verkäufer, Lagerstatus, konkurrierende Angebote, Versandhinweise und Werbesprache. Bewertungsseiten können öffentlichen Rufkontext hinzufügen, während Dokumentationen und Änderungsprotokolle Produktfähigkeiten und Veröffentlichungsbewegungen offenlegen können.

Skalieren Sie nicht jede Quelle auf einmal. Testen Sie eine kleine Gruppe repräsentativer Produkt-, Kategorie- und Marktplatzseiten. Vergleichen Sie Quell-HTML mit gerendertem Output. Überprüfen Sie, ob Felder konsistent erscheinen. Verifizieren Sie, ob Preis und Verfügbarkeit je nach Region, Verkäufer, Cookie-Zustand oder Variantenauswahl variieren. Wandeln Sie dann nur die bewährten Quellentypen in wiederkehrende Erfassungen um.

Quellentyp Nützliche Beweise Häufiges Risiko Beste Erfassungswahl
Produktdetailseiten Titel, Marke, SKU, Preis, Bilder, Spezifikationen, Verfügbarkeit Varianten, JavaScript, regionale Angebote, Verkäuferänderungen HTML oder gerendertes HTML mit Metadaten
Kategorieseiten Sortiment, Filter, Ranking, Paginierung, Produktkarten Dynamische Sortierung, gesponserte Platzierungen, doppelte Produkte HTML, Markdown, Screenshot-Proben
Marktplatzangebote Verkäufer, Preis, Lagerstatus, Versandhinweise, Angebotskontext Personalisierung, regionale Verfügbarkeit, Anti-Bot-Verhalten Gerenderte Erfassung, Routing-Beweise, Beweisproben
Bewertungsseiten Bewertung, Anzahl der Bewertungen, öffentliche Snippets, Themen Paginierung, Anmeldeaufforderungen, häufig wechselnde Zählungen Text, Markdown, Metadaten, ausgewählte Screenshots
Dokumente und Launch-Seiten Funktionsansprüche, Versionshinweise, Spezifikationen, Positionierungssprache Vorlagenrauschen, dynamische Abschnitte, geänderte Dokumentenpfade Markdown oder Text mit Quellmetadaten

Welche Produktfelder sollten Teams zuerst definieren?

Ein Schema für die Produktforschung sollte spezifisch genug sein, um eine Entscheidung zu unterstützen. Häufige Felder sind Produkttitel, Marke, SKU oder Modell, Kategorie, Variante, Verkäufer, Preis, Währung, Rabatt, Lagerstatus, Bild-URL, Beschreibung, Spezifikationen, Bewertung, Anzahl der Bewertungen, Quell-URL, endgültige URL, Zeitstempel, Antwortstatus und Ausgabeformat. Für sensible Datensätze kann ein Screenshot sichtbaren Beweis für den Produktstatus liefern.

Das genaue Schema hängt von der Aufgabe ab. Sortimentforschung könnte sich um Kategorie, Marke und Produktfamilie kümmern. Preisprüfungen benötigen Währung, Verkäufer, Variante und Werbekontext. Kataloganreicherung könnte Spezifikationen und Bilder benötigen. Produktentdeckung könnte Beschreibungen, Ansprüche, Bewertungen und Vergleichstexte benötigen. Monitoring benötigt Zeitstempel und genügend Quellkontext, um zu erklären, warum sich ein Feld geändert hat.

Feldgruppe Beispiele Warum es wichtig ist Erfassungsnotiz
Identität Titel, Marke, SKU, Modell, Kategorie, Quell-URL Hilft, Produktdatensätze über Quellen hinweg abzugleichen. Behalten Sie die endgültige URL und den Zeitstempel für die Nachverfolgbarkeit.
Kommerzieller Zustand Preis, Währung, Rabatt, Lager, Verkäufer, Versandhinweis Unterstützt Preisprüfungen und Angebotsvergleiche. Bewahren Sie den Variant- und regionalen Kontext.
Produktdetails Beschreibung, Spezifikationen, Bilder, Kompatibilität, Funktionsansprüche Unterstützt Kataloganreicherung und Produktentdeckung. Verwenden Sie HTML für strukturierte Felder oder Markdown für Bewertungen.
Ruf Bewertung, Anzahl der Bewertungen, öffentliche Snippets Fügt Marktkontext hinzu, ohne die Analyse zu ersetzen. Behalten Sie Quellbeweise und vermeiden Sie es, Snippets als vollständige Sentimentanalyse zu behandeln.
Beweis Screenshot, PDF, Antwortmetadaten, Erfassungseinstellungen Erleichtert die Prüfung von wertvollen Proben. Verwenden Sie es für QA und wichtige geänderte Datensätze.

Wann benötigen Produktseiten Rendering oder stärkere Lieferung?

Viele Produktseiten enthalten nützliche Felder im Quell-HTML. Diese Seiten können leichtgewichtig bleiben. Andere Seiten erstellen Preis, Lagerstatus, Varianten, Bewertungen, Bildgalerien, Empfehlungen oder Produktkarten, nachdem JavaScript ausgeführt wurde. Rendering ist nützlich, wenn es die Beweise ändert, die der Produktworkflow benötigt. Wartezeiten sind nützlich, wenn Inhalte spät erscheinen. Stärkere Lieferung oder regionale Routen sind nützlich, wenn die Seite unvollständige, blockierte oder marktspezifische Inhalte zurückgibt.

Der beste Weg ist evidenzbasiert. Erfassen Sie zuerst das Quell-HTML, vergleichen Sie den gerenderten Output an repräsentativen Proben, überprüfen Sie die endgültige URL und die Antwortgröße, und entscheiden Sie dann, ob Rendering, Wartezeiten, Header, Sitzungen, Länderauswahl oder Premium-Routing Teil dieses Quellprofils sein sollten. Die JavaScript-Rendering-API, Länderauswahl und Antwortformate Seiten helfen Teams, diese Entscheidungen bewusst zu treffen.

Praktische Erkenntnis: Halten Sie einfache Produktquellen leicht und reservieren Sie schwerere Kontrollen für Seiten, bei denen Proben beweisen, dass sie die Feldqualität verbessern.

Wie sollten Teams mit der Qualität von Produktdaten umgehen?

Produktdaten werden schnell unordentlich. Dasselbe Produkt kann unter verschiedenen Namen, Verkäufern, Währungen, Kategorien oder Varianten erscheinen. Ein Angebot kann in einer Region einen Rabatt und in einer anderen den vollen Preis anzeigen. Bewertungszahlen ändern sich. Bilder rotieren. Produktspezifikationen können hinter Tabs verborgen sein. Eine Kategorieseite kann gesponserte Produkte oder Personalisierung enthalten. Die Erfassungsschicht sollte genügend Beweise bewahren, damit das nachgelagerte System diese Unterschiede normalisieren kann.

ScraperFly hilft, indem es die Quellenerfassung wiederholbar und überprüfbar macht. Bewahren Sie Quell-URL, endgültige URL, Status, Inhaltstyp, Antwortgröße, Zeitstempel, Ausgabeformat und Beweisartefakte bei Bedarf auf. Verwenden Sie dann Ihr Produktmodell, um Duplikate zu entfernen, Kategorien zuzuordnen, Attribute zu bereinigen, Verkäuferangebote zusammenzuführen und zu entscheiden, welche Felder zuverlässig genug für Analysen oder Automatisierungen sind.

Wie kann Produktforschung-Scraping erschwinglich bleiben?

Produktforschung beginnt oft explorativ: eine Kategorie, einen Wettbewerber, einen Marktplatz, einige Produktfamilien, eine Handvoll Regionen. Es sollte kein großes festes Abonnement erfordern, bevor die Quellenqualität bewiesen ist. Beginnen Sie mit kostenlosen Credits, testen Sie repräsentative Seiten, kaufen Sie Pay-as-you-go-Credits für unregelmäßige Forschung und verschieben Sie die wiederkehrende Sammlung auf monatliche Credits, wenn die Quellfrequenz und das Anfrageprofil klar sind.

Die Anfragegewichtung ist ebenfalls wichtig. HTML, Text und Markdown können viele Forschungsseiten abdecken. Rendering, Wartezeiten, Screenshots, Länderrouting, Sitzungen und Premium-Lieferung gehören zu Quellen, bei denen sie die erfassten Beweise verbessern. Der Kreditkostenrechner und die Preisseite helfen, die Auswirkungen abzuschätzen, bevor Kategorien oder Marktplätze erweitert werden.

Warum ScraperFly für Produktforschung verwenden?

ScraperFly bietet Produkt-, Wachstums-, Daten- und Forschungsteams eine API-Schicht für die Erfassung öffentlicher Produktquellen. Es kann rohes HTML für die Extraktion, gerendertes HTML, wenn JavaScript wichtig ist, Text oder Markdown für Bewertungen, Metadaten für Protokollierung und Screenshots oder PDFs für visuellen Beweis zurückgeben. Es hält auch die Lieferkontrollen explizit, sodass Teams Sitzungen, Header, Länderauswahl, Wartezeiten oder Premium-Routing nur dann wählen können, wenn Beweise die schwerere Anfrage unterstützen.

Das macht die Produktforschung einfacher zu starten und sicherer zu skalieren. Teams können Quellen kostengünstig testen, Quellkontext bewahren, Antwortformate vergleichen und bewährte Seiten in wiederkehrende Workflows umwandeln, ohne zuerst fragile Abruf-, Render-, Proxy-, Screenshot- und Bereinigungsinfrastrukturen aufzubauen.


Produktforschung

Produktseiten mit Preis, Verfügbarkeit, Ansprüchen und Bewertungskontext in einem Workflow erfassen

Produktforschung benötigt mehr als nur einen Rohabruf. Nützliche öffentliche Beweise können Produktname, Marke, SKU, Preis, Rabatt, Verfügbarkeit, Varianten, Bilder, Beschreibungen, Spezifikationen, Bewertungen, Rezensionen, Verkäufer, Kategorie, Quell-URL, Zeitstempel und Screenshot-Beweise umfassen.

Handel

Verwandeln Sie öffentliche Handelsseiten in Preis- und Bestandsintelligenz

Verfolgen Sie die Preise der Wettbewerber, Lageränderungen, Verkäufer, Marktplatzangebote, Reisekosten und Katalogverschiebungen, bevor sie sich auf den Umsatz auswirken.

Laptop mit Analyse-Diagrammen zur Preisüberwachung
Handel

E-Commerce-Preisüberwachung

Beobachten Sie die Preise der Wettbewerber, Rabatte, Lagerbestände, Versandbedingungen und Verkäuferbewegungen, damit die Preisteams reagieren können, bevor Marktveränderungen unsichtbar werden.

Useful fields: Preis, Rabatt, Lager, Verkäufer, Versand

Person, die Produkte auf einem Smartphone durchsucht
Handel

Produktkataloganreicherung

Füllen Sie fehlende Titel, Beschreibungen, Spezifikationen, Bilder, Varianten und Identifikatoren von öffentlichen Produktseiten und Herstellerkatalogen aus.

Useful fields: Titel, Beschreibung, Spezifikationen, Bilder, SKU

Großer Lagergang, der die Betriebsabläufe des Marktplatzes darstellt
Handel

Marktplatz Verkäuferintelligenz

Vergleichen Sie die Verkäuferpräsenz, Erfüllungsmodelle, Sortimentstiefe, Bewertungen und Angebotsänderungen über Marktplätze hinweg.

Useful fields: Verkäufer, Bewertung, Angebot, Erfüllung, Sortiment

Lagerarbeiter, der die Regale organisiert
Handel

Bestands- und Verfügbarkeitsverfolgung

Erkennen Sie Lagerengpässe, Abholverfügbarkeit, regionale Bestände, Lieferzusagen und Produktverfügbarkeitslücken, bevor es die Kunden tun.

Useful fields: Lager, Region, Abholung, Lieferung, Zeitstempel

Person mit Einkaufstaschen, die ein Smartphone überprüft
Handel

Markenschutz

Finden Sie unautorisierte Verkäufer, verdächtige Preise, Hinweise auf Fälschungen, falsche Produktansprüche und riskante Angebote in öffentlichen Marktplätzen.

Useful fields: Verkäufer, Preis, Ansprüche, Bilder, Marktplatz

Belebte Außengastronomie und Gastgewerbeszene
Handel

Überwachung von Reisen und Gastgewerbe

Sammeln Sie Zimmerverfügbarkeiten, Preise, Annehmlichkeiten, Stornierungsbedingungen, lokale Nachfragesignale und Kontext zu Bewertungen über Buchungsoberflächen.

Useful fields: Preis, Verfügbarkeit, Annehmlichkeiten, Richtlinie, Bewertung

Telefon, das eine Online-Shopping-Oberfläche zeigt
Handel

Klassifizierte Anzeigen und Secondhand-Tracking

Überwachen Sie neue Angebote, Angebotspreise, Verkäuferaktivitäten, Artikelzustand, Standort und Veröffentlichungsalter auf Wiederverkaufsmarktplätzen.

Useful fields: Auflistung, Preis, Zustand, Verkäufer, Standort

Laptop, der finanzielle Grafiken und Analysen zeigt
Handel

Preisvergleich und Preisänderung

Verwandeln Sie Preis-Snapshots von Wettbewerbern in Preisänderungsinputs, Sortimentslücken, Margenwarnungen und Marktpositionsberichte.

Useful fields: Wettbewerber, Preis, Rang, Verfügbarkeit, Änderung

Wachstum

Finden Sie Nachfragesignale, bevor sie in Ihren eigenen Analysen erscheinen

Überwachen Sie Suchergebnisse, Anzeigen, Wettbewerberseiten, Unternehmensverzeichnisse, Einstellungsaktivitäten und Lead-Signale, um zu sehen, wo die Aufmerksamkeit hingeht.

Laptop, der ein Analyse-Dashboard zur SEO-Überwachung anzeigt
Wachstum

SERP- und SEO-Überwachung

Verfolgen Sie Ränge, Snippets, Anzeigen, lokale Pakete, Sprache, Gerät und geografische Unterschiede, um zu sehen, wie sich die Sichtbarkeit in der realen Suchoberfläche verändert.

Useful fields: Rang, URL, Snippet, Anzeigen, Geo

Laptop, der auf einer Nachrichten- oder Inhaltsseite geöffnet ist
Wachstum

Überwachung von Wettbewerbsinhalten

Beobachten Sie Seitenänderungen, Überschriften, CTAs, Schema, interne Links und den Inhaltsbestand, ohne auf manuelle Prüfungen warten zu müssen.

Useful fields: Überschrift, CTA, Schema, Links, aktualisierter Text

Hände, die ein Telefon mit Inhalten aus sozialen Medien halten
Wachstum

Anzeigenintelligenz

Sammeln Sie öffentliche Anzeigentexte, kreative Muster, Landing Pages, Regionen, Zeitpunkte und Aktivitäten von Werbetreibenden für die Kampagnenforschung.

Useful fields: Text, Kreativ, Landing-Seite, Region, Datum

Geschäftsleute, die Dokumente in einem Büro austauschen
Wachstum

Lead-Generierung und Unternehmensanreicherung

Erstellen Sie Kontenlisten und bereichern Sie Unternehmensdaten mit Domains, Standorten, Branchen, öffentlichen Kontakten, Einstellungssignalen und Technologiehinweisen.

Useful fields: Unternehmen, Domain, Branche, Standort, Signale

Kleines lokales Café-Schaufenster
Wachstum

Daten aus lokalen Unternehmensverzeichnissen

Sammeln Sie Namen, Kategorien, Adressen, Öffnungszeiten, Websites, Bewertungen und Anzahl der Bewertungen von öffentlichen Verzeichnissseiten.

Useful fields: Name, Kategorie, Adresse, Öffnungszeiten, Bewertung

Büroangestellte, die professionelle Dokumente überprüfen
Wachstum

Arbeitsmarktintelligenz

Verfolgen Sie Jobtitel, Fähigkeiten, Gehaltsbereiche, Senioritätsstufen, Remote-Richtlinien und Einstellgeschwindigkeit auf Karriereseiten und Jobbörsen.

Useful fields: Titel, Gehalt, Fähigkeiten, Standort, Seniorität

Stimme

Verwandeln Sie öffentliche Gespräche in Produkt- und Reputationssignale

Sammeln Sie Bewertungen, Medienerwähnungen, Community-Diskussionen, öffentliche Beiträge und Creator-Signale, um zu verstehen, was Kunden und Märkte sagen.

Person, die eine Zeitung liest, während sie an einem Laptop arbeitet
Stimme

Nachrichten- und Medienüberwachung

Sammeln Sie Artikel, Autoren, Daten, Themen, Entitäten, Links und Quellmetadaten für Reputations-, Forschungs- und Alarmierungs-Workflows.

Useful fields: Titel, Autor, Datum, Quelle, Entitäten

Menschen, die gemeinsam einkaufen und ein Smartphone überprüfen
Stimme

Überwachung von Bewertungen und Stimmungen

Erfassen Sie Bewertungstrends, Beschwerdethemen, Lobmuster, Unternehmensantworten und den Kontext von Produktstandorten aus öffentlichen Bewertungen.

Useful fields: Bewertung, Bewertung, Thema, Antwort, Datum

Person, die eine Social-Media-App auf einem Smartphone durchsucht
Stimme

Überwachung von sozialen und öffentlichen Webinhalten

Überwachen Sie öffentliche Beiträge, Engagement, Hashtags, Zeitstempel und Profilkontext, wo Richtlinien und Quellenzugriff dies zulassen.

Useful fields: Beitrag, Engagement, Hashtag, Profil, Zeit

Person, die Nachrichtenartikel in einem Raum liest
Stimme

Intelligenz aus Gemeinschaften und Foren

Finden Sie wiederkehrende Fragen, Beschwerden, Funktionsanfragen und Problembeschreibungen aus öffentlichen Gemeinschaften und Support-Foren.

Useful fields: Frage, Thema, Beschwerde, Antwortanzahl, Datum

Arbeitsbereich mit Laptop, Kaffee und Zeitung
Stimme

Entdeckung von Kreatoren und Influencern

Erstellen Sie Entdeckungslisten aus öffentlichen Profilseiten, Inhaltsthemen, Publikumsindikatoren, Posting-Frequenzen und Kollaborationssignalen.

Useful fields: Profil, Thema, Publikumsindikator, Frequenz, Link

Aufzeichnungen

Öffentliche Aufzeichnungen und Angebote einfacher in großem Maßstab überwachen

Extrahieren Sie Ausschreibungen, rechtliche Hinweise, Einreichungen, Finanzdaten und Immobilienangebote in beschaffte Datensätze, die von Teams durchsucht, verglichen und überprüft werden können.

Fachleute, die Geschäftsdokumente austauschen
Aufzeichnungen

Öffentliche Beschaffung und Ausschreibungen

Verfolgen Sie Käufer, Budgets, Fristen, Anforderungen, Anhänge, Auszeichnungen und Änderungen über Ausschreibungsportale und öffentliche Bekanntmachungen.

Useful fields: Käufer, Budget, Frist, Anforderungen, Auszeichnung

Fachleute, die rechtliche Dokumente in einem Büro besprechen
Aufzeichnungen

Regulatorische und rechtliche Überwachung

Überwachen Sie Bekanntmachungen, öffentliche Register, Wirksamkeitsdaten, Dokumentversionen, betroffene Stellen und compliance-relevante Änderungen.

Useful fields: Bekanntmachung, Einheit, Datum, Dokument, Status

Fachleute, die Finanzdokumente überprüfen
Aufzeichnungen

Finanz- und öffentliche Marktforschung

Sammeln Sie Einreichungen, Offenlegungen, Tabellen, Nachrichten, Instrumentenmetadaten und öffentliche Finanzkontexte für Forschungs-Pipelines.

Useful fields: Einreichung, Tabelle, Emittent, Datum, Metrik

Haus-Schlüssel und Bargeld für Immobilienmarktdaten
Aufzeichnungen

Immobilienangebote und Marktdaten

Verfolgen Sie Listenpreise, Adressen, Immobilienattribute, Agentendetails, Status, Geschichte und Nachbarschaftskontext.

Useful fields: Preis, Adresse, Schlafzimmer, Agent, Status

Datenprodukte

Erstellen Sie Datenprodukte aus gescrapten Seiten, nicht aus Seiten-Dumps

Bereinigen, normalisieren, validieren, anreichern, vergleichen und öffentliche Webdaten in Datenbanken, Dashboards, Benachrichtigungen und LLM-Pipelines liefern.

Laptop-Bildschirm mit Programmiercode
Datenprodukte

LLM-bereite Webdaten-Pipelines

Konvertieren Sie öffentliche Seiten in sauberen Text, Markdown, Abschnitte, Metadaten, Zitationen und Frischhaltungszeichen für Abruf- oder Modell-Workflows.

Useful fields: sauberer Text, Markdown, Abschnitt, Quell-URL, Zeitstempel

Rechenzentrumsserver-Racks für Datenbank-Workflows
Datenprodukte

Strukturierte Extraktion in die Datenbank

Verwandeln Sie HTML, PDFs, Tabellen und Seitentext in typisierte Datensätze, die gespeichert, abgefragt, zusammengeführt und später geprüft werden können.

Useful fields: JSON, Typ, Quelle, Schema, Datensatz-ID

Laptop mit Programmier- und Datenanalyse-Schnittstelle
Datenprodukte

Änderungserkennung und Benachrichtigung

Vergleichen Sie Schnappschüsse und benachrichtigen Sie Teams, wenn sich Preise, Lagerbestände, Rang, Inhalt, Status oder regulatorische Sprache ändern.

Useful fields: vorheriger Wert, neuer Wert, Delta, Schwellenwert, Alarm

Computerbildschirm mit buntem Code und Daten
Datenprodukte

Entitätsanreicherung und -normalisierung

Produkt-IDs, Firmennamen, Standorte, Personen, Kategorien, Einheiten, Währungen und Taxonomie-Zuordnungen normalisieren.

Useful fields: Einheit, kanonische ID, Kategorie, Einheit, Vertrauen

Nahaufnahme eines Server-Racks mit blauen Indikatoren
Datenprodukte

Datenqualitätsvalidierung

Überprüfen Sie erforderliche Felder, Datentypen, Bereiche, Duplikate, Quellenbeweise und verdächtige Datensätze vor der nachgelagerten Verwendung.

Useful fields: erforderliches Feld, Typ, Bereich, Beweis, Vertrauen

Laptop mit Code-Editor für Datenberichterstattung
Datenprodukte

Berichterstattungs- und Dashboard-Feeds

Speisen Sie BI-Dashboards, Marktberichte, Betriebs-Scorecards und wiederkehrende Analysen mit Webdaten, die planmäßig aktualisiert werden.

Useful fields: Metrik, Dimension, Zeitraum, Quelle, Aktualisieren

Warum ScraperFly

Halten Sie die Produktforschung flexibel, während Ziele, Felder und Frequenz sich noch ändern

Verwenden Sie sauberen Text für Bewertungen, HTML für die Extraktion, Metadaten für die Anreicherung und Screenshots, wenn der sichtbare Produktstatus wichtig ist. Fügen Sie Rendering oder Routing nur hinzu, wenn Quellproben den Bedarf beweisen.

  • Lücken schließen, die von APIs hinterlassen werdenViele Quellen bieten nützliche öffentliche Seiten, aber keine vollständige API für die genauen Felder, Geos, Filter oder Historien, die ein Team benötigt.
  • Änderungen im Laufe der Zeit überwachenWiederkehrende Scrapes erstellen eine Historie von Preisen, Inhalten, Verfügbarkeit, Rängen, Bewertungen, Mitteilungen und Marktbewegungen.
  • Vergleichen Sie über QuellenScraping ermöglicht den Vergleich über verschiedene Seiten hinweg, wenn Marktplätze, Verzeichnisse, Portale und Verlage Daten unterschiedlich strukturieren.
  • Erstellen Sie verwendbare DatensätzeDie nützliche Ausgabe ist kein Seiten-Dump; es ist ein dokumentierter, zeitgestempelter, normalisierter Datensatz, dem nachgelagerte Systeme vertrauen können.
Beste Passform

Nützlich für Sortimentforschung, Marktanalysen, Produktentdeckung, Preisprüfungen und Kataloganreicherung

Teams können die Quellenqualität an einem kleinen Produktsatz validieren, Ausgabeformate vergleichen und die wiederkehrende Erfassung nur auf Seiten und Kategorien verschieben, die kommerziellen Wert beweisen.

Eine API für verschiedene Quellen

Verwenden Sie dasselbe Integrationsmuster über Geschäfte, Suchseiten, Verzeichnisse, Dokumente, öffentliche Listen und Datenprodukt-Pipelines.

Lieferkontrollen, wenn nötig

Rendering, Sitzungen, Header, Geo und Proxy-Routing können für Ziele hinzugefügt werden, die sie benötigen, ohne den Workflow neu zu erstellen.

Ausgabe, die die Nachbearbeitung unterstützt

HTML, Screenshots, reiner Text, Markdown und strukturierte Extraktionspfade helfen Teams, von der Seitenabfrage zu verwendbaren Datensätzen überzugehen.

Weniger Scraping-Infrastruktur zu besitzen

Teams können sich auf Felder, Validierung, Aktualität und Geschäftslogik konzentrieren, anstatt sich um Browserflotten, Routing-Eckfälle und Retry-Mechanismen zu kümmern.

Verhalten der Produktquelle

Überprüfen Sie Varianten, Lokalisierung, Renderzeit und Angebotsstatus, bevor Sie Produkte vergleichen

Produktseiten können je nach Region, Verkäufer, Variante, Verfügbarkeit, Werbung, Cookie-Zustand, JavaScript, Paginierung und Marktplatzvorlage variieren. Stabile Forschung beginnt damit, zu wissen, wo die Produktbeweise tatsächlich erscheinen.

Roh-HTML-Antwort, die auf sichtbare Seitendaten abgebildet ist
01

Verfügbarkeit von Roh-HTML

Überprüfen Sie, ob die benötigten Felder bereits in der ersten HTML-Antwort vorhanden sind.

Bester erster Test für einfache Seiten, Artikel, Dokumente, Listen und Produktdetails.

Vergleich vor und nach der JavaScript-Rendering
02

JavaScript-Abhängigkeit

Vergleichen Sie das Roh-HTML mit dem gerenderten DOM oder Screenshot, bevor Sie das Browser-Rendering aktivieren.

Verwenden Sie Rendering, wenn das Roh-HTML nur eine Hülle ist und Skripte den nützlichen Inhalt erstellen.

Cookies, Zustimmung, Sitzung und Zugriffs-Kontext für das Scraping
03

Status & Zugriffs-Kontext

Identifizieren Sie, ob Cookies, Zustimmung, Anmeldegrenzen, Pagination oder der gleiche Besucherstatus die Antwort beeinflussen.

Verwenden Sie Sitzungen und Header, wenn die Kontinuität die Daten, die Sie erhalten, verändert.

Regionale Inhaltsvariationen über Länder und Routen hinweg
04

Geo-/Inhaltsvariation

Testen Sie, ob Land, Sprache, Währung, Inventar, SERP, Anzeigen oder Routenreputation das Ergebnis verändern.

Verwenden Sie Geo- oder Premium-Routing nur, wenn sichergestellt ist, dass die Antwort je nach Route variiert.

Überprüfungen vor dem Scraping von Produktforschungen

Wo befindet sich das Ziel-Feld?

Finden Sie heraus, ob das Feld im Roh-HTML, im gerenderten DOM, einem API-Aufruf, strukturierten Daten, einer Datei oder einem späteren Interaktionszustand vorhanden ist.

Was ändert die Antwort?

Probieren Sie einige URLs aus und vergleichen Sie Status, endgültige URL, Inhaltslänge, Weiterleitungen, leere Zustände und sichtbare Ergebnisunterschiede.

Welcher Kontext ist erforderlich?

Markieren Sie alle Abhängigkeiten von Zustimmung, Gebietsschema, Cookies, Headern, Authentifizierungsgrenzen, Paginierung, Filtern oder vorherigen Anfragen.

Wie sieht ein Fehler aus?

Definieren Sie die Signale für blockierte, teilweise, veraltete, umgeleitete, leere, zeitüberschreitende oder regionsfremde Antworten, bevor Sie skalieren.

Wie sich Produktseiten auf die Erfassungseinrichtung auswirken

Variantenzustand

Verfolgen Sie Größe, Farbe, Bundle, Verkäufer oder Modellkontext hinter jedem erfassten Preis- und Verfügbarkeitsfeld.

Gerenderte Felder

Vergleichen Sie Quell-HTML mit gerendertem Output, wenn Preise, Bewertungen, Lagerstatus oder Spezifikationen nach JavaScript erscheinen.

Regionale Angebote

Verwenden Sie länderspezifische oder sprachliche Kontexte, wenn sich öffentliche Produktinformationen nach Markt ändern.

Beweisbedürfnisse

Verwenden Sie Screenshots für wertvolle Aufzeichnungen, Promotionsabzeichen, geänderte Lageretiketten oder QA-Proben.

Produktfelder

Beweisen Sie die Antwortstruktur, bevor Sie Kategorien erweitern

Produktseiten variieren je nach Quelle, Kategorie, Verkäufer, Region und Renderverhalten. Definieren Sie die relevanten Felder und testen Sie repräsentative Proben, bevor Sie eine Kategorie in ein wiederkehrendes Scraping umwandeln.

Ein sauberer API-Anforderungs-Sender mit API-Schlüssel, Methode, URL, Ausgabeformat und Sendesteuerungen

01 / Anforderungs-Sender

Beginnen Sie mit dem Tool, das Ihr Team bereits für API-Tests verwendet

Öffnen Sie Postman, Insomnia, Hoppscotch, Bruno, Thunder Client, curl oder jeden Sender, der GET-, POST- und PUT-Anfragen stellen kann. Es geht nicht um das Tool; es geht darum, das genaue Anforderungsprofil einmal auszuführen, bevor es zu einem Batch-Job wird.

PostmanInsomniaHoppscotchBrunoThunder Clientcurl
Erwartetes Ergebnis im Vergleich zum erhaltenen Ergebnis, während Ausgabeformat, Premium-Proxy, Land und Rendering-Einstellungen angepasst werden

02 / Erwartet vs. erhalten

Passen Sie die Anfrage an, bis die erhaltene Ausgabe mit dem erwarteten Ergebnis übereinstimmt

Wechseln Sie zwischen HTML, reinem Text, Markdown, PDF, JSON oder Screenshot-Ausgabe und überprüfen Sie, was zurückkommt. Wenn die Antwort unvollständig ist, optimieren Sie das Rendering, den Premium-Proxy, das Land, die Header, Sitzungen, Wartezeiten oder Wiederholungen, bis das Beispiel das Datenartefakt produziert, das Ihr Workflow benötigt.

  • Entspricht der Inhaltstyp dem Workflow?
  • Sind erforderliche Felder vorhanden und lesbar?
  • Ändert sich das Ergebnis durch Land oder Premium-Proxy?
  • Erzeugt das Rendering fehlenden Seiteninhalt?
Eine validierte Beispielanfrage, die in Dateien, Datenbankeinträge und Automatisierungsausgaben skaliert

03 / Skalieren Sie nur nach dem Nachweis

Verwandeln Sie das validierte Beispiel in ein wiederholbares Extraktionsprofil

Sobald eine URL das richtige Artefakt zurückgibt, verwenden Sie die gleichen Anfrageeinstellungen für das größere URL-Set. Das hält Batch-Jobs an ein bekannt gutes Profil gebunden, anstatt Format-, Routing- oder Rendering-Fehler nach Tausenden von Anfragen zu entdecken.

Batch-ExporteDatenbankeinträgeAutomatisierungenQA-Nachweise

Forschungskosten

Testen Sie Produktquellen, bevor Sie die Forschung in ein wiederkehrendes Crawling umwandeln.

Produktforschung beginnt oft mit unbekannten Kategorien und ungleichmäßiger Quellqualität. ScraperFly gibt Teams die Möglichkeit, kostenlos zu starten, Credits für explorative Arbeiten zu kaufen und monatliches Volumen für bewährte Quellen zu reservieren.

Glückliches Team, das ein Projekt auf einem Laptop validiert
01 / Einfach starten

Einfacher, kostenloser Start ohne Druck durch Rechnungsstellung

ScraperFly gibt Ihnen die Möglichkeit, zuerst das echte Ziel zu testen. Verwenden Sie kostenlose Credits, um zu überprüfen, ob die Seite funktioniert, ob die Daten vorhanden sind und welche Kontrollen tatsächlich benötigt werden, bevor Sie Geld für einen Plan ausgeben. Das macht das erste Experiment leicht: kein Beschaffungsprozess, kein erzwungener Abonnement, kein Raten Ihres monatlichen Volumens am ersten Tag.

Kostenlose CreditsKeine Karte für erste TestsValidieren, bevor Sie skalieren
Lächelnder Profi, der erfolgreich mit einem Laptop arbeitet
02 / Klug ausgeben

Erschwingliche, flexible Abrechnung für reale Scraping-Volumen

Nicht jede Scraping-Arbeitslast ist eine klare monatliche Kurve. Einige Projekte steigen, einige pausieren, und einige werden erst wiederkehrend, nachdem die Daten ihren Wert beweisen. ScraperFly unterstützt diese Realität mit einem Pay-as-you-go-Weg plus monatlichen Kreditplänen, wenn ein stetiges Volumen sinnvoll ist. Sie können kaufen, was Sie benötigen, die Kosten im Blick behalten und vermeiden, einen kleinen Test in ein übergroßes Abonnement zu verwandeln.

Bezahlen nach BedarfMonatlich, wenn sinnvollKostenkontrolle
Entwickler, der strukturierten Output von einem Laptop vorbereitet
03 / Schneller versenden

Antwortvorverarbeitung, die Aufräumarbeiten entfernt

Ein günstiger Abruf reicht nicht aus, wenn Ihr Team immer noch Konverter, Cleaner, Screenshots, PDF-Erfassung und LLM-bereite Formatierung darum herum bauen muss. ScraperFly kann die Antwort als HTML, reinen Text, Markdown, strukturiertes JSON, PDF oder Bildausgabe zurückgeben, sodass Ihre Pipeline näher am endgültigen Asset in einer Anfrage liegt. Weniger Klebekode, weniger bewegliche Teile, schnellere Lieferung.

HTMLTextMarkdownJSONPDFBild

Wo ScraperFly in die Produktforschung passt

Der Vorteil ist praktische Kontrolle: einfache Seiten bleiben leicht, dynamische Produktseiten können Rendering hinzufügen, und wertvolle Seiten können Nachweis oder Routing nur verwenden, wenn Beweise das Ergebnis verbessern.

EntscheidungspunktScraperFly-VorteilTypischer Wettbewerbsnachteil
Erster QuellentestBeginnen Sie mit kostenlosen Credits und validieren Sie, ob eine Produkt-, Kategorie- oder Marktplatzseite verwendbare Beweise liefert.Viele Tools drängen Teams dazu, einen wiederkehrenden Plan zu verfolgen, bevor die Qualität der Quelle nachgewiesen ist.
Explorative KategorienNutzen Sie nutzungsabhängige Credits, während Kategorien, Felder und Frequenz sich noch ändern.Feste monatliche Pauschalen können unangenehm sein, wenn das Forschungsvolumen ungleichmäßig ist.
Dynamische ProduktseitenFügen Sie Rendering, Wartezeiten, Sitzungen oder Routing nur hinzu, wenn die erfasste Antwort beweist, dass sie die Produktfelder verbessern.Schwerere Profile können zum Standard werden, selbst wenn der Quell-HTML ausreicht.
NachweisprotokolleVerwenden Sie Screenshots oder PDFs für wertvolle Proben, ohne die visuelle Erfassung für jede URL verpflichtend zu machen.Visuelle Erfassung kann in umfassendere Pläne integriert oder als separater Workflow behandelt werden.

Produktforschungsanforderungs-Builder

Erstellen Sie Produktanforderungen im richtigen Format für Überprüfung, Extraktion oder Nachweis

Verwenden Sie HTML für benutzerdefinierte Produktextraktion, Text oder Markdown für lesbare Überprüfungen, Metadaten zur Anreicherung und Screenshots oder PDFs für sichtbare Produktnachweise.

SKU
Katalog

Produktidentität und Kontext erfassen

SKU, Marke, Titel, Verkäufer, Quell-URL, endgültige URL und Zeitstempel halten Produktaufzeichnungen nachvollziehbar.

skuMarkeQuelle
USD
Angebote

Preis- und Verfügbarkeitsnachweise bewahren

Preis, Rabatt, Lagerzustand, Währung, Verkäufer und Variantenkontext machen Vergleiche zuverlässiger.

PreisLager
IMG
Beweis

Verwenden Sie visuelle Erfassung, wenn der Produktzustand wichtig ist

Screenshots helfen, Abzeichen, Aktionen, sichtbare Ansprüche, Variantenwähler und gerenderte Produktabschnitte zu überprüfen.

Screenshotrender

Steuerungen, die das Scraping von Produktforschung gestalten

url

Die öffentliche Produkt-, Kategorie-, Marktplatz-, Bewertungs- oder Angebotsseite, die erfasst wird.

format

Die Ausgabeform für Extraktion, Überprüfung, Anreicherung oder Nachweis.

render

Browserausführung, wenn nützliche Produktfelder clientseitig sind.

wait

Zeitsteuerung für spät ladende Bestände, Bewertungen, Galerien oder Produktkarten.

country

Regionale Weiterleitung, wenn Produktangebote je nach Markt variieren.

download

Dateiausgabe für Screenshot oder PDF-Nachweis.

cURL-Beispiel

Generieren Sie Markdown mit derselben Anfrageform, die Sie in die Produktion überführen können.

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Produktwiederherstellung

Verwandeln Sie Produkt-Scrape-Fehler in klare Anfrageentscheidungen

Fehlender Preis, leere Spezifikationen, geänderte Bestandsbezeichnungen oder unerwartete Seiten sollten mit der endgültigen URL, dem Status, der Antwortgröße, dem Quell-HTML, der gerenderten Ausgabe und Nachweismustern diagnostiziert werden.

Entwickler, der Code und API-Anforderungsparameter auf einem Laptop überprüft

01 / Anforderungssetup und Zugriff

Beheben Sie zuerst Anforderungsfehler

Einige Fehler sind überhaupt keine Zielprobleme. Sie treten auf, bevor ScraperFly einen sinnvollen Zustellversuch unternehmen kann: eine fehlende oder fehlerhafte URL, ein nicht unterstütztes Ausgabeformat, ein inkompatibler visueller Dateityp, ein fehlender API-Schlüssel, ein ungültiger Schlüssel oder ein Schlüssel, der pausiert oder deaktiviert wurde. Diese Fehler sind Konfigurationssignale, keine Wiederholsignale: Stoppen Sie den Workflow, weisen Sie den Entwickler auf das genaue Feld hin, das korrigiert werden muss, und konzentrieren Sie die Credits auf echte Zieltests anstelle wiederholter fehlerhafter Eingaben.

missing_urlinvalid_urlunsupported_formatinvalid_api_key
  • Validieren Sie die URL und die Kodierung, bevor Sie einen Batch senden.
  • Verwenden Sie unterstützte Ausgaben: HTML, Text, Markdown, JSON, Screenshot oder PDF.
  • Passen Sie die Screenshot-Dateitypen an den Bildausgang und den PDF-Dateityp an den PDF-Ausgang an.
  • Behandeln Sie fehlende oder ungültige API-Schlüssel als Konfigurationsarbeit, nicht als Wiederholungsarbeit.
Business-Dashboard mit Diagrammen, Dokumenten und Nutzungsplanung auf einem Schreibtisch

02 / Credits, Limits und Parallelität

Trennen Sie Limits von Fehlern

Eine Arbeitslast kann fehlschlagen, weil das Konto keine verwendbaren Credits hat, das monatliche Planlimit erreicht wurde oder die Parallelität für den aktuellen Plan und die Zielmischung zu aggressiv ist. ScraperFly macht diese Grenzen als Betriebssignale sichtbar, nicht als mysteriöse Scrape-Fehler. Das hält die Kaufentscheidung praktisch: kostenlos starten, das Ziel testen, Pay-as-you-go-Credits für unregelmäßige Jobs kaufen, auf monatliche Credits umsteigen, wenn das Volumen vorhersehbar wird, und Backoff verwenden, wenn der Anforderungsdruck das eigentliche Problem ist.

usage_limit_reachedrate_limitedcreditsBackoff
  • Verwenden Sie den Kontostatus, um verbleibende Credits vor großen Ausführungen zu überprüfen.
  • Wiederholen Sie die Ratenlimits mit Backoff, anstatt sofort den Druck zu erhöhen.
  • Halten Sie einmalige Projekte im Pay-as-you-go-Modell, wenn das Volumen unregelmäßig ist.
  • Verschieben Sie vorhersehbare wiederkehrende Arbeiten auf monatliche Credits, wenn das Muster bewiesen ist.
Serverraum, der Lieferwege, Routing und Netzwerk-Infrastruktur darstellt

03 / Zielzustellung und Netzwerk

Finden Sie zuerst Lieferfehler

Viele Scraping-Plattformen fassen Lieferprobleme in einem vagen Anforderungsfehler zusammen. In der Produktion ist das nicht genug. Das Team muss wissen, ob die Anfrage zeitlich abgelaufen ist, das Ziel upstream einen vorübergehenden Serverfehler zurückgegeben hat, die Verbindung fehlgeschlagen ist, die Antwort zu groß war, Weiterleitungen irgendwo unerwartet gingen oder die Seite als winziges HTML ohne nützlichen Inhalt zurückkam. ScraperFly verwandelt diese Fehler in Liefernachweise: Versuchen Sie zuerst das leichte Profil, vergleichen Sie den Status und die Antwortgröße, und entscheiden Sie dann, ob die nächste Anfrage Backoff, eine andere Route, einen Premium-Proxy, Länderauswahl oder eine engere Erfassung benötigt.

Zeitüberschreitung5xxWeiterleitungenAntwort_zu_groß
  • Wiederholen Sie vorübergehende Netzwerk- und Upstream-Fehler mit einer kontrollierten Backoff-Politik.
  • Vergleichen Sie die endgültige URL, den Status, den Inhaltstyp und die Antwortgröße über die Proben.
  • Eskalieren Sie das Routing nur, wenn die Antwort beweist, dass der einfache Pfad instabil ist.
  • Behandeln Sie übergroße Antworten als ein Umfangsproblem, bevor Sie dasselbe Profil skalieren.
Digitaler Sicherheitsbildschirm, der Anti-Bot- und geschützte Zugriffssignale darstellt

04 / Anti-Bot-, Geo- und Zugriffsblöcke

Blöcke lesen, bevor Sie eskalieren

Ein Ziel 403, 401, 429, CAPTCHA-Bildschirm, WAF-Herausforderung, Login-Wall, Einwilligungsloop oder regionsspezifische Fehlanpassung ist nicht nur ein Fehler; es ist ein Hinweis darauf, was die Website vom Besucher erwartet. Wettbewerber drängen oft Teams zu einem schwereren Standardprofil, aber das kann das Budget belasten, ohne die Lösung zu beweisen. Der bessere Weg von ScraperFly ist eine evidenzbasierte Eskalation: realistische Header beibehalten, wenn der Kontext wichtig ist, Sitzungen verwenden, wenn die Kontinuität die Antwort ändert, Rendering aktivieren, wenn der nützliche Inhalt browserbasiert ist, und Premium- oder Länderrouting wählen, wenn Reputation oder Geografie das Ergebnis ändern.

403429CAPTCHALänderfehlanpassung
  • Verwenden Sie Premium-Routing, wenn die IP-Reputation der nachgewiesene Engpass ist.
  • Verwenden Sie Ländermarkierung, wenn Sprache, Währung, Inventar oder Suchergebnisse je nach Markt variieren.
  • Verwenden Sie Header, Cookies und Sitzungen, wenn sich der Zustand des Besuchers auf die Antwort auswirkt.
  • Reduzieren Sie die Parallelität und fügen Sie Backoff hinzu, wenn wiederholte Anfragen die Ziel-Drosselung auslösen.
Entwickler, der Code und Ausgabeartefakte auf einem Laptop vorbereitet

05 / Rendering- und Ausgabequalität

Nutzbare Artefakte versenden

Ein 200-Status ist nicht dasselbe wie ein nutzbarer Scrape. Das rohe HTML kann eine leere App-Schale sein, Markdown kann den Hauptartikel verpassen, JSON kann erwartete Metadaten fehlen, Text kann Rauschen enthalten, Screenshots können leer sein, und PDF- oder Bildausgaben können fehlschlagen, wenn der Browser-Schritt abläuft. ScraperFly ist wertvoll, weil dieselbe API-Anfrage von rohem HTML zu gerendertem DOM, sauberem Text, Markdown, JSON, Screenshot oder PDF wechseln kann und dann gegen das Artefakt überprüft wird, das Ihr Produkt tatsächlich benötigt. Das reduziert Klebekode, fehlgeschlagene Importe und teure Batchläufe, die nur nachträglich schlechte Ausgaben entdecken.

render_timeoutbrowser_render_failedJSON-FelderPDF/Bildausgabe
  • Rendering aktivieren, wenn rohes HTML nur eine Schale ist und der nützliche Inhalt nach JavaScript erscheint.
  • Validieren Sie Text, Markdown und JSON gegen erwartete Felder, bevor Sie sie batchen.
  • Verwenden Sie Screenshot- oder PDF-Ausgaben, wenn visuelle Beweise oder Prüfungsnachweise wichtig sind.
  • Behandeln Sie leere oder teilweise Artefakte als Qualitätsfehler, selbst wenn der HTTP-Status erfolgreich ist.

Produktforschungskosten

Halten Sie die Kosten für die Produktforschung im Einklang mit der Schwierigkeit und dem Rhythmus der Quelle

Produktforschung kann erschwinglich bleiben, wenn einfache Seiten HTML, Text oder Markdown verwenden und schwereres Rendering, Wartezeiten, Screenshots, Länder-Routing, Sitzungen oder Premium-Lieferungen für Quellen reserviert sind, bei denen Muster beweisen, dass sie die Produktbeweise verbessern.

01

Kategorienaustausch

Mehr Kategorien, Varianten, Regionen und Pagination multiplizieren schnell das Anfragevolumen.

02

Gerenderte Produktfelder

Die Ausführung im Browser ist schwerer, daher sollte sie verwendet werden, wenn Preis, Lagerbestand, Bewertungen oder Spezifikationen clientseitig sind.

03

Visueller Beweis

Screenshots und PDFs sind wertvoll für QA und hochpreisige Aufzeichnungen, nicht jede Produktseite.

04

Marktplatzlieferung

Premium-Routing, Sitzungen, Header und Länderauswahl sollten auf Beweisen aus echten Proben basieren.

Was das Scraping von Produktforschung schwerer macht

Mehr Infrastrukturarbeit

Browser-Rendering, Routing-Entscheidungen und längere Wartezeiten bedeuten, dass die Plattform mehr tun muss, als nur eine einfache Antwort zurückzugeben.

Mehr Zielunsicherheit

Weiterleitungen, leere Zustände, Ratenlimits und Challenge-Seiten erfordern oft stärkere Lieferoptionen oder Wiederholungen.

Mehr Zustand zu bewahren

Cookies, Sitzungen, Einwilligungen und mehrseitige Abläufe fügen bewegliche Teile hinzu, die ein einfacher zustandsloser Abruf nicht hat.

Mehr Beweise zurückzugeben

Screenshots, PDFs, gerenderte Ausgaben und reichhaltigere Antwortartefakte sind nützlich, aber sie sind schwerer als einfaches HTML.

Wie ScraperFly die Produkterfassung praktisch hält

Beispiel vor der Skalierung

Testen Sie zuerst eine kleine URL-Gruppe und gruppieren Sie Ziele nach dem leichtesten Profil, das vollständige Daten zurückgibt.

Standardmäßig nicht rendern

Überprüfen Sie das rohe HTML, bevor Sie das Rendering aktivieren. Viele öffentliche Seiten enthalten bereits die Daten, die Sie benötigen.

Eskalieren Sie anhand von Beweisen

Steigen Sie nur auf, wenn die Antwort fehlende Inhalte, Zustandsabhängigkeit, geo-variationen oder Routing-Probleme zeigt.

Nützliche Ergebnisse messen

Optimieren Sie basierend auf gültigen gelieferten Datensätzen, nicht auf dem Rohanfragevolumen. Ein leichteres Profil ist nur dann am besten, wenn es vollständig bleibt.

FAQ zur Produktforschung

Häufige Fragen zu Workflows beim Scraping von Produktforschung

Praktische Antworten für Teams, die öffentliche Produktseiten erfassen und dabei Quellbeweise, Produktfelder, Rendering-Optionen, visuelle Nachweise und Kostenkontrolle explizit halten.

Produkt-FAQ

Produktseiten

Klären Sie, was ScraperFly erfasst und was nachgelagerte Systeme modellieren.

Was ist Web Scraping für Produktforschung?

Es handelt sich um die Erfassung öffentlicher Produktseiten, Kategorieseiten, Marktplatzangebote, Preisseiten, Bewertungen, Spezifikationen, Verfügbarkeitszustände und Quellennachweise, damit Teams Produktinformationen in ihrem eigenen Forschungsworkflow überprüfen und vergleichen können.

Normalisiert ScraperFly Produktkataloge automatisch?

ScraperFly erfasst öffentliche Quellseiten und Antwortnachweise. Katalognormalisierung, Duplikatbereinigung, Taxonomiezuordnung, Attributbereinigung und geschäftsspezifische Bewertung sollten im nachgelagerten Produktdatensystem erfolgen.

Produktaufzeichnungen

Erfassen Sie konsistente Produktbeweise vor der Normalisierung.

Welche Produktfelder sind nützlich zu erfassen?

Nützliche Felder umfassen oft Produktname, Marke, SKU oder Modell, Preis, Währung, Rabatt, Verfügbarkeit, Variante, Verkäufer, Kategorie, Bilder, Beschreibung, Spezifikationen, Bewertung, Anzahl der Bewertungen, Quell-URL, endgültige URL, Zeitstempel und Screenshot-Nachweise für wichtige Aufzeichnungen.

Wie sollten Teams Produkte über Quellen hinweg vergleichen?

Halten Sie Quell-URLs, endgültige URLs, Zeitstempel, Währung, Variantenkontext, Verkäuferkontext und Ausgabeformat sichtbar. Vergleichen Sie normalisierte nachgelagerte Aufzeichnungen erst, nachdem die öffentlichen Seitenbeweise hinter jeder Probe erhalten geblieben sind.

Rendering und Beweis

Verwenden Sie schwerere Erfassungen nur, wenn Produktproben den Bedarf nachweisen.

Wann benötigt das Produktforschung-Scraping Rendering?

Verwenden Sie Rendering, wenn Preis, Verfügbarkeit, Varianten, Bewertungen, Bilder oder Produktdetails nur nach dem Ausführen von clientseitigem JavaScript angezeigt werden. Vergleichen Sie den Quell-HTML-Code mit einem gerenderten Beispiel, bevor Sie die Browserausführung zur Standardoption machen.

Sollte die Produktforschung Screenshots verwenden?

Screenshots sind nützlich, wenn der visuelle Zustand wichtig ist: Aktionsabzeichen, Variantenauswähler, geänderte Preisanzeigen, Lageretiketten, Produktansprüche oder QA-Proben. Die maschinenbasierte Extraktion funktioniert normalerweise besser aus HTML, Text, Markdown und Metadaten.

Bewertungen und Kosten

Halten Sie das Anfragegewicht an die Quellenqualität und den Forschungswert gebunden.

Kann ScraperFly Produktbewertungen oder -bewertungen erfassen?

ScraperFly kann öffentliche Seiten erfassen, die Bewertungs- und Bewertungszusammenhänge anzeigen, wenn sie erreichbar und für den Workflow geeignet sind. Die Interpretation von Bewertungen, Sentiment-Bewertung und Duplikatbereinigung gehören in die nachgelagerte Analyseebene.

Wie kann das Produktforschung-Scraping die Kosten kontrollieren?

Beginnen Sie mit leichtem HTML, Text oder Markdown auf repräsentativen Quellen. Fügen Sie Rendering, Wartezeiten, Screenshots, Länderrouting, Sitzungen oder Premium-Lieferungen nur hinzu, wenn Proben beweisen, dass diese Kontrollen die Qualität der Produktbeweise verbessern.






































