






Рабочий процесс рендеринга Angular
Рендеринг страниц Angular, когда полезный DOM появляется после запуска приложения
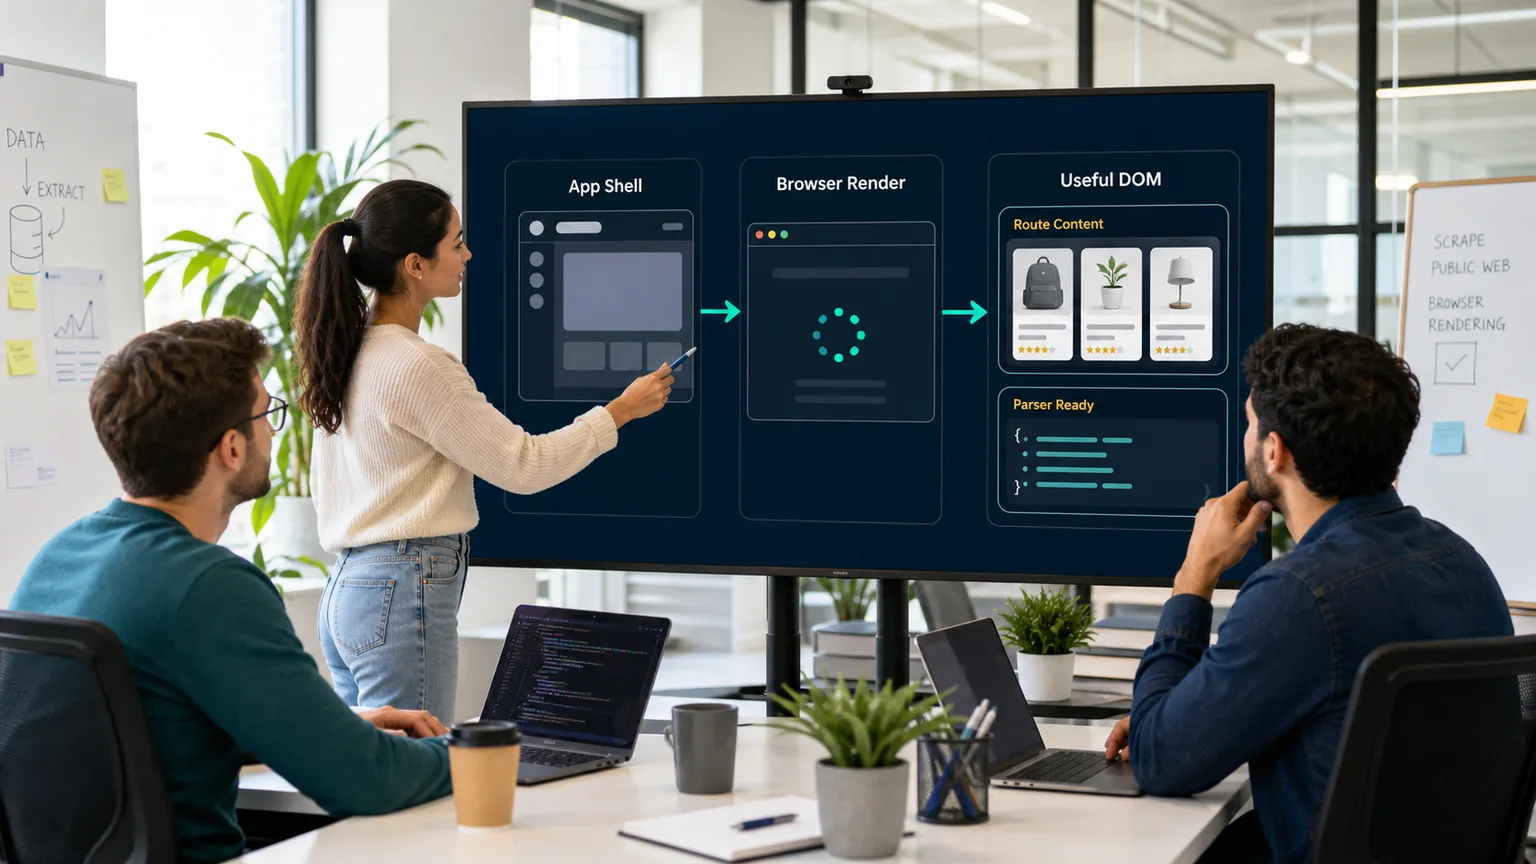
Сайты на Angular часто сначала отправляют небольшой оболочку приложения, а затем строят контент маршрутов, списки, фильтры, карточки продуктов, разделы статей или общедоступные данные, не зависящие от аккаунта, после выполнения JavaScript. Парсер, который читает только первый HTML-ответ, может увидеть контейнеры, заполнители и скрипты вместо контента, необходимого для вашего рабочего процесса.
ScraperFly предоставляет командам контролируемый способ сканирования общедоступных страниц Angular: проверка сырого ответа, рендеринг только тогда, когда цель доказывает, что требуется выполнение в браузере, а затем возврат рендеренного HTML, текста, Markdown, метаданных, скриншотов или PDF в одном запросе.
Что делает сайты на Angular отличными для сканирования?
Страница Angular может не вести себя как традиционный документ. Первый ответ может содержать корневой контейнер приложения, пакеты скриптов, стили и ограниченное количество серверно-рендеренного разметки. Контент, который видит пользователь, может появиться только после загрузки приложения Angular, разрешения маршрутов, получения данных общедоступного API, рендеринга компонентов и обновления DOM.
Это не означает, что каждая страница Angular нуждается в браузере. Некоторые сайты на Angular используют серверный рендеринг, предварительно рендеренный контент, встроенное состояние или метаданные, которые уже предоставляют парсеру то, что ему нужно. Правильный рабочий процесс — протестировать цель, сравнить сырой HTML с рендеренным HTML и выбрать самый легкий запрос, который возвращает полный полезный контент.
Практическое замечание: сканируйте страницы Angular, доказывая, где появляется полезный контент, а не предполагая, что каждая страница фреймворка требует самого тяжелого запроса.
Когда сканирование Angular должно использовать рендеринг в браузере?
Рендеринг в браузере полезен, когда Angular изменяет захваченный результат. Это обычно означает, что исходный HTML является только оболочкой приложения, контент маршрута появляется после навигации на стороне клиента, важные карточки загружаются после вызовов общедоступного API, или странице требуется короткая пауза перед тем, как финальный DOM будет готов. Рендеринг предоставляет вашему парсеру разметку после завершения этих шагов на стороне браузера.
| Поведение Angular | Что вы можете увидеть в сыром HTML | Лучший следующий шаг |
|---|---|---|
| Клиентский рендеринг маршрута | Корневой элемент приложения, скрипты и пустые контейнеры маршрутов. | Используйте рендеренный HTML и проверьте завершенный DOM. |
| SSR или предварительно рендеренный контент | Полезные заголовки, ссылки, текст, карточки или встроенное состояние уже присутствуют. | Сохраняйте запрос легким с сыром HTML, текстом или Markdown. |
| Заданные данные общедоступного API | Заполнители или состояния загрузки без финального списка или деталей. | Используйте рендеринг с измеренной паузой вместо повторных слепых попыток. |
| Состояние маршрута или фильтра имеет значение | URL загружается, но видимая страница изменяется после того, как приложение разрешает состояние. | Захватите рендеренный HTML и сравните финальный URL, статус и размер ответа. |
| Нужна визуальная проверка | Разметки недостаточно для QA или архивного обзора. | Используйте рендеренный HTML для парсинга и скриншоты или PDF только для выбранных доказательств. |
Какой формат вывода лучше всего подходит после рендеринга Angular?
Рендеренный HTML является естественным выводом, когда парсеру нужны селекторы, атрибуты, ссылки, вывод компонентов, таблицы, карточки или повторяющаяся структура DOM. Но сканирование Angular не всегда должно заканчиваться HTML. Если системе на выходе нужен читаемый контент, текст или Markdown могут убрать шум разметки и уменьшить очистку. Если работа является операционной, метаданные JSON помогают объяснить статус, перенаправления, тип контента, время и размер ответа. Если работа требует визуального обзора, скриншоты и PDF могут сохранить то, как выглядела рендеренная страница.
| Вывод | Используйте это для | Специфическая ценность для Angular |
|---|---|---|
| Рендеренный HTML | Парсеры, селекторы, карточки, таблицы, ссылки, контент маршрута и отношения DOM. | Захватывает разметку после того, как Angular строит страницу. |
| Текст | Поиск, сопоставление, обобщение и компактная обработка контента. | Помогает, когда разметка компонента создает слишком много шума. |
| Markdown | AI, RAG, обзор аналитиков, документация и рабочие процессы читаемого контента. | Сохраняет полезные заголовки и ссылки после рендеринга, не раскрывая каждую деталь DOM. |
| Метаданные JSON | Отладка, журналы, мониторинг и диагностика захвата. | Показывает, достиг ли рендеренный запрос ожидаемого финального состояния. |
| Скриншот или PDF | QA, архив, одобрения и визуальные доказательства. | Подтверждает, что отображалось на странице Angular в момент захвата. |
Для более широких компромиссов по выводу сравните форматы ответов API для веб-сканирования. Для рекомендаций по рендерингу, не зависящим от фреймворка, используйте страницу JavaScript rendering API.
Как командам тестировать запрос на сканирование Angular?
Используйте представительные общедоступные URL, а не только главную страницу. Протестируйте страницу списка, страницу деталей, отфильтрованный маршрут, состояние пагинации и любой тип общедоступной страницы, который поддерживает реальный рабочий процесс. В API Builder сравните сырой HTML, рендеренный HTML, текст, Markdown, размер ответа, финальный URL, статус и тип контента. Это показывает, какие маршруты требуют выполнения в браузере, а какие могут оставаться простыми.
Когда контент отсутствует, проверьте захват перед изменением логики парсера. Странице может потребоваться пауза рендеринга, другой URL общедоступного маршрута, контекст принятого языка, маршрутизация по стране, непрерывность сессии или просто меньший объем. Сначала рассматривайте это как вопросы профиля запроса, а затем обновите правила извлечения, как только ответ страницы будет подтвержден.
Практическое замечание: настройка сканирования Angular должна тестироваться по типу маршрута, потому что одно приложение может сочетать статические, серверно-рендеренные, задержанные и полностью клиентские страницы.
Как ScraperFly делает сканирование Angular практичным?
Сканирование Angular может стать дорогим, когда каждый запрос рассматривается как полная работа браузера с дополнительными ожиданиями, визуальными файлами и более сложной маршрутизацией. ScraperFly поддерживает более дисциплинированный путь. Начните с исходного ответа, включите рендеринг только там, где это улучшает полноту, а затем выберите самый маленький формат вывода, который может использовать ваш рабочий процесс.
Это делает простые страницы Angular доступными, при этом предоставляя более сложным маршрутам чистый путь обновления. Используйте кредиты по мере необходимости, пока поведение и объем цели все еще подтверждаются, затем переместите предсказуемую повторяющуюся работу на месячные кредиты, когда шаблон станет ясным. Страница цены и калькулятор стоимости кредитов помогают сопоставить вес запроса с реальными выборами захвата.
Где сканирование Angular вписывается в другие страницы фреймворка?
Та же логика, основанная на доказательствах, применяется ко всем современным фронтенд-фреймворкам, но детали различаются по маршрутизации, стратегии рендеринга, гидратации и поведению загрузки данных. Если проект включает несколько фронтенд-целей, сравните Angular с API для сканирования React, API для сканирования Vue и API для сканирования SPA.
ScraperFly сохраняет уровень захвата последовательным для этих целей. Ваше приложение может тестировать каждую общедоступную страницу, выбирать необходимые элементы управления и держать специфическую для фреймворка логику парсинга вне инфраструктуры запросов.







