






Отрисовка React
Сравните исходный HTML с отрисованным выводом перед скрапингом приложения
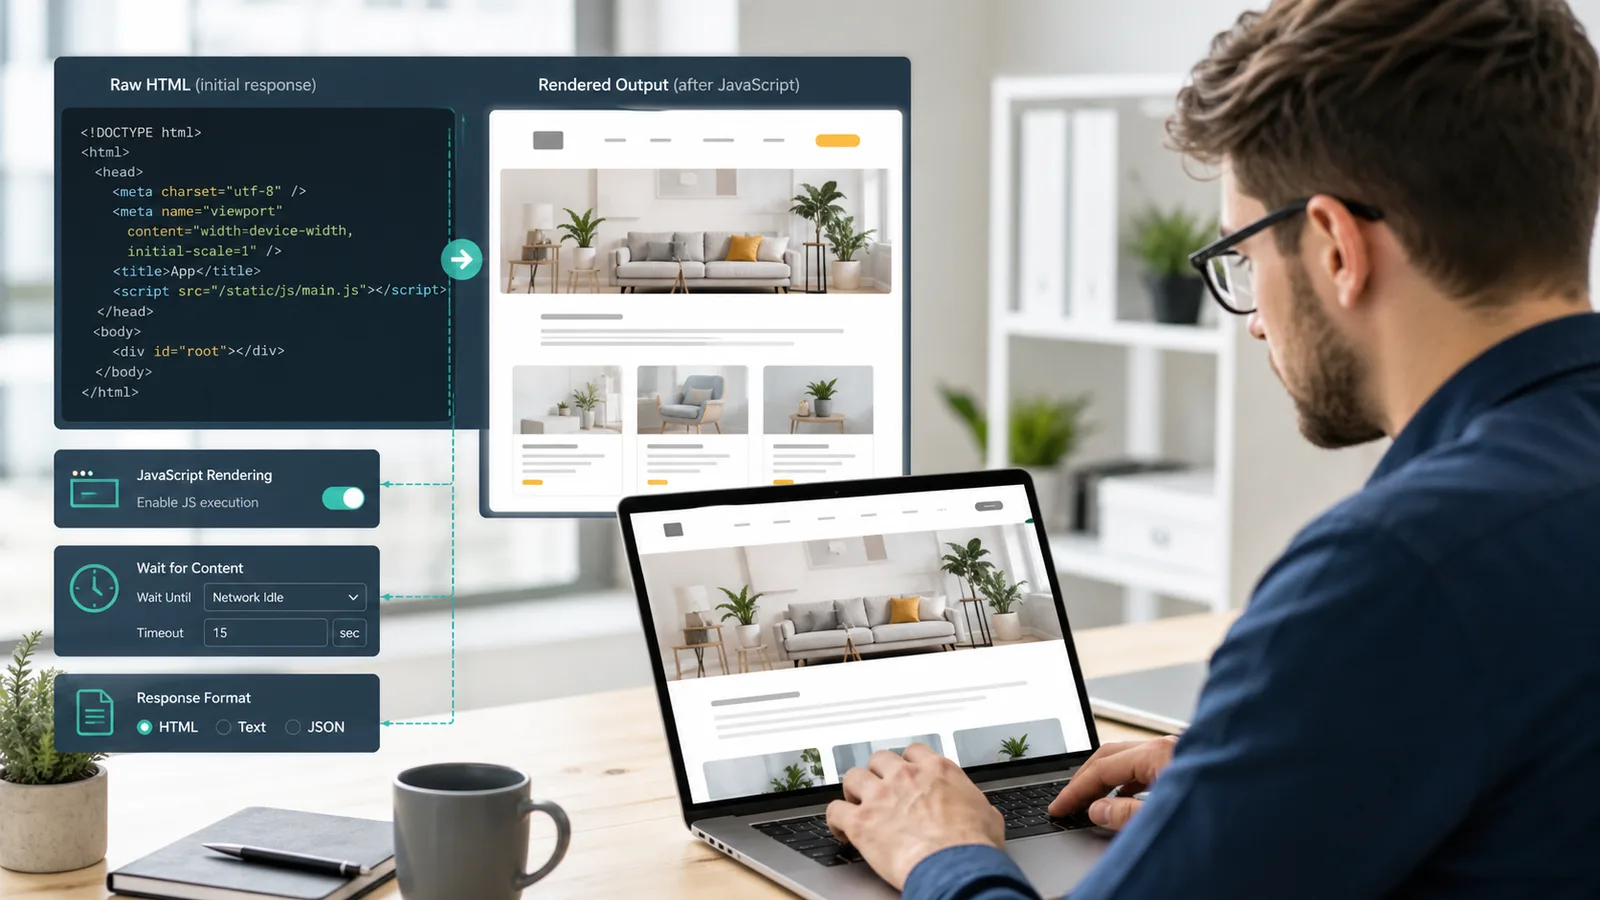
Сайты на React могут выглядеть завершенными в браузере, в то время как первый HTML-ответ содержит только небольшую оболочку приложения. ScraperFly помогает командам доказать эту разницу, прежде чем они создадут логику парсера, очереди рабочих процессов или инфраструктуру браузера вокруг неправильного ответа.
Начните с исходного HTML, проверьте, что на самом деле возвращает целевой ресурс, затем включите отрисовку в браузере, ожидания, сессии, заголовки, маршрутизацию по странам или визуальный вывод только тогда, когда отрисованная страница React предоставляет вашему рабочему процессу более убедительные доказательства.
Почему сайты на React отличаются в скрапинге?
Сайты на React часто отделяют первый ответ сервера от страницы, которую в конечном итоге видит пользователь. Исходный HTML может содержать корневой элемент, теги скриптов, метаданные маршрутов, данные гидратации или небольшую заглушку. Полезные карточки продуктов, разделы статей, результаты поиска, цены, таблицы, отзывы, фильтры или контент профиля могут появиться только после выполнения JavaScript в браузере.
Это не означает, что каждая страница React требует самого тяжелого профиля скрапинга. Некоторые приложения на React все еще раскрывают полезные метаданные, встроенное состояние, контент, отрисованный на сервере, или структурированные полезные нагрузки в начальном ответе. Другим нужен отрисованный HTML, потому что контент создается на стороне клиента. Практический рабочий процесс заключается в сравнении обоих состояний перед тем, как решить, как страница должна быть захвачена.
Практическое резюме: Скрапинг React должен начинаться с доказательств, а не предположений о том, нужна ли странице отрисовка в браузере.
Что следует проверить перед отрисовкой страницы React?
Первой проверкой является исходный ответ. Ищите полезный контент, а не просто успешный код состояния. Ответ 200 все еще может быть пустой оболочкой, если страница ожидает, что браузер получит данные, гидратирует компоненты и построит окончательный DOM. Проверьте тело, размер ответа, полезные нагрузки скриптов, метаданные, окончательный URL и то, появляются ли целевые поля в HTML, который получает ваш парсер.
Если исходный HTML уже содержит необходимые поля, оставьте запрос простым. Если исходный HTML не содержит полезного контента, сравните отрисованный вывод. Если отрисованный вывод изменяет DOM значимым образом, отрисовка оправдана. Если отрисованный вывод все еще пуст, проблема может заключаться в тайминге, маршрутизации, заблокированных ресурсах, плохом маршруте, недоступном публичном контенте или странице, которая требует другого рабочего процесса.
| Сигнал React | Что это означает | Лучший следующий шаг |
|---|---|---|
| Исходный HTML содержит целевой контент | Страницу, вероятно, можно захватить без отрисовки в браузере | Используйте легкий HTML-запрос и создайте парсер на основе исходных доказательств. |
| Исходный HTML в основном состоит из корневого элемента и скриптов | Страница, вероятно, создает полезный контент в браузере | Проверьте отрисованный HTML перед написанием логики извлечения. |
| Отрисованный DOM содержит целевые поля | Выполнение JavaScript изменяет результат скрапинга | Используйте отрисовку для этого типа страницы и запишите, почему это необходимо. |
| Отрисованная страница все еще неполная | Проблема может заключаться в тайминге, контексте запроса, маршрутизации или поведении цели | Проверьте время ожидания, статус, окончательный URL, размер ответа и визуальные доказательства. |
| Визуальная страница отличается в зависимости от региона или состояния | Маршрут может зависеть от местоположения, файлов cookie, заголовков или непрерывности сессии | Добавьте контекст целенаправленно, а не делайте каждый запрос более тяжелым. |
Когда ScraperFly должен отрисовать сайт на React?
Включите отрисовку, когда полезный публичный контент появляется после выполнения JavaScript на стороне клиента. Общие примеры включают сетки продуктов React, результаты поиска, панели управления с публичными данными, страницы статей на основе маршрутов, ленивые секции, виджеты отзывов, блоки цен, фильтры и страницы, где первый HTML-ответ содержит заглушки вместо окончательного контента.
Отрисовка должна быть точной. Не включайте ее просто потому, что сайт использует React; включайте ее, потому что сырой ответ не содержит того, что нужно рабочему процессу, а отрисованный ответ содержит. Это позволяет простым страницам оставаться быстрыми и доступными, при этом предоставляя страницам, построенным в браузере, необходимую среду.
Для более широких решений по захвату браузера используйте руководство по API отрисовки JavaScript и страницу API скрапинга безголового браузера. Для целей с приоритетом на исходный код сравните подход API скрапинга HTML перед тем, как сделать отрисовку по умолчанию.
Какой формат вывода лучше всего подходит после отрисовки React?
Отрисованный HTML является лучшим выбором, когда вашему парсеру нужны окончательный DOM, селекторы, атрибуты, ссылки, таблицы, карточки продуктов или контент маршрутов. Текст и Markdown лучше, когда страница React должна подавать данные для поиска, резюме, контекста AI, обзора документации или поглощения RAG без шумов в макете. JSON-метаданные полезны для ведения учета доказательств запроса. Скриншоты и PDF полезны, когда человеку нужно подтвердить, как выглядела отрисованная страница.
Этот выбор должен быть сделан до создания конвертеров. Скрапинг React, который подает данные парсеру, может потребовать отрисованного HTML. Скрапинг React, который подает данные LLM, может быть лучше в формате Markdown. Рабочий процесс мониторинга может потребовать метаданные плюс скриншот. Рабочий процесс соблюдения или контроля качества может потребовать PDF. ScraperFly позволяет запросу возвращать форму, которую может использовать последующая система немедленно.
| Рабочий процесс React | Вывод для тестирования | Почему это помогает | Когда этого следует избегать |
|---|---|---|---|
| Парсинг DOM | Отрисованный HTML | Возвращает страницу после того, как React создает полезную разметку | Когда исходный HTML уже содержит целевые поля. |
| Поглощение контента | Текст или Markdown | Удаляет большую часть шумов в макете перед обработкой поиска или AI | Когда важны точные селекторы или отношения DOM. |
| Диагностика | JSON-метаданные | Показывает статус, окончательный URL, тип контента, размер ответа и контекст запроса | Когда рабочий процесс ожидает извлеченные целевые поля самостоятельно. |
| Визуальный контроль качества | Скриншот | Подтверждает, как выглядела отрисованная публичная страница | Когда рабочий процесс нуждается только в текстах, читаемых машиной. |
| Архив или одобрение | Создает переносимый отчет для обзора | Когда контент требует частого автоматизированного парсинга. |
Как следует обрабатывать ожидания, сессии, заголовки и маршрутизацию?
Страницы React могут не срабатывать по причинам, которые выглядят схожими снаружи. Странице может потребоваться дополнительное время ожидания, потому что данные загружаются после первоначальной отрисовки. Ей могут потребоваться заголовки, потому что публичный маршрут ожидает языкового или контекстного контента. Ей могут потребоваться сессии, потому что связанные запросы зависят от общих файлов cookie или состояния. Ей может потребоваться маршрутизация по странам, потому что контент меняется в зависимости от региона, валюты или доступности. Ей может потребоваться более сильная доставка, когда простой путь многократно возвращает непригодный вывод.
Правильный ответ не в том, чтобы включать все. Добавляйте один контроль за раз и сравнивайте результат. Если ожидание исправляет отсутствие контента, запишите причину времени. Если сессии изменяют ответ, сохраняйте их только для этого связанного потока. Если регион меняет страницу, сохраняйте маршрутизацию по странам, привязанную к цели. Рабочий процесс скрапинга React проще всего управлять, когда каждый включенный контроль имеет видимую причину.
Используйте сессии для состоящих публичных потоков, пользовательские заголовки для законного контекста запроса и контроль маршрутизации, когда путь доставки изменяет результат.
Какие сбои распространены при скрапинге сайтов на React?
Наиболее распространенный сбой заключается в том, чтобы рассматривать пустой исходный ответ как целевую блокировку, когда на самом деле это просто нормальная оболочка React. Другой распространенный сбой — это слишком быстрая отрисовка и захват страницы до завершения загрузки данных на стороне клиента. Команды также сталкиваются с перенаправлениями маршрутов, контентом, который меняется в зависимости от региона, избыточными ответами, отсутствующими публичными данными, неподдерживаемыми вариантами вывода и рабочими процессами, которые ожидают, что API автоматически извлечет состояние приложения.
Хорошая обработка ошибок позволяет держать эти случаи отдельно. Сравните исходный HTML, отрисованный HTML, состояние скриншота, окончательный URL, статус, размер ответа и время ожидания. Исправьте неправильно сформированные входные данные и неподдерживаемые опции, вместо того чтобы повторно их пробовать. Повторяйте временные сбои с ограниченным откатом. Эскалируйте маршрутизацию только тогда, когда повторные доказательства показывают, что простой путь недостаточен.
Блок обработки ошибок ниже предоставляет более широкую структуру для сбоев. Для страниц React ключевым моментом является различение "браузер еще не построил страницу" от "цель вернула плохую страницу" и "профиль запроса неправильный".
Как скрапинг React может оставаться доступным?
Отрисовка мощная, но работа браузера тяжелее, чем простой HTML-запрос. Стоимость остается предсказуемой, когда команды классифицируют цели перед масштабированием: сырой HTML-страницы, отрисованные страницы React, страницы, которые требуют ожиданий, региональные маршруты, потоки, зависящие от сессий, визуальные захваты контроля качества и архивы PDF. Каждый класс должен иметь свой собственный профиль запроса, а не наследовать один дорогой по умолчанию.
Вот где путь ScraperFly практичен. Начните бесплатно, протестируйте реальные страницы React, держите простые захваты легкими и используйте более тяжелые контроли только там, где они изменяют ответ. Одноразовый проект может оставаться гибким с кредитами, в то время как повторяющиеся отрисованные рабочие нагрузки могут перейти на ежемесячный план, как только профиль будет подтвержден.
Просмотрите цены после тестирования реальных целей, а не до. Полезная оценка основана на том, сколько страниц действительно нуждаются в отрисовке, ожиданиях, визуальном выводе, сессиях или более сильной доставке.
С чего должна начать команда?
Начните в API Builder с одного публичного URL на React. Сначала запросите исходный HTML. Если полезный контент отсутствует, включите отрисовку и сравните результат. Затем выберите формат ответа, который может использовать ваш рабочий процесс: отрисованный HTML для парсеров, текст или Markdown для читаемого контента, JSON-метаданные для диагностики, скриншот или PDF для визуальных доказательств.
Как только профиль запроса будет подтвержден, переместите его в cURL, Python, Node.js, очередь на сервере, задачу мониторинга или рабочий процесс агента. Держите профиль явным, чтобы будущие сбои могли быть диагностированы на основе доказательств, а не догадок.












