






ScraperFlyAPI de datos web lista para IA

request control

Respuesta HTML vacía en flujos de trabajo de Web Scraping API

Una respuesta HTML en blanco o delgada no siempre significa que el raspado haya fallado. Puede ser un shell de JavaScript, redirección, bloqueo suave, brecha de tiempo, retroceso regional o desajuste de formato. ScraperFly ayuda a los equipos a inspeccionar la evidencia de respuesta antes de agregar controles de solicitud más pesados.

Triage de respuesta vacía

Tratar el HTML vacío como evidencia antes de hacer la solicitud más pesada

Una respuesta HTML vacía es una señal, no un diagnóstico final. El cuerpo de origen puede ser una delgada shell de JavaScript, una redirección puede haber aterrizado en un marcador de posición, una página de consentimiento o regional puede haber reemplazado el contenido, o el objetivo puede haber devuelto un bloqueo suave que parece una solicitud exitosa en la superficie.

ScraperFly ofrece a los equipos un camino práctico de depuración: inspeccionar la respuesta en bruto, compararla con la salida renderizada, verificar el estado y el tamaño de la respuesta, y luego agregar renderizado, esperas, sesiones, encabezados, enrutamiento por país o entrega premium solo cuando la evidencia apunta allí.
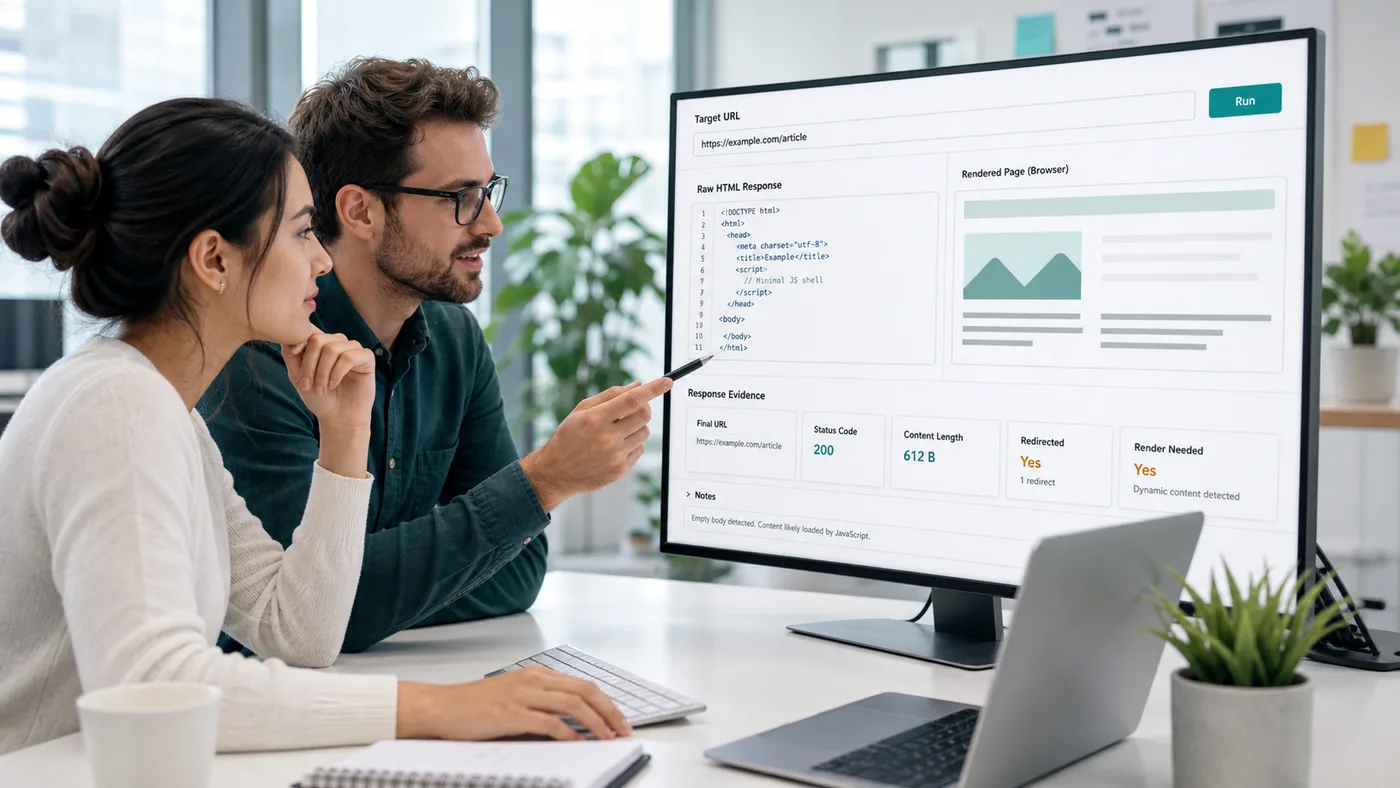
HTML en bruto HTML renderizado URL final tamaño de respuesta
Desarrolladores diagnosticando una respuesta vacía de la API de scraping HTML con HTML en bruto, salida renderizada y evidencia de respuesta

¿Qué significa generalmente una respuesta HTML vacía?

Un flujo de trabajo de scraping puede recibir muy poco HTML por varias razones diferentes. Algunas son normales: las páginas modernas a menudo envían primero una shell de aplicación y construyen contenido visible después de que se ejecuta JavaScript. Algunas son problemas de forma de solicitud: la URL final cambió, la página requiere una cookie o un idioma aceptado, o el parser está leyendo el formato de respuesta incorrecto. Algunas son señales de entrega: el objetivo devolvió una página de desafío, un cuerpo de bloqueo, una respuesta de límite de tasa, o un desajuste regional.

El primer error es tratar cada cuerpo vacío como el mismo fallo. Un buen flujo de trabajo separa la captura de origen de la captura renderizada, la entrega de red del comportamiento del objetivo, y la lógica del parser de la evidencia de la solicitud. Eso mantiene la depuración rápida y evita que los equipos agreguen controles costosos antes de saber qué control importa.

Conclusión práctica: un resultado que parece en blanco debería iniciar un paso de diagnóstico, no un bucle de reintento automático.

¿Qué deberían inspeccionar los equipos antes de reintentar?

La depuración de respuestas vacías funciona mejor cuando el equipo observa la evidencia de la solicitud en un orden estable. Comienza con los hechos que son baratos de recopilar, luego decide si una segunda solicitud debería renderizar JavaScript, esperar más tiempo, mantener el estado, cambiar el enrutamiento, o devolver una prueba visual.

Evidencia Lo que puede revelar Próxima acción
URL final La solicitud puede haber redirigido lejos de la página esperada. Compara la URL final con la URL objetivo antes de analizar.
Código de estado Un 200 aún puede ser un retroceso, mientras que las respuestas 3xx, 4xx y 5xx necesitan un manejo separado. Dirige la lógica de reintento por familia de estado en lugar de reintentar todo.
Tamaño de respuesta Un cuerpo pequeño a menudo significa marcado de shell, salida de redirección, o un bloqueo suave. Almacena umbrales de tamaño y compara muestras del mismo objetivo.
HTML en bruto El origen puede ya contener contenido útil, metadatos ocultos, o solo un punto de montaje. Usa HTML en bruto cuando los datos estén presentes; renderiza solo cuando falten.
Salida renderizada La ejecución del navegador puede revelar contenido que el HTML de origen no contenía. Habilita el renderizado para objetivos que demuestren una dependencia de JavaScript.
Captura de pantalla o PDF La prueba visual puede mostrar si la página se cargó, bloqueó, redirigió, o mostró un estado vacío. Usa salida visual para depuración, QA, monitoreo y evidencia de escalación.

¿Cuándo la renderización de JavaScript soluciona HTML vacío?

La renderización de JavaScript es útil cuando la respuesta inicial contiene una shell, datos de hidratación, contenedor de ruta, o un cuerpo vacío que se vuelve significativo solo después de la ejecución del navegador. En ese caso, una solicitud de HTML renderizado puede devolver el DOM después de que se ejecuten los scripts de la página, y texto, Markdown, capturas de pantalla, o PDFs pueden capturar el estado posterior al renderizado en un formato que es más fácil de revisar.

El renderizado aún debe ser una decisión dirigida. Si el HTML de origen ya contiene los campos necesarios, una sesión de navegador agrega latencia y peso a la solicitud sin mejorar el resultado. Si el contenido aparece tarde, una espera de renderizado puede importar más que simplemente activar el renderizado. Si la página depende de la continuidad, las sesiones o encabezados pueden ser la pieza que falta en lugar del navegador mismo.

Para páginas donde la evidencia apunta a la renderización del lado del cliente, prueba la solicitud en el API Builder, compara el HTML de origen con el HTML renderizado, y luego elige el formato de respuesta que tu flujo de trabajo puede consumir. La página de API de renderización de JavaScript profundiza en cuándo vale la pena usar la ejecución del navegador.

¿Cuándo es HTML vacío una señal de enrutamiento, acceso o objetivo?

Algunas respuestas vacías no son problemas de renderizado. Un objetivo puede devolver un retroceso regional, intersticial de consentimiento, muro de inicio de sesión, página de desafío, cuerpo de límite de tasa, o un marcador de posición educado con un estado HTTP exitoso. Esos casos requieren evidencia cuidadosa antes de la escalación, porque agregar cada control a la vez hace que el flujo de trabajo sea más difícil de razonar.

Los encabezados pueden ayudar cuando el objetivo espera un idioma específico, referente, o tipo de contenido. Las sesiones pueden ayudar cuando una solicitud establece un estado que la siguiente solicitud necesita retener. El enrutamiento por país puede ayudar cuando la página pública cambia por región. El enrutamiento premium puede ayudar cuando la ruta estándar devuelve consistentemente fallos de acceso o retrocesos bloqueados. Cada control debe responder a un síntoma visible.

Síntoma Dirección probable Flujo de trabajo de ScraperFly
Shell de aplicación delgada Renderizado del navegador o espera de renderizado Compara la salida en bruto y renderizada antes de cambiar el parser.
URL final inesperada Manejo de redirección o validación del objetivo Registra la URL final y el tipo de contenido como parte del registro de respuesta.
Bloqueo suave con estado 200 Revisión de encabezados, sesión, país o enrutamiento Usa prueba de captura de pantalla y tamaño de respuesta para evitar un éxito falso.
Repetidos 429 o 5xx temporales Control de retroceso y concurrencia Reintenta fallos temporales con límites en lugar de aumentar la presión.
El parser no ve campos Revisión de formato o selector Verifica la respuesta capturada antes de tratar la extracción como rota.

¿Cómo deberían manejar los reintentos y la lógica del parser las respuestas vacías?

Los reintentos deben ser limitados y selectivos. Errores temporales de red, respuestas 5xx de upstream, y límites de tasa pueden justificar un retroceso. URLs inválidas, opciones de salida no soportadas, claves de API faltantes, y suposiciones del parser necesitan corrección, no repetición. El HTML vacío se sitúa entre esas categorías, por lo que el flujo de trabajo debe preservar suficiente evidencia para clasificarlo.

El código del parser no debe convertir silenciosamente una captura vacía en datos incorrectos. Almacena el estado de respuesta, URL final, tamaño de respuesta, tipo de contenido, formato de salida, y si se habilitó el renderizado. Ese registro ayuda a los sistemas de monitoreo a distinguir un cambio de objetivo de un problema de infraestructura y le da a los desarrolladores una solicitud clara para probar.

Conclusión práctica: reintenta solo cuando la falla sea probablemente temporal; cambia el perfil de solicitud cuando la evidencia muestre un control faltante.

¿Cómo mantiene ScraperFly la depuración de respuestas vacías asequible?

ScraperFly está construido en torno a un camino de solicitud escalonado. Comienza con una captura ligera, inspecciona la respuesta, y luego agrega solo los controles que mejoran ese objetivo: renderizado para contenido construido con JavaScript, tiempo de espera para secciones tardías, sesiones para continuidad, encabezados para contexto legítimo, enrutamiento por país para páginas regionales, enrutamiento premium para entregas más difíciles, y salidas visuales cuando la prueba importa.

Esto mantiene el camino de compra práctico. Los equipos pueden validar el objetivo con créditos gratuitos, usar créditos de pago por uso para proyectos desiguales, y mover el trabajo recurrente a créditos mensuales una vez que el flujo de trabajo sea predecible. La guía de formatos de respuesta ayuda a elegir la forma de salida, mientras que los precios explican cómo los perfiles de solicitud más pesados afectan el costo.


Diagnóstico de respuesta.

Verifica si la página está realmente vacía o solo vacía antes de renderizar.

Una respuesta delgada aún puede convertirse en contenido renderizado útil. Compara HTML en bruto, HTML renderizado, URL final, estado, tipo de contenido, tamaño de respuesta, prueba de captura de pantalla y comportamiento de redirección antes de cambiar la lógica del parser o el peso de la solicitud.

Respuesta HTML cruda mapeada a datos visibles de la página
01

Disponibilidad de HTML crudo

Verifica si los campos que necesitas ya están presentes en la primera respuesta HTML.

Mejor primera prueba para páginas simples, artículos, documentos, listados y detalles de productos.

Comparación antes y después de la renderización de JavaScript
02

Dependencia de JavaScript

Compara HTML crudo con el DOM renderizado o captura de pantalla antes de activar la renderización del navegador.

Usa la renderización cuando el HTML crudo es solo una estructura y los scripts crean el contenido útil.

Cookies, consentimiento, contexto de sesión y acceso para scraping
03

Estado y contexto de acceso

Identifica si las cookies, el consentimiento, los límites de inicio de sesión, la paginación o el mismo estado del visitante afectan la respuesta.

Usa sesiones y encabezados cuando la continuidad cambia los datos que recibes.

Variaciones de contenido regional a través de países y rutas
04

Variación geo/contenido

Prueba si el país, idioma, moneda, inventario, SERP, anuncios o la reputación de la ruta cambian el resultado.

Usa enrutamiento geo o premium solo cuando el objetivo demuestra que la respuesta varía según la ruta.

Verificaciones antes de reintentar respuestas HTML vacías.

¿Dónde está el campo objetivo?

Encuentra si el campo existe en HTML crudo, DOM renderizado, una llamada API, datos estructurados, un archivo o un estado de interacción posterior.

¿Qué cambia la respuesta?

Muestra algunas URL y compara el estado, la URL final, la longitud del contenido, redirecciones, estados vacíos y diferencias en los resultados visibles.

¿Qué contexto se requiere?

Marca cualquier dependencia en consentimiento, localización, cookies, encabezados, límites de autenticación, paginación, filtros o solicitudes anteriores.

¿Cómo se ve el fallo?

Define las señales para respuestas bloqueadas, parciales, obsoletas, redirigidas, vacías, con tiempo de espera o desajustadas por región antes de escalar.

Cómo las respuestas vacías cambian la configuración de scraping.

Modo de obtención

La disponibilidad de HTML crudo decide si la primera solicitud puede permanecer simple o necesita renderizado, esperas, capturas de pantalla o extracción.

Contexto de la solicitud

Los requisitos de estado deciden si agregar encabezados, cookies, sesiones, manejo de consentimiento o un perfil de visitante estable.

Elección de enrutamiento

Los hallazgos geográficos y de reputación deciden si el enrutamiento estándar es suficiente o si se justifica una ruta de país/premium.

Reglas de validación

Los estados de fallo conocidos se convierten en verificaciones para reintentos, escalación, revisión de QA y decidir cuándo un perfil más ligero sigue siendo completo.

Señales de acceso.

Escalar solo cuando la respuesta vacía apunta a presión de acceso o enrutamiento.

Algunas respuestas vacías o pequeñas son señales del objetivo: un bloqueo suave, retroceso regional, página de desafío, muro de consentimiento, o cuerpo de límite de tasa. ScraperFly permite a los equipos preservar evidencia primero, luego elegir encabezados, sesiones, enrutamiento por país, o entrega más fuerte cuando la respuesta demuestra que esos controles importan.

Una solicitud HTTP simple que devuelve una respuesta HTML limpia
01

Solicitud HTML simple

Utiliza esto primero para páginas públicas que ya incluyen los datos requeridos en el HTML inicial.

Una página que cambia de un contenedor HTML vacío a un DOM renderizado después de que se ejecute JavaScript
02

Renderizado de JavaScript

Habilita el renderizado cuando el servidor devuelve un contenedor, pero el contenido útil de la página aparece solo después de que se ejecute JavaScript.

Encabezados, cookies y estado de sesión preservados a través de dos solicitudes.
03

Encabezados, cookies y sesiones

Utiliza controles de estado de visitante cuando el objetivo espera continuidad entre solicitudes o devuelve contenido diferente después de que se establece el consentimiento, la localidad o el estado de navegación.

Una solicitud enrutada a través de un país seleccionado y una ruta de proxy de mayor reputación
04

Proxy premium y geográfico

Escala el enrutamiento cuando la respuesta depende del origen de la solicitud, la reputación IP o la geografía del objetivo.

Un flujo de automatización del navegador con búsqueda, filtros, desplazamiento y pasos de captura de datos.
05

Flujo de navegador

Utiliza un flujo de navegador completo cuando los datos están detrás de una interacción en lugar de una sola solicitud: cuadros de búsqueda, filtros, desplazamiento, pestañas o navegación de múltiples pasos.

Escalate when:

01

Solicitud HTML simple

la respuesta en bruto contiene los campos que necesitas, los códigos de estado son estables y el tamaño/contenido de la página no colapsa después de verificaciones repetidas.

  • Los detalles del producto, el texto del artículo, la documentación o los listados son visibles en la respuesta HTML.
  • La URL final, el estado y la longitud del contenido se mantienen consistentes en una pequeña muestra.
  • No se requiere muro de consentimiento, estado del visitante o llamada a la API del lado del cliente para los campos objetivo.
02

Renderizado de JavaScript

el HTML en bruto es mayormente marcadores de posición, el DOM renderizado contiene los campos objetivo, o los datos clave llegan a través de solicitudes del lado del cliente.

  • HTML sin procesar tiene contenedores de aplicaciones, esqueletos de carga o cuadrículas de productos vacías.
  • La inspección del navegador muestra los campos después de que los scripts terminan.
  • Las capturas de pantalla parecen correctas mientras que la respuesta HTML por sí sola está incompleta.
03

Encabezados, cookies y sesiones

la paginación, reseñas, filtros o flujos de consentimiento dependen del mismo contexto de visitante a través de múltiples solicitudes.

  • La primera solicitud establece cookies que cambian las respuestas posteriores.
  • La localidad, el consentimiento, la moneda, el carrito o el estado del filtro deben ser preservados.
  • La página redirige o se vacía cuando las solicitudes parecen sin estado.
04

Proxy premium y geográfico

la misma URL se comporta de manera diferente por región, devuelve 403/429 de una ruta, o muestra precios, disponibilidad, SERP, anuncios o datos de catálogo específicos de la ubicación.

  • El tráfico similar al de un centro de datos recibe bloqueos mientras que una ruta de mayor reputación funciona.
  • El país, idioma, moneda, inventario o resultados de búsqueda cambian según la geolocalización.
  • Las solicitudes repetidas activan límites de tasa o páginas de desafío en rutas específicas.
05

Flujo de navegador

los datos objetivo aparecen solo después de pasos de navegación similares a los de un usuario, o áreas protegidas como reseñas, perfiles, refinamientos de resultados de búsqueda, o paneles de datos especiales se comportan de manera diferente a las páginas de detalles simples.

  • Se requiere una acción de clic, desplazamiento, búsqueda o filtro antes de que aparezcan los campos.
  • Las reseñas, perfiles o páginas de resultados dinámicos se cargan en pasos separados.
  • Los intentos de obtención/renderizado más simples devuelven contenido parcial, páginas de desafío o estados inestables.

Stay lower & Credit impact:

01

Solicitud HTML simple

Stay lower: la página ya devuelve datos completos. Añadir renderizado o enrutamiento premium aquí solo añade latencia y uso de crédito sin mejorar el resultado.

Credit impact: perfil de solicitud más bajo porque evita el trabajo del navegador y el enrutamiento especial.

02

Renderizado de JavaScript

Stay lower: los campos ya están presentes en HTML en bruto. Un sitio con un diseño moderno no significa automáticamente que se necesite renderizado de JavaScript.

Credit impact: más alto que HTML simple porque se involucra el trabajo del navegador, el tiempo de espera y los recursos de la página.

03

Encabezados, cookies y sesiones

Stay lower: el contenido público es estable sin estado. No inventes sesiones para páginas que se pueden obtener limpiamente como HTML anónimo.

Credit impact: generalmente moderado; el mayor costo es la complejidad operativa y la disciplina de reintentos.

04

Proxy premium y geográfico

Stay lower: el objetivo es globalmente consistente y acepta enrutamiento normal. El enrutamiento premium y geográfico debe estar vinculado a evidencia, no utilizado como una configuración predeterminada general.

Credit impact: puede aumentar el uso de crédito y la latencia, así que aplícalo a los grupos de URL que realmente lo necesitan.

05

Flujo de navegador

Stay lower: una sola solicitud HTML o renderizada ya devuelve el objetivo. Los flujos de navegador son la herramienta más fuerte en esta escalera, no el punto de partida predeterminado.

Credit impact: el perfil de solicitud más alto porque combina tiempo de ejecución del navegador, esperas, navegación y a menudo enrutamiento más pesado.

Escalar por evidencia, no por hábito

  • Para la mayoría de los sitios web públicos, una solicitud HTML simple o un renderizado ligero de JavaScript es suficiente. Comienza allí, inspecciona la respuesta y solo entonces decide si el siguiente paso está justificado.
  • Las señales anti-bot suelen ser visibles en la respuesta: estados 403 o 429 inesperados, redirecciones repentinas, HTML pequeño o vacío, páginas de desafío, pantallas CAPTCHA, bucles de inicio de sesión o consentimiento, y contenido que desaparece después de solicitudes repetidas.
  • Grandes objetivos de alto tráfico como Amazon, Google, LinkedIn, Instagram, TikTok y los principales mercados a menudo protegen algunas superficies de manera agresiva. Pueden requerir renderizado, sesiones, enrutamiento cuidadoso o un flujo de navegador, y cada objetivo necesita su propio perfil de prueba.
  • La protección no es uniforme incluso dentro de un mismo sitio. Las páginas de producto/detalle pueden abrirse con un perfil más ligero, mientras que reseñas, perfiles, páginas de búsqueda, vistas sensibles al precio, paneles de disponibilidad o datos adyacentes a cuentas pueden requerir una escalación más fuerte.
  • La configuración de proxy geográfico y premium afecta tanto lo que recibes como cuán costoso se vuelve el perfil de solicitud. Úsalos cuando el contenido específico del país, la reputación de IP o los bloqueos repetidos demuestren que son importantes.
  • El objetivo práctico no es activar cada control de ScraperFly. El objetivo es encontrar el nivel suficiente que devuelva datos completos y repetibles mientras mantiene bajo control el uso de crédito, la latencia y los modos de falla.

Constructor de solicitudes de recuperación

Construye la siguiente solicitud en torno a la evidencia en lugar de reintentos ciegos

Comienza probando lo que regresó, luego agrega renderizado, esperas, encabezados, targeting por país, sesiones, enrutamiento premium, captura de pantalla, o salida PDF solo cuando la respuesta vacía apunta a esa solución.

RAW
Fuente.

Inspecciona primero la respuesta en bruto

Estado, URL final, tipo de contenido y tamaño de respuesta revelan si la página está vacía, redirigida, bloqueada, o simplemente construida con JavaScript.

estadotamañoURL final
JS
Renderizar

Renderizar cuando la fuente es solo una estructura vacía

La ejecución del navegador puede revelar contenido oculto detrás de la hidratación, la carga diferida o el estado de la ruta del lado del cliente.

render=trueesperar
QA
Prueba

Usa capturas de pantalla cuando la evidencia en HTML sea ambigua

La captura visual ayuda a confirmar si el objetivo se cargó, se bloqueó, se redirigió o mostró un estado vacío.

captura de pantallaprueba

Controles que ayudan a recuperar respuestas HTML vacías

url

La página objetivo devuelve HTML vacío o muy pequeño.

render

Ejecución del navegador cuando el HTML fuente carece de contenido útil.

wait

Control de tiempo para secciones que se cargan tarde.

format

La forma de salida utilizada para verificar la recuperación.

ejemplo de cURL

Genera Markdown con la misma forma de solicitud que puedes mover a producción

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Costo de recuperación

Gaste en recuperación más pesada solo después de que la respuesta muestre por qué

La renderización, esperas, sesiones, capturas de pantalla, PDFs y un enrutamiento más fuerte pueden resolver diferentes casos de respuesta vacía. Probar la siguiente solicitud útil más ligera mantiene el diagnóstico asequible y evita que una verificación de objetivo pequeño se convierta en el perfil más caro por defecto.

Una solicitud HTML ligera que devuelve una respuesta simple
01

Obtención básica

Utiliza una obtención básica cuando el HTML público ya contiene los campos que necesitas.

Perfil de solicitud más ligero; mantenlo cuando la respuesta esté completa.

Renderizado de JavaScript produciendo un DOM completo
02

Renderización

Utiliza el renderizado cuando el HTML en bruto es una estructura y JavaScript completa la página.

Perfil más pesado; úsalo solo cuando la salida del navegador cambie el resultado.

Varios requests preservando cookies y estado del visitante
03

Sesión con estado

Usa sesiones cuando las cookies, el consentimiento, la localidad o la paginación cambien la respuesta.

Perfil de estado más pesado; conservalo solo cuando la continuidad sea importante.

Enrutamiento de requests a través de rutas geo y de mayor calidad
04

Enrutamiento y geo premium

Usa enrutamiento premium o geo solo cuando el origen, país, reputación o contenido regional cambien el resultado.

Perfil de enrutamiento más pesado; aplícalo solo a objetivos que demuestren que lo necesitan.

Qué hace que la recuperación de respuestas vacías sea más pesada

Más trabajo de infraestructura

El renderizado en el navegador, las opciones de enrutamiento y las esperas más largas significan que la plataforma tiene que hacer más que devolver una simple respuesta.

Más incertidumbre del objetivo

Redirecciones, estados vacíos, límites de tasa y páginas de desafío a menudo requieren opciones de entrega más fuertes o reintentos.

Más estado que preservar

Cookies, sesiones, consentimiento y flujos de múltiples páginas añaden partes móviles que una simple obtención sin estado no tiene.

Más evidencia para devolver

Capturas de pantalla, PDFs, salida renderizada y artefactos de respuesta más ricos son útiles, pero son más pesados que el HTML simple.

Cómo mantener las ejecuciones de recuperación predecibles

Muestra antes de escalar

Prueba primero un pequeño conjunto de URL y agrupa los objetivos por el perfil más ligero que devuelva datos completos.

No renderizar por defecto

Inspecciona el HTML crudo antes de activar el renderizado. Muchas páginas públicas ya contienen los datos que necesitas.

Escalar por evidencia

Aumenta solo cuando la respuesta muestre contenido faltante, dependencia de estado, variación geo o problemas de enrutamiento.

Mide resultados útiles

Optimiza en torno a registros válidos entregados, no al volumen de requests crudos. Un perfil más ligero es mejor solo cuando se mantiene completo.

PREGUNTAS FRECUENTES SOBRE RESPUESTAS VACÍAS

Preguntas comunes sobre respuestas de scraping HTML vacías

Respuestas prácticas para equipos que deciden si una página vacía necesita renderización, contexto de solicitud, cambios de enrutamiento, prueba visual o correcciones de analizador.

Respuestas rápidas
DIAGNOSIS

Lo que significa HTML vacío

¿Por qué el cuerpo de la respuesta parecía vacío?

El objetivo puede haber devuelto un shell de JavaScript, redirección, página de consentimiento, retroceso de desafío, variante regional o una respuesta que necesita un formato de salida diferente.

¿Es suficiente un estado 200 para confiar en el resultado?

No. Una respuesta 200 aún puede ser un shell en blanco, bloqueo suave, página de retroceso o destino de redirección. Verifique la URL final, el tamaño de la respuesta y la salida visible.

RENDERING

Raw versus rendered

¿Cuándo debo habilitar la renderización?

Habilitar la renderización cuando el HTML fuente carece de contenido útil que aparece después de que se ejecute JavaScript del lado del navegador.

¿Cuándo debo evitar la renderización?

Evita la renderización cuando la respuesta fuente ya contiene los datos que tu parser necesita. Mantener las páginas simples reduce la latencia y el peso de la solicitud.

RECOVERY

Controles de la siguiente solicitud

¿Debería reintentar una respuesta vacía?

Reintenta fallos temporales con retroceso limitado, pero corrige entradas incorrectas, formatos no soportados, suposiciones del parser o contexto de solicitud faltante en lugar de repetirlos.

¿Cuándo ayudan los encabezados, sesiones o enrutamiento?

Úsalos cuando la evidencia muestra que el objetivo depende del contexto aceptado, continuidad, región o reputación de la red.

OUTPUT

Elección de prueba y formato

¿Pueden ayudar las capturas de pantalla?

Sí. Una captura de pantalla puede mostrar si la página se cargó, redirigió, bloqueó o mostró un estado vacío cuando la evidencia HTML es ambigua.

¿Qué formato debo comparar?

Compara primero HTML crudo con HTML renderizado, luego usa texto, Markdown, metadatos JSON, captura de pantalla o PDF cuando esa salida ayude al flujo de trabajo posterior.










