






Flujo de trabajo de diagnóstico 403
Separar la autorización de la API del rechazo del lado del objetivo antes de cambiar controles
Un 403 en un flujo de trabajo de scraping no es un solo problema. Puede significar que la solicitud de la API no fue autorizada, que la clave de la cuenta es inválida o está pausada, o que el objetivo público devolvió una respuesta prohibida después de que ScraperFly intentó la entrega. Esos casos necesitan diferentes soluciones.
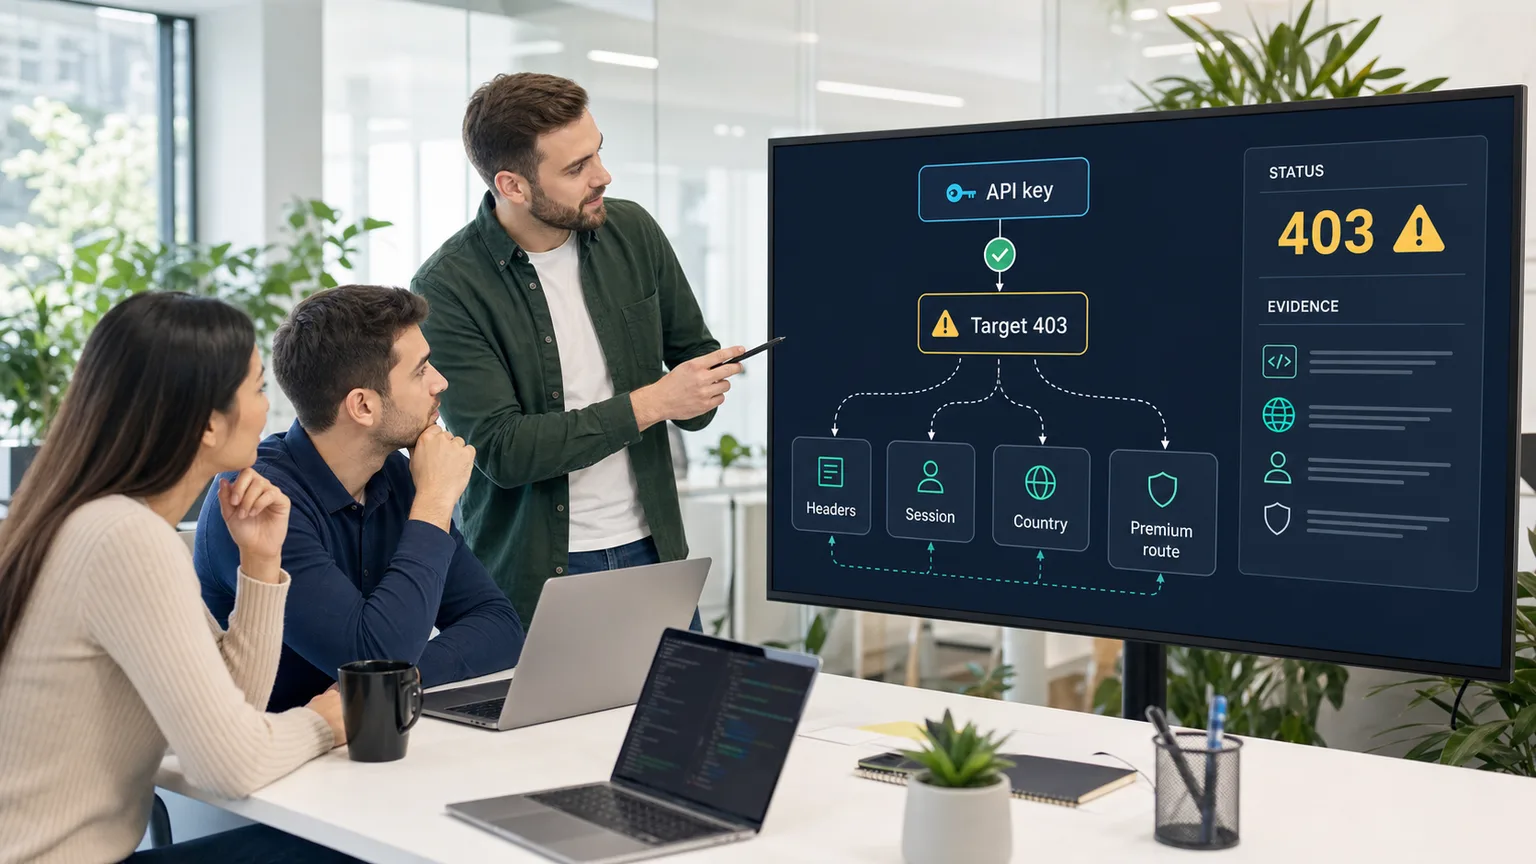
ScraperFly ayuda a los equipos a tratar el 403 como evidencia. Verifique si la falla ocurrió en la capa de la API o en la capa del objetivo, inspeccione la respuesta y luego agregue encabezados, sesiones, renderizado, enrutamiento por país o entrega premium solo cuando el comportamiento del objetivo haga que ese paso sea razonable.
¿Qué significa un 403 en una API de scraping?
Un 403 significa que algo rechazó el acceso, pero la pregunta importante es dónde ocurrió ese rechazo. Si falta la clave de la API, es inválida, está deshabilitada o está asociada a una cuenta que no puede hacer la solicitud, la solución es la configuración. Cambiar encabezados o proxies no ayudará porque la solicitud nunca se convirtió en un intento de entrega significativo al objetivo.
Si la llamada a la API es válida y el objetivo público devuelve un 403, la respuesta se convierte en evidencia del objetivo. Puede reflejar un contexto de solicitud faltante, comportamiento regional, una regla de objetivo más estricta, una página de desafío, una decisión de WAF, una ruta que espera continuidad o un objetivo que no expone el contenido a través de esa ruta de solicitud. El siguiente paso es el diagnóstico, no un volumen de reintentos ciegos.
Conclusión práctica: clasifique primero la fuente del 403, luego elija el cambio más pequeño que explique el comportamiento del objetivo.
¿Cómo puedes distinguir errores de autorización de la API de respuestas 403 del objetivo?
Comience con la capa que rechazó la solicitud. Los problemas de autorización de la API generalmente apuntan a credenciales, estado de la cuenta, permisos de solicitud o parámetros requeridos faltantes. Las respuestas 403 del lado del objetivo muestran que un intento de entrega llegó al objetivo público y el objetivo rechazó ese perfil de solicitud. Esos dos caminos nunca deben compartir el mismo manual de recuperación.
Para las respuestas 403 del lado del objetivo, compare algunas muestras en lugar de reaccionar a un solo evento. Observe la URL final, el estado, el tipo de contenido, el tamaño de la respuesta, el texto del cuerpo, el comportamiento de redirección, si apareció una página de desafío y si el resultado cambia con un contexto legítimo como el idioma, la continuidad de la sesión, el renderizado, el enrutamiento por país o la ruta de entrega.
| Señal 403 | Significado probable | Mejor acción siguiente |
|---|---|---|
| Clave de API faltante o inválida | La solicitud falló antes de una entrega útil al objetivo | Corrija la autenticación y la configuración de la cuenta antes de reintentar. |
| El objetivo devuelve una página 403 clara | El objetivo público rechazó el perfil de solicitud actual | Inspeccione la evidencia de la respuesta antes de cambiar controles. |
| 403 cambia por país | La página puede ser sensible a la región | Pruebe el enrutamiento por país solo para patrones de ruta afectados. |
| 403 sigue cambios de consentimiento o estado | El flujo de trabajo puede depender de la continuidad | Utilice sesiones o cookies permitidas cuando el contexto público lo requiera. |
| 403 aparece solo en páginas con mucho JavaScript | La solicitud de origen puede no reproducir la ruta visible en el navegador | Compare la salida de origen con el estado renderizado y la prueba visual. |
| 403 repetido en enrutamiento estándar | El objetivo puede requerir una calidad de entrega más fuerte | Escale el enrutamiento después de que la evidencia muestre que los controles más simples no son suficientes. |
¿Qué controles deberías probar después de un 403 del lado del objetivo?
Pruebe un control a la vez. Los encabezados son útiles cuando el objetivo espera un contexto de solicitud legítimo como el idioma, el tipo de contenido aceptado o el referer. Las sesiones son útiles cuando las páginas públicas dependen de la continuidad, preferencias, estado de consentimiento o cookies de una solicitud anterior. El renderizado del navegador es útil cuando la respuesta cambia después de la ejecución de JavaScript. El enrutamiento por país es útil cuando el contenido público difiere según la geografía. El enrutamiento premium es útil cuando la reputación de la ruta es el factor limitante.
Esa orden importa porque cada control agrega peso y complejidad. Si una página solo necesitaba un encabezado de idioma aceptado, usar un navegador con enrutamiento premium oculta el requisito real y hace que cada solicitud futura sea más costosa. Si un objetivo realmente necesita un enrutamiento más fuerte, los encabezados por sí solos no lo resolverán. Un pequeño bucle de evidencia mantiene el camino de recuperación honesto.
Utilice la API de scraping de encabezados personalizados, API de scraping web con sesiones, API de renderizado de JavaScript y API de scraping de proxy rotativo para comparar controles de solicitud antes de mover una ruta a volumen de producción.
¿Cómo debería manejar un sistema de producción los reintentos 403?
Un sistema de producción no debería reintentar cada 403 como si fuera una falla temporal de red. La política de reintentos debería estar vinculada a la evidencia. Problemas temporales de transporte, patrones de límite de tasa o inestabilidad en la parte superior pueden justificar reintentos limitados con retroceso. Una respuesta 403 estable generalmente necesita clasificación y un cambio en el perfil de solicitud, no más copias de la misma solicitud.
Registre la evidencia de la respuesta con la ruta del objetivo, el perfil de solicitud, la URL final, el estado, el tamaño de la respuesta y los controles elegidos. Eso convierte el manejo del 403 en un sistema de decisión. Con el tiempo, su equipo puede identificar clases de ruta: páginas que funcionan con HTML básico, páginas que necesitan encabezados, páginas que necesitan renderizado, páginas que necesitan enrutamiento por país y páginas que no valen la pena escalar por el valor que devuelven.
| Paso de recuperación | Úselo cuando | Manténgalo controlado por |
|---|---|---|
| Corregir la autorización de la API | La clave falta, es inválida, está pausada o no está autorizada | Comprobando primero la configuración de la cuenta y la solicitud. |
| Agregar encabezados permitidos | El objetivo público espera un contexto claro de idioma o contenido | Reenviando solo los encabezados que realmente necesita el flujo de trabajo. |
| Usar sesiones | Las solicitudes relacionadas dependen de un estado público compartido | Limitando las sesiones a clases de ruta con requisitos de continuidad. |
| Renderizar la página | El contenido útil o el comportamiento del objetivo aparece después de la ejecución de JavaScript | Comparando la salida de origen y renderizada antes de habilitar el navegador. |
| Usar enrutamiento por país | El contenido público o las reglas de acceso difieren por región | Probando los países afectados en lugar de cambiar cada solicitud. |
| Escalar la entrega | El enrutamiento estándar devuelve repetidamente respuestas de objetivo inutilizables | Aplicando un enrutamiento más fuerte solo a patrones de objetivo difíciles. |
¿Cuándo no vale la pena escalar un 403?
Algunos objetivos son costosos de recuperar en relación con su valor. Si la página no es pública, requiere una cuenta, bloquea el acceso automatizado bajo sus reglas o solo devuelve contenido útil después de una frágil cadena de contexto, la escalación puede no ser la decisión comercial correcta. Un sistema de scraping confiable debería saber cuándo detenerse así como cuándo agregar controles.
Ahí es donde el flujo de trabajo basado en evidencia de ScraperFly ayuda. Puede probar la ruta, comparar formas de respuesta, estimar el peso de la solicitud y decidir si el objetivo justifica el renderizado, las sesiones, el enrutamiento por país, la entrega premium, las capturas de pantalla o los PDFs. Una página que no justifica el camino más pesado no debería definir el perfil predeterminado para cada otro objetivo.
¿Cómo facilita ScraperFly el manejo de 403?
ScraperFly proporciona a los equipos una capa de API para controles de solicitud y evidencia de respuesta. En lugar de ensamblar clientes HTTP en bruto, trabajadores de navegador, grupos de proxies, lógica de reintentos, registro, capturas de pantalla y convertidores, su equipo puede probar el camino del objetivo, inspeccionar el resultado y cambiar el perfil de solicitud deliberadamente.
Utilice el API Builder para comparar una solicitud simple con controles de recuperación específicos. Comience con el perfil útil más ligero, luego agregue encabezados, sesiones, renderizado, enrutamiento por país o entrega premium cuando la evidencia indique que ese control cambia la respuesta. La página de precios y el calculador de costos de crédito de API de scraping web ayudan a mantener esas decisiones conectadas al costo antes de que el volumen crezca.
Conclusión práctica: el manejo de 403 debería hacer que la siguiente acción sea más clara: corregir la autorización, ajustar el contexto legítimo, renderizar cuando el estado del navegador importa, enrutarse cuando la geografía o la reputación importan, o detenerse cuando la escalación no vale la pena.












