






Evidencia de reseñas
Captura reseñas con el contexto que las hace confiables
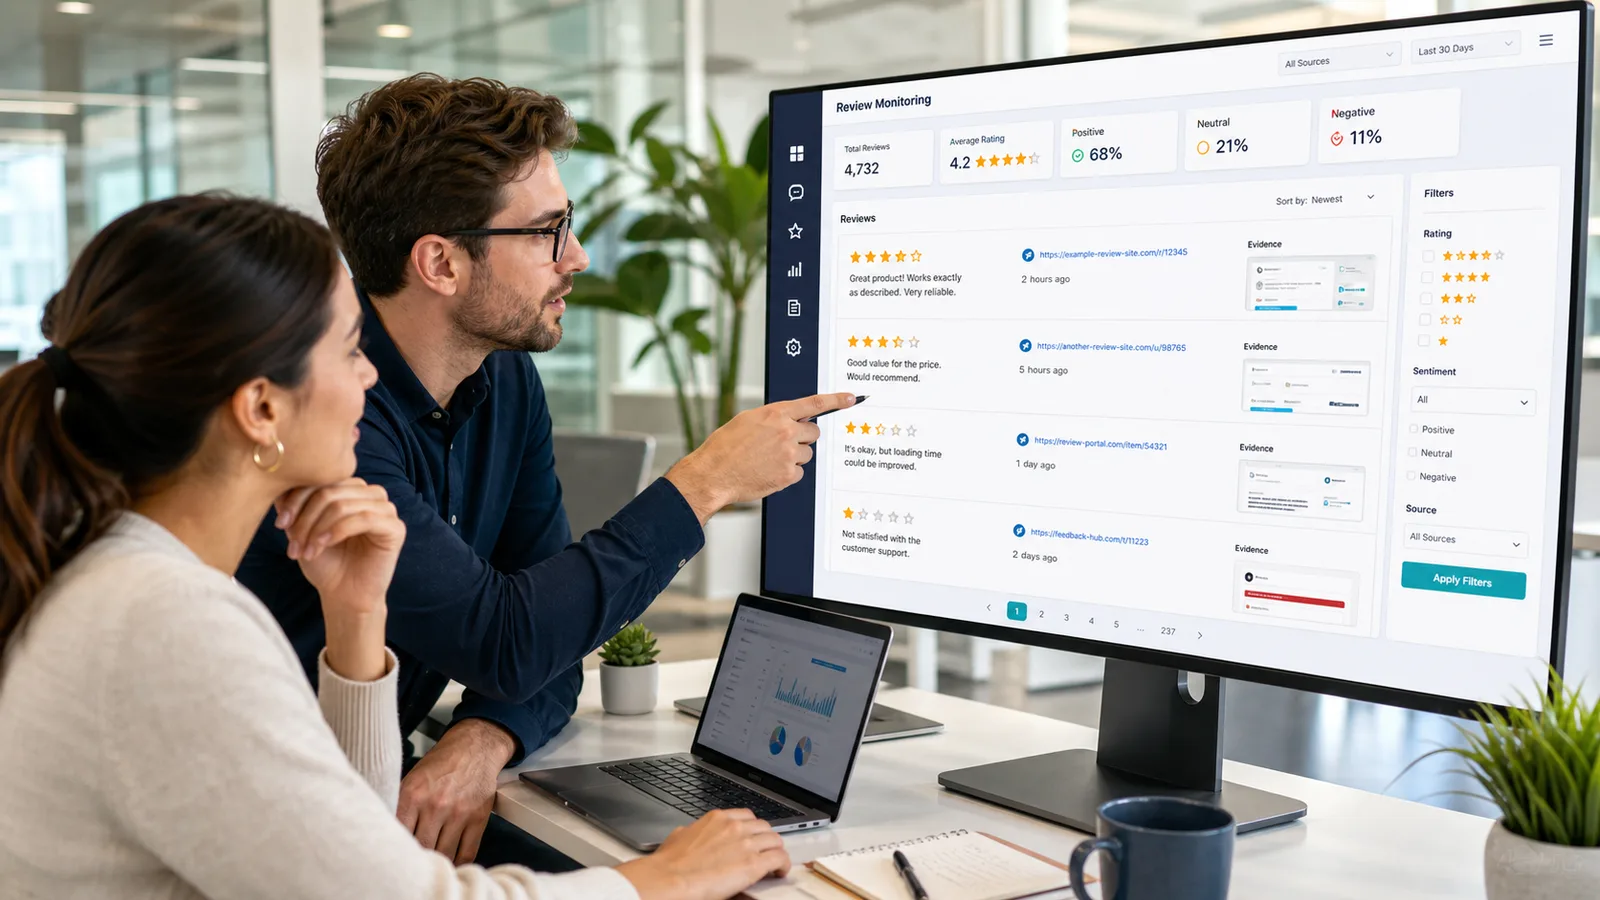
El monitoreo de reseñas no es solo un contador de estrellas. Los equipos necesitan el texto de la reseña pública, la calificación, la fecha, la URL de origen, el contexto del producto o ubicación, el estado de paginación, el idioma y suficiente evidencia para entender si un cambio es real.
ScraperFly proporciona a los equipos una capa de captura práctica para páginas de reseñas públicas. Comienza con la respuesta más ligera, inspecciona la fuente, añade renderizado o enrutamiento solo cuando la página de reseña demuestra que los necesita, y envía evidencia más limpia a tu flujo de trabajo de monitoreo, reputación, retroalimentación de productos o informes.
¿Qué es una API de web scraping para monitoreo de reseñas?
Una API de web scraping para monitoreo de reseñas captura páginas de reseñas públicas y devuelve la evidencia de la página que tu aplicación puede inspeccionar, analizar, comparar, archivar o enrutar a sistemas posteriores. La respuesta puede ser HTML en bruto, HTML renderizado, texto legible, Markdown, metadatos JSON, una captura de pantalla, un PDF, o otro formato soportado dependiendo de cómo se comporte la fuente de la reseña.
La API no reemplaza tu capa de inteligencia de reseñas. Tu producto aún posee la puntuación de sentimiento, deduplicación, reglas de alerta, flujos de trabajo de respuesta al cliente, informes de tendencias y almacenamiento. ScraperFly maneja el lado de captura de páginas públicas para que esos sistemas reciban evidencia de origen consistente en lugar de una mezcla frágil de fetchers locales, trabajadores de navegador, experimentos con proxies y convertidores únicos.
Conclusión práctica: usa una API de scraping de reseñas para recopilar evidencia pública confiable antes de que tu propio sistema decida qué cambió y qué es importante.
¿Qué campos de reseñas deberían capturar los equipos?
Un monitoreo de reseñas útil comienza con campos que ayudan a un equipo a verificar la fuente, entender la señal del cliente y comparar cambios a lo largo del tiempo. Una calificación sin texto de reseña puede ocultar la razón detrás de la puntuación. El texto de la reseña sin fecha y contexto de origen puede volverse difícil de confiar. Una captura sin estado de paginación o orden puede perder nuevas reseñas o contar viejas dos veces.
Los equipos generalmente necesitan tanto campos de negocio como campos operativos. Los campos de negocio describen la reseña en sí. Los campos operativos explican cómo se capturó la página y si el resultado es lo suficientemente confiable para comparar, alertar o archivar.
| Grupo de campos | Ejemplos | Por qué es importante |
|---|---|---|
| Señal de reseña | Calificación, título, cuerpo de la reseña, pros, contras, texto de respuesta | Muestra la retroalimentación del cliente o usuario que tu flujo de trabajo de monitoreo está destinado a rastrear. |
| Contexto de origen | Producto, ubicación, perfil, mercado, categoría, URL de origen | Mantiene cada reseña vinculada a la página pública y al objeto de negocio al que pertenece. |
| Frescura | Fecha de reseña, tiempo de captura, orden de clasificación, número de página, URL final | Ayuda a los equipos a separar nuevas reseñas de capturas reordenadas, paginadas o antiguas. |
| Evidencia de calidad | Estado, tipo de contenido, tamaño de respuesta, estado renderizado, captura de pantalla, PDF | Explica si una reseña faltante o cambiada es un evento real de origen o un problema de captura. |
¿Cómo fallan las páginas de reseñas en producción?
Las páginas de reseñas pueden parecer simples en un navegador y aún así ser inestables como fuentes de monitoreo. La clasificación puede cambiar el orden de las reseñas. Los filtros pueden ocultar calificaciones más bajas. La paginación puede cargar reseñas más antiguas de forma perezosa. La ubicación, el idioma, la moneda, las cookies o el contexto del dispositivo pueden cambiar qué reseñas son visibles. Algunas páginas muestran resúmenes en HTML de origen mientras ocultan el texto completo de la reseña detrás de JavaScript. Otras devuelven un código de estado normal con una sección de reseña vacía o parcial.
Los errores de monitoreo más costosos ocurren cuando esos comportamientos de origen se tratan como eventos comerciales. Una reseña faltante no debería convertirse automáticamente en una alerta de eliminación. Una respuesta más pequeña no debería convertirse automáticamente en una señal de reputación. Una variante regional no debería compararse con un mercado diferente como si ambas páginas fueran la misma fuente.
ScraperFly ayuda al hacer explícito el perfil de captura. Los equipos pueden inspeccionar la URL final, el estado, el tamaño de respuesta, el tipo de contenido, el HTML de origen, el estado renderizado, la prueba de captura de pantalla y el formato de salida antes de decidir si el flujo de trabajo posterior debería reintentar, escalar, ignorar o alertar.
Conclusión práctica: el monitoreo de reseñas debería comparar evidencia de origen, no solo campos extraídos.
¿Cuándo debería el monitoreo de reseñas usar renderizado de JavaScript?
Usa renderizado de JavaScript cuando el contenido útil de la reseña aparece solo después de la ejecución del navegador. Eso es común en widgets de reseñas, páginas de mercado, páginas de ubicación y páginas de productos donde la primera respuesta HTML contiene scripts, contenedores, resúmenes o marcadores de posición en lugar de la lista completa de reseñas. El renderizado puede exponer el DOM final que un usuario vería después de que la página se carga.
El renderizado aún debería ser una elección medida. Comienza capturando HTML de origen. Si la calificación, el texto de la reseña, la fecha, los controles de paginación o el estado de respuesta ya están presentes, mantén la solicitud ligera. Si faltan o están incompletos, compara la salida renderizada y añade esperas solo cuando el tiempo cambie el resultado. Para decisiones más profundas del navegador, conecta esta página a la API de renderizado de JavaScript y a las guías de API de scraping de navegador sin cabeza.
¿Cómo deberían los equipos manejar la paginación, clasificación y páginas de reseñas regionales?
El monitoreo de reseñas necesita condiciones de captura repetibles. Si una ejecución utiliza clasificación de más nuevo a más antiguo y otra utiliza clasificación por relevancia, las reseñas extraídas pueden verse diferentes incluso cuando la fuente no ha cambiado. Si un mercado muestra reseñas locales y otro mercado muestra reseñas globales, compararlas directamente puede crear un movimiento falso. Si la paginación es inconsistente, los trabajos recurrentes pueden omitir reseñas más antiguas o reprocesar las mismas.
Construye el flujo de trabajo en torno a las clases de origen. Las páginas de reseñas de productos, las páginas de reseñas de ubicación, las páginas de vendedores de mercado, las listas de tiendas de aplicaciones y las páginas de testimonios pueden necesitar un perfil de solicitud diferente. Rastrea el patrón de URL, el modo de clasificación, el idioma, el país, el método de paginación y el comportamiento renderizado para cada clase. Luego elige si tu sistema posterior debería monitorear solo la primera página, rastrear múltiples páginas, seguir enlaces siguientes o usar instantáneas como evidencia de reseña.
¿Cuál es el mejor formato de respuesta para el monitoreo de reseñas?
El mejor formato de respuesta depende de lo que sucede después de la captura. HTML es útil cuando tu analizador necesita selectores, atributos, datos incrustados o estructura DOM. Texto y Markdown son útiles cuando los equipos necesitan contenido legible para reseñas, resúmenes, triaje asistido por IA o búsqueda interna. Los metadatos JSON ayudan en la depuración y el registro porque preservan el contexto de la solicitud, como estado, URL final, tipo de contenido y tamaño de respuesta. Las capturas de pantalla y los PDFs son más pesados, pero ayudan cuando un interesado necesita prueba visual de que una calificación, insignia, respuesta o estado de reseña apareció en la página pública.
La guía más amplia de formatos de respuesta es útil cuando los equipos necesitan elegir entre HTML listo para analizador, Markdown legible, metadatos, capturas de pantalla y salida PDF. Para el monitoreo de reseñas, la regla principal es simple: elige la salida más pequeña que preserve suficiente evidencia para la decisión.
| Necesidad de monitoreo | Salida útil | Regla de decisión |
|---|---|---|
| Extracción de reseñas personalizada | HTML o HTML renderizado | Usa cuando los selectores, la estructura o los datos incrustados importan. |
| Análisis de reseñas legibles | Texto o Markdown | Usa cuando los sistemas posteriores necesitan un lenguaje limpio del cliente. |
| Depuración de alertas | Metadatos JSON | Usa cuando el estado, la URL final, el tipo de contenido y el tamaño expliquen la captura. |
| Prueba para interesados | Captura de pantalla o PDF | Usa cuando un cambio de reseña necesita confirmación visual o evidencia de archivo. |
¿Cómo puede el monitoreo de reseñas mantenerse asequible?
El monitoreo de reseñas puede volverse costoso cuando cada fuente se trata como un objetivo difícil. Renderizar cada página, esperar en cada solicitud, crear capturas de pantalla para flujos de trabajo solo para máquinas, o enrutar cada captura a través de una entrega más fuerte puede añadir peso antes de que la fuente demuestre que necesita ese trabajo. Un mejor camino es clasificar las fuentes de reseñas y mantener el perfil predeterminado ligero.
Comienza con algunas URL públicas reales de cada tipo de fuente. Captura HTML de origen, inspecciona el resultado y solo añade renderizado, esperas, sesiones, encabezados, segmentación por país, enrutamiento premium, capturas de pantalla o PDFs donde mejoren la completitud o la prueba. Cuando el volumen recurrente se vuelva predecible, revisa los precios y el calculador de costo de créditos para que los trabajos de monitoreo coincidan con los perfiles de solicitud que realmente utilizan.
Conclusión práctica: mantén las páginas de reseñas simples en captura ligera y reserva controles más pesados para fuentes que demuestren que mejoran la calidad del monitoreo.
¿Cómo deberían los equipos comenzar con ScraperFly?
Comienza en el API Builder con una URL pública de reseña representativa. Captura primero HTML de origen, luego compara texto, Markdown, metadatos, salida renderizada, captura de pantalla o PDF solo cuando el flujo de trabajo necesite esas formas. Verifica si la calificación, el cuerpo de la reseña, el nombre de visualización del autor, la fecha de la reseña, la URL de origen, la paginación y el contexto de clasificación están presentes antes de construir la extracción de producción.
Una vez que el perfil de solicitud esté probado, muévelo al sistema de monitoreo posterior. Usa ScraperFly para la captura de páginas públicas, luego deja que tu propio producto maneje la deduplicación, el sentimiento, las alertas, los paneles, el historial y las reglas de negocio. Para patrones de monitoreo adyacentes, compara este flujo de trabajo con monitoreo de cambios en el sitio web, monitoreo de marca, y análisis de sentimiento.












