






ScraperFlyAPI de datos web lista para IA

use cases

Raspado web para la evidencia de monitoreo de marca

ScraperFly ayuda a los equipos a capturar menciones públicas de marcas, reseñas, listados, estados de página, metadatos de origen y pruebas visuales para flujos de trabajo de monitoreo que controlan.

Evidencia de monitoreo de marca

Captura menciones públicas con el contexto que necesitan las alertas

El monitoreo de marca se vuelve útil cuando la alerta apunta de vuelta a evidencia que su equipo puede inspeccionar: la URL de origen, la URL final, la mención visible, el texto circundante, el tipo de página, la marca de tiempo, el estado, el idioma, la captura de pantalla y la configuración de la solicitud que produjo el resultado.

ScraperFly proporciona a los equipos una capa de captura práctica para páginas públicas. Utilice texto o Markdown para alertas legibles, HTML para extracción estructurada, metadatos para registros y capturas de pantalla o PDFs cuando una mención sensible necesite prueba visual antes de que el soporte, PR o liderazgo actúen al respecto.
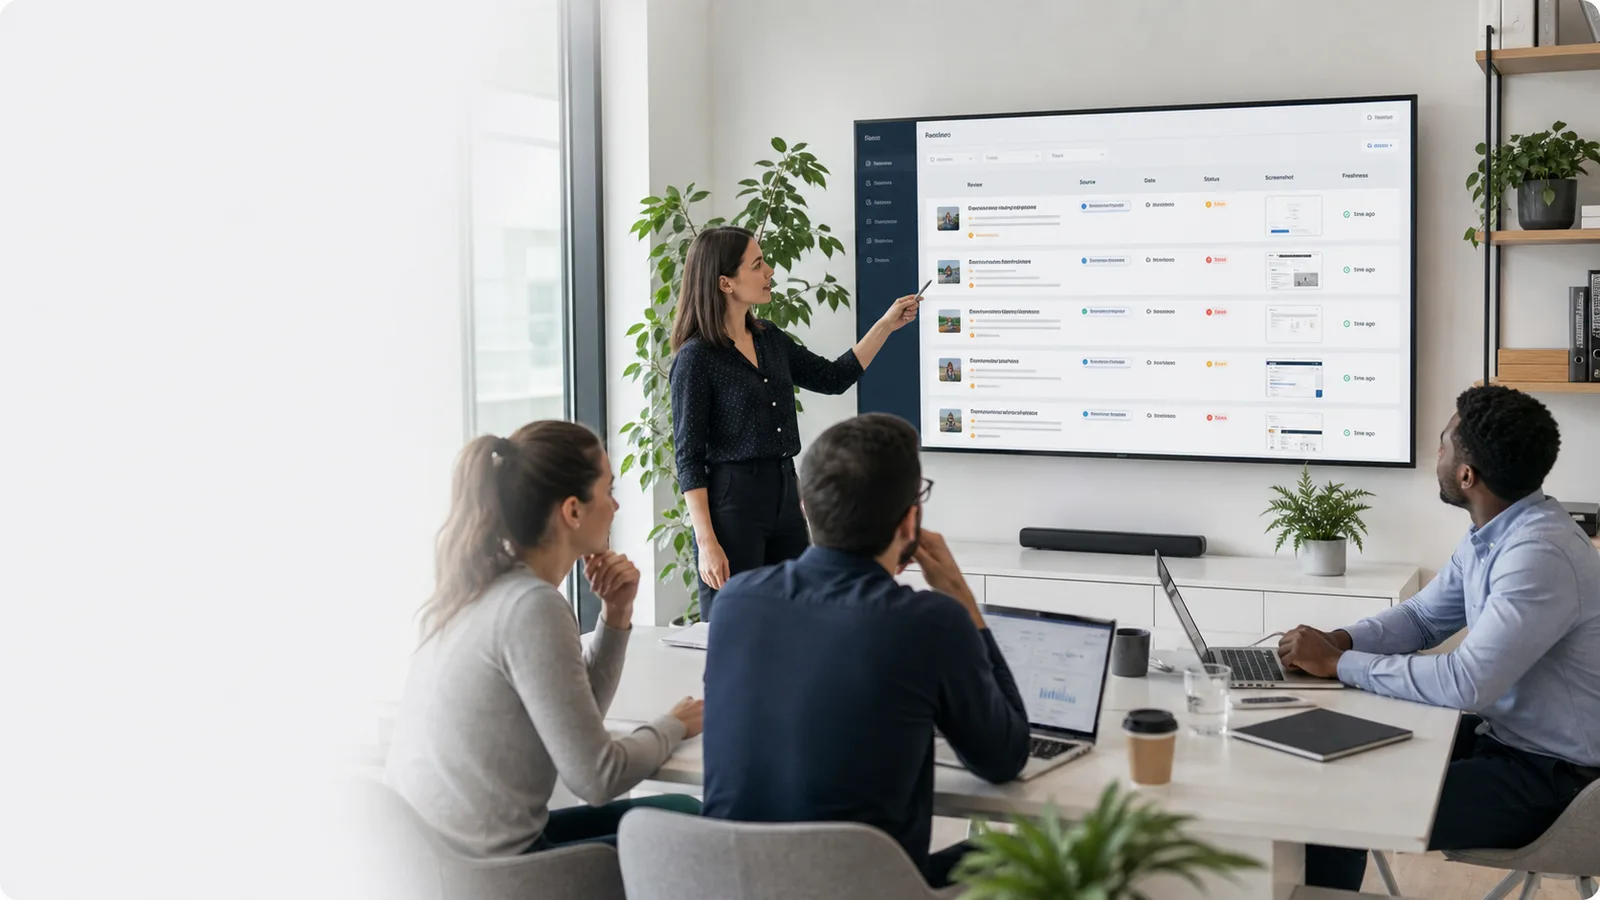
mencionesreseñasprueba de alerta
Equipo de monitoreo de marca revisando menciones públicas, páginas de reseñas, marcas de tiempo y evidencia de captura de pantalla

¿Qué es el web scraping para el monitoreo de marca?

El web scraping para el monitoreo de marca es la recopilación de páginas públicas donde aparece una marca, producto, ejecutivo, ubicación o competidor. El objetivo no es solo encontrar una palabra. El resultado útil es una alerta respaldada por la fuente que muestra dónde apareció la mención, qué decía la página a su alrededor, cuándo fue capturada y si el estado de la página es lo suficientemente confiable para revisar.

Las fuentes pueden incluir páginas de artículos, páginas de reseñas, listados de mercados, páginas de productos, directorios, páginas de negocios locales, páginas de comparación, páginas de perfiles públicos, fragmentos de resultados de búsqueda y páginas donde aparecen nombres de competidores o socios. Una API de scraping ayuda a recopilar esas fuentes públicas de manera consistente sin obligar al equipo a mantener la lógica de obtención, renderizado de navegador, enrutamiento, reintentos, convertidores, capturas de pantalla y registros para cada tipo de fuente.

Conclusión práctica: construya el monitoreo de marca en torno a la evidencia de la fuente, no solo a las coincidencias de palabras clave.

¿Qué fuentes públicas son importantes para el monitoreo de marca?

Las fuentes adecuadas dependen del riesgo y la decisión detrás de la alerta. Los equipos de PR pueden preocuparse por artículos, blogs y páginas públicas de la industria. Los equipos de soporte y producto pueden preocuparse por reseñas, listados, páginas de productos y páginas de comparación. Los equipos locales pueden preocuparse por perfiles de negocios, directorios y páginas regionales. Los equipos competitivos pueden preocuparse por páginas públicas donde se menciona una marca junto a alternativas.

Antes de escalar, pruebe cada tipo de fuente. Verifique si la mención aparece en el HTML de origen o solo después de que JavaScript renderiza la página. Confirme si la paginación cambia la muestra. Esté atento al idioma, país, redirecciones, sindicación duplicada, páginas en caché obsoletas y páginas que cambian según el dispositivo o el estado de las cookies. Esta verificación temprana de la fuente es lo que separa el monitoreo confiable de las alertas ruidosas.

Tipo de fuente Campos útiles Mejor salida de ScraperFly
Artículos y páginas públicas Título, texto del cuerpo, fecha, autor o editor, URL de origen, enlaces Texto, Markdown, HTML, metadatos
Páginas de reseñas Calificación, texto de reseña, fecha, ordenación, paginación, respuesta visible HTML renderizado, texto, captura de pantalla
Listados y directorios Nombre, dirección, categoría, teléfono, estado, región, URL de perfil HTML, metadatos JSON, captura de pantalla
Páginas de comparación y competidores Nombres de marcas, afirmaciones, menciones de características, alternativas, CTAs Markdown, texto, HTML
Menciones de alto riesgo Estado visible de la página, marca de tiempo, contexto circundante, URL final Captura de pantalla o PDF más metadatos

¿Cómo deberían las alertas de marca preservar el contexto de la fuente?

Una alerta útil debería hacer que la siguiente acción sea obvia. El revisor debería ver la mención, el texto circundante, la URL de origen, la URL final, el título de la página, el tipo de página, la marca de tiempo, el idioma, el estado, el tipo de contenido, el tamaño de la respuesta y si la captura utilizó HTML en bruto, HTML renderizado o salida visual. Sin ese contexto, los equipos pierden tiempo preguntándose si la alerta es real, obsoleta, duplicada, regional o causada por un fallo de scraping.

El contexto de la fuente también hace que los informes internos sean más claros. Un informe de PR puede citar páginas públicas. Un flujo de trabajo de soporte puede vincular a reseñas. Un equipo de producto puede comparar el lenguaje de quejas recurrentes. Una revisión de cumplimiento o liderazgo puede abrir la captura de pantalla o PDF que muestra el estado de la página en el momento de la captura. ScraperFly es útil aquí porque la misma ruta de API puede devolver salida legible y metadatos operativos juntos.

Para fuentes similares a artículos, compare la ruta de API de contenido principal de la página web cuando el texto del cuerpo sea importante. Para monitorear páginas que necesitan evidencia visual, utilice la API de captura de pantalla y PDF de la página web de manera selectiva.

¿Cuál es el mejor formato de respuesta para el monitoreo de marca?

La mayoría de los flujos de trabajo de monitoreo de marca necesitan más de un formato. El texto y Markdown funcionan bien para la detección de menciones, colas de reseñas, resúmenes y enriquecimiento ligero de alertas. HTML es mejor cuando el equipo necesita selectores, enlaces, tarjetas repetidas, tablas o estructura de página. Los metadatos JSON ayudan a registrar la URL final, el estado, el tipo de contenido, el tamaño de la respuesta y la configuración de captura. Las capturas de pantalla y PDFs ayudan cuando el estado visible es importante.

El formato debe seguir el flujo de trabajo de revisión. Un equipo de soporte que clasifica reseñas puede preferir texto limpio más enlaces de origen. Un equipo de PR puede querer Markdown con título, fecha, editor y contexto del cuerpo. Una revisión de QA o legal puede necesitar capturas de pantalla para alertas seleccionadas. Un pipeline de datos puede almacenar HTML para extracción precisa y Markdown para revisión humana. La guía más amplia de formatos de respuesta de API de web scraping ayuda a elegir esto antes de que se construyan los convertidores.

Tarea de monitoreo Salida para comenzar Cuándo agregar prueba
Alertas diarias de menciones Texto o Markdown Agregue capturas de pantalla para menciones sensibles o escaladas.
Monitoreo de reseñas HTML renderizado o texto Agregue capturas de pantalla cuando la ordenación, la visualización de calificaciones o la respuesta visible sean importantes.
QA de directorios y listados HTML más metadatos Agregue PDFs para registros instantáneos o revisión de partes interesadas.
Seguimiento de menciones de competidores Markdown o HTML Agregue captura visual cuando el diseño o la colocación comparativa sean importantes.

¿Cuándo importan el renderizado, el enrutamiento por país y las sesiones?

El renderizado importa cuando la evidencia pública de la marca se construye en el navegador. Las reseñas, listados, fragmentos y tarjetas de perfil pueden aparecer solo después de que JavaScript se ejecute. En ese caso, una API de renderizado de JavaScript puede devolver el estado de la página renderizada en lugar del HTML de origen incompleto.

El enrutamiento por país importa cuando las páginas públicas varían según el mercado, idioma, moneda, disponibilidad o redirecciones regionales. Las sesiones pueden importar cuando las páginas públicas relacionadas dependen del estado a través de solicitudes, como un estado de preferencia o consentimiento. Los encabezados pueden preservar el contexto legítimo de idioma y agente de usuario. La regla importante es simple: agregue el control cuando mejore la captura, no porque cada página monitoreada deba ser pesada.

El API Builder de ScraperFly es un buen lugar para probar esas decisiones antes de programar un monitoreo recurrente. Comience con una URL objetivo, elija la salida más pequeña y útil, compare los resultados de origen y renderizados, luego copie el perfil de solicitud en su backend o pipeline de alertas.

¿Cómo deberían los equipos reducir falsos positivos y alertas ruidosas?

El monitoreo de marca se vuelve ruidoso cuando el sistema trata cada cambio de página como un evento de marca. Una página puede redirigir, eliminar contenido antiguo, cambiar plantillas, paginar de manera diferente, duplicar texto sindicado, devolver un estado de respaldo, cargar tarde o bloquear una solicitud simple. Esos comportamientos de origen deben separarse de los verdaderos cambios de mención.

Utilice un pequeño conjunto de verificaciones de evidencia antes de la escalada: URL solicitada versus URL final, estado, tamaño de respuesta, tipo de contenido, idioma, marca de tiempo, HTML de origen, salida renderizada, fuente duplicada y estado de captura de pantalla para casos sensibles. Los fallos temporales pueden usar reintentos limitados. HTML vacío puede activar una prueba de renderizado. Respuestas repetidas 403 o 429 deben clasificarse antes de un enrutamiento más pesado. Una mención faltante puede ser un cambio de contenido real, pero debe ser probada.

Revise la página de manejo de errores de API de scraping para un modelo de recuperación más amplio. Buenas categorías de errores hacen que las alertas sean más confiables porque el equipo puede ver si un cambio provino de la fuente pública o del camino de captura.

¿Cómo encaja ScraperFly en una pila de monitoreo de marca?

ScraperFly no es un conjunto completo de monitoreo de medios con puntuación de sentimiento incorporada, paneles, flujos de trabajo de analistas o informes de PR. Es la capa de captura que alimenta esos sistemas con evidencia de páginas públicas. Eso es útil cuando un equipo ya tiene su propia analítica, cola de reseñas, almacén de datos, reglas de alertas o proceso de informes y necesita entradas web públicas confiables.

El camino de compra se mantiene práctico. Comience con créditos gratuitos y una pequeña muestra de fuentes. Mantenga páginas simples en HTML ligero, texto o Markdown. Agregue renderizado, esperas, encabezados, enrutamiento por país, capturas de pantalla, PDFs o entrega premium cuando la fuente demuestre la necesidad. Para proyectos de monitoreo desiguales, los créditos de pago por uso evitan forzar una suscripción demasiado pronto. Para fuentes recurrentes, los créditos mensuales pueden facilitar la planificación de la cadencia.

Estime la mezcla de solicitudes con el calculador de costos de créditos de API de web scraping, luego verifique los precios cuando el plan de monitoreo esté listo para escalar.


Campos de monitoreo de marca

Monitoree menciones públicas de marca con evidencia de fuente en la que su equipo puede confiar

El monitoreo de marca necesita evidencia pública revisable: menciones, páginas de artículos, páginas de reseñas, listados, páginas de productos, páginas de perfil, fragmentos, texto visible, fechas, URLs de origen, URLs finales y capturas de pantalla para casos sensibles.

Comercio

Convierte las páginas de comercio público en inteligencia de precios e inventario

Rastrea los precios de los competidores, cambios de stock, vendedores, ofertas de mercado, tarifas de viaje y cambios en el catálogo antes de que afecten los ingresos.

Laptop con gráficos analíticos para monitoreo de precios
Comercio

Monitoreo de precios de comercio electrónico

Observa los precios de los competidores, descuentos, estado de stock, términos de envío y movimientos de vendedores para que los equipos de precios puedan reaccionar antes de que los cambios en el mercado se vuelvan invisibles.

Useful fields: precio, descuento, stock, vendedor, envío

Persona navegando productos en un smartphone
Comercio

Enriquecimiento de catálogo de productos

Completa títulos, descripciones, especificaciones, imágenes, variantes e identificadores faltantes de páginas de productos públicos y catálogos de fabricantes.

Useful fields: título, descripción, especificaciones, imágenes, SKU

Pasillo de gran almacén que representa las operaciones del mercado
Comercio

Inteligencia de vendedores del mercado

Compara la presencia de vendedores, modelos de cumplimiento, profundidad de surtido, calificaciones y cambios de oferta en los mercados.

Useful fields: vendedor, calificación, oferta, cumplimiento, surtido

Trabajador de almacén organizando estantes de inventario
Comercio

Seguimiento de inventario y disponibilidad

Detecta faltantes de stock, disponibilidad de recogida, inventario regional, promesas de entrega y brechas de disponibilidad de productos antes que los clientes.

Useful fields: stock, región, recogida, entrega, marca de tiempo

Persona con bolsas de compras revisando un smartphone
Comercio

Protección de marca

Encuentra vendedores no autorizados, precios sospechosos, señales de falsificación, reclamaciones incorrectas de productos y listados riesgosos en mercados públicos.

Useful fields: vendedor, precio, reclamaciones, imágenes, mercado

Escena de restaurante y hospitalidad al aire libre ocupada
Comercio

Monitoreo de viajes y hospitalidad

Recopila disponibilidad de habitaciones, tarifas, comodidades, términos de cancelación, señales de demanda local y contexto de reseñas a través de superficies de reserva.

Useful fields: tarifa, disponibilidad, comodidades, política, calificación

Teléfono mostrando una interfaz de compras en línea
Comercio

Clasificados y seguimiento de segunda mano

Monitorea nuevos listados, precios de venta, actividad de vendedores, condición del artículo, ubicación y antigüedad de la publicación en mercados de reventa.

Useful fields: listado, precio, condición, vendedor, ubicación

Portátil mostrando gráficos financieros y análisis
Comercio

Comparación de precios y re-precio

Convierte instantáneas de precios de competidores en entradas de re-precio, brechas de surtido, alertas de margen e informes de posición en el mercado.

Useful fields: competidor, precio, rango, disponibilidad, cambio

Crecimiento

Encuentra señales de demanda antes de que aparezcan en tus propios análisis

Monitorea resultados de búsqueda, anuncios, páginas de competidores, directorios de negocios, actividad de contratación y señales de leads para ver hacia dónde se mueve la atención.

Portátil mostrando panel de análisis para monitoreo SEO
Crecimiento

Monitoreo de SERP y SEO

Rastrea posiciones, fragmentos, anuncios, paquetes locales, idioma, dispositivo y diferencias geográficas para ver cómo cambia la visibilidad en la superficie de búsqueda real.

Useful fields: rango, URL, fragmento, anuncios, geo

Laptop abierta en una página de noticias o contenido
Crecimiento

Monitoreo de contenido de competidores

Observa los cambios en la página, encabezados, CTAs, esquema, enlaces internos y el inventario de contenido sin esperar auditorías manuales.

Useful fields: encabezado, CTA, esquema, enlaces, texto actualizado

Manos sosteniendo un teléfono con contenido de redes sociales
Crecimiento

Inteligencia de anuncios

Recopila copias de anuncios públicos, patrones creativos, páginas de destino, regiones, tiempos y actividad de anunciantes para la investigación de campañas.

Useful fields: copia, creativo, página de aterrizaje, región, fecha

Personas de negocios intercambiando documentos en una oficina
Crecimiento

Generación de leads y enriquecimiento de empresas

Crea listas de cuentas y enriquece los registros de empresas con dominios, ubicaciones, industrias, contactos públicos, señales de contratación y pistas tecnológicas.

Useful fields: empresa, dominio, industria, ubicación, señales

Pequeña cafetería local en la acera
Crecimiento

Datos de directorios de negocios locales

Recopila nombres, categorías, direcciones, horarios, sitios web, calificaciones y recuentos de reseñas de páginas de directorios públicos.

Useful fields: nombre, categoría, dirección, horarios, calificación

Trabajadores de oficina revisando documentos profesionales
Crecimiento

Inteligencia del mercado laboral

Rastrear títulos de trabajo, habilidades, rangos salariales, antigüedad, políticas de trabajo remoto y velocidad de contratación en páginas de carrera y bolsas de trabajo.

Useful fields: título, salario, habilidades, ubicación, antigüedad

Voz

Convertir conversaciones públicas en señales de producto y reputación

Recopilar reseñas, menciones en medios, discusiones comunitarias, publicaciones públicas y señales de creadores para entender lo que dicen los clientes y los mercados.

Persona leyendo un periódico mientras trabaja en una computadora portátil
Voz

Monitoreo de noticias y medios

Recopilar artículos, autores, fechas, temas, entidades, enlaces y metadatos de fuentes para flujos de trabajo de reputación, investigación y alertas.

Useful fields: título, autor, fecha, fuente, entidades

Personas comprando y revisando un smartphone juntas
Voz

Seguimiento de reseñas y sentimientos

Captura tendencias de calificación, temas de quejas, patrones de elogios, respuestas de negocios y contexto de producto-ubicación de reseñas públicas.

Useful fields: calificación, reseña, tema, respuesta, fecha

Persona navegando en una aplicación de redes sociales en un smartphone
Voz

Monitoreo de redes sociales y web pública

Monitorea publicaciones públicas, participación, hashtags, marcas de tiempo y contexto de perfil donde la política y el acceso a la fuente lo permitan.

Useful fields: publicación, participación, hashtag, perfil, tiempo

Persona leyendo artículos de noticias en una habitación
Voz

Inteligencia de comunidades y foros

Encuentra preguntas recurrentes, quejas, solicitudes de funciones y lenguaje problemático de comunidades públicas y foros de soporte.

Useful fields: pregunta, tema, queja, conteo de respuestas, fecha

Espacio de trabajo con laptop, café y periódico
Voz

Descubrimiento de creadores e influenciadores

Crea listas de descubrimiento a partir de páginas de perfil público, temas de contenido, señales de audiencia, cadencia de publicaciones y señales de colaboración.

Useful fields: perfil, tema, señal de audiencia, cadencia, enlace

Registros

Facilita el monitoreo de registros públicos y listados a gran escala

Extrae licitaciones, avisos legales, presentaciones, datos financieros y listados de bienes raíces en conjuntos de datos que los equipos pueden buscar, comparar y revisar.

Profesionales intercambiando documentos comerciales
Registros

Contratación pública y licitaciones

Rastrear compradores, presupuestos, plazos, requisitos, adjuntos, adjudicaciones y cambios a través de portales de licitaciones y avisos públicos.

Useful fields: comprador, presupuesto, plazo, requisitos, adjudicación

Profesionales discutiendo documentos legales en una oficina
Registros

Monitoreo regulatorio y legal

Monitorear avisos, registros públicos, fechas efectivas, versiones de documentos, entidades afectadas y cambios relevantes para el cumplimiento.

Useful fields: aviso, entidad, fecha, documento, estado

Profesionales revisando documentos financieros
Registros

Investigación financiera y de mercados públicos

Recopila presentaciones, divulgaciones, tablas, noticias, metadatos de instrumentos y contexto financiero público para pipelines de investigación.

Useful fields: presentación, tabla, emisor, fecha, métrica

Llaves de casas y efectivo para datos del mercado inmobiliario
Registros

Listados inmobiliarios y datos del mercado

Rastrea precios de listado, direcciones, atributos de propiedad, detalles del agente, estado, historial y contexto del vecindario.

Useful fields: precio, dirección, habitaciones, agente, estado

Productos de datos

Construye productos de datos a partir de páginas raspadas, no de volcado de páginas

Limpia, normaliza, valida, enriquece, compara y entrega datos web públicos en bases de datos, paneles, alertas y pipelines de LLM.

Pantalla de laptop con código de programación
Productos de datos

Canales de datos web listos para LLM

Convierte páginas públicas en texto limpio, Markdown, fragmentos, metadatos, citas y señales de frescura para recuperación o flujos de trabajo de modelos.

Useful fields: texto limpio, Markdown, fragmento, URL de origen, marca de tiempo

Racks de servidores en centros de datos para flujos de trabajo de bases de datos
Productos de datos

Extracción estructurada a base de datos

Convierte HTML, PDFs, tablas y texto de página en registros tipados que pueden ser almacenados, consultados, unidos y auditados más tarde.

Useful fields: JSON, tipo, fuente, esquema, ID de registro

Laptop con interfaz de codificación y análisis de datos
Productos de datos

Detección de cambios y alertas

Compara instantáneas y alerta a los equipos cuando cambian precios, stock, rango, contenido, estado o lenguaje regulatorio.

Useful fields: valor anterior, nuevo valor, delta, umbral, alerta

Pantalla de computadora con código y datos coloridos
Productos de datos

Enriquecimiento y normalización de entidades

Normalizar IDs de productos, nombres de empresas, ubicaciones, personas, categorías, unidades, monedas y mapeos de taxonomía.

Useful fields: entidad, ID canónico, categoría, unidad, confianza

Primer plano de un rack de servidores con indicadores azules
Productos de datos

Validación de calidad de datos

Verifique los campos requeridos, tipos de datos, rangos, duplicados, evidencia de origen y registros sospechosos antes de su uso posterior.

Useful fields: campo requerido, tipo, rango, evidencia, confianza

Laptop con editor de código para alimentación de informes de datos
Productos de datos

Alimentaciones de informes y paneles

Alimenta paneles de BI, informes de mercado, tarjetas de puntuación operativas y análisis recurrentes con datos web que se actualizan según lo programado.

Useful fields: métrica, dimensión, período, fuente, actualizar

Por qué ScraperFly

Mantenga el monitoreo práctico con salidas flexibles y controles de solicitud visibles

Las páginas públicas simples pueden mantenerse en captura rápida, mientras que las fuentes dinámicas o resistentes pueden agregar renderizado, enrutamiento, esperas, sesiones o capturas de pantalla cuando la evidencia lo requiera.

  • Rellena los vacíos dejados por las APIsMuchas fuentes exponen páginas públicas útiles, pero no hay una API completa para los campos exactos, geos, filtros o historiales que un equipo necesita.
  • Monitorea el cambio a lo largo del tiempoLas extracciones recurrentes crean un historial de precios, contenido, disponibilidad, clasificaciones, reseñas, avisos y movimientos de mercado.
  • Compara entre fuentesEl scraping hace posible la comparación entre sitios cuando los mercados, directorios, portales y editores estructuran los datos de manera diferente.
  • Crea registros utilizablesLa salida útil no es un volcado de página; es un registro normalizado, con fuente y marca de tiempo, en el que los sistemas posteriores pueden confiar.
Mejor ajuste

Útil para seguimiento de reputación, descubrimiento de menciones, monitoreo de reseñas y alertas de contenido público

Los equipos pueden probar la calidad de la fuente, la cobertura de campos, la frescura, duplicados y necesidades de prueba antes de que el monitoreo recurrente escale.

Una API para fuentes variadas

Utiliza el mismo patrón de integración en tiendas, páginas de búsqueda, directorios, documentos, listados públicos y tuberías de productos de datos.

Controles de entrega cuando se necesitan

Renderización, sesiones, encabezados, geo y enrutamiento de proxies se pueden agregar para objetivos que los necesiten sin reconstruir el flujo de trabajo.

Salida que soporta el post-procesamiento

HTML, capturas de pantalla, texto limpio, Markdown y rutas de extracción estructuradas ayudan a los equipos a pasar de la recuperación de páginas a registros utilizables.

Menos infraestructura de scraping que poseer

Los equipos pueden centrarse en campos, validación, frescura y lógica empresarial en lugar de flotas de navegadores, casos límite de enrutamiento y plomería de reintentos.

Comportamiento de la fuente de marca

Verifique la frescura de la fuente, redirecciones, idioma, duplicados y estado de la página antes de activar alertas

Las fuentes de marca pueden cambiar según el editor, la plataforma de reseñas, el mercado, el país, el idioma, la fecha, la paginación, el comportamiento de JavaScript, la sindicación duplicada y el estado de la página en caché. La calidad de la alerta depende del contexto de captura estable.

Respuesta HTML cruda mapeada a datos visibles de la página
01

Disponibilidad de HTML crudo

Verifica si los campos que necesitas ya están presentes en la primera respuesta HTML.

Mejor primera prueba para páginas simples, artículos, documentos, listados y detalles de productos.

Comparación antes y después de la renderización de JavaScript
02

Dependencia de JavaScript

Compara HTML crudo con el DOM renderizado o captura de pantalla antes de activar la renderización del navegador.

Usa la renderización cuando el HTML crudo es solo una estructura y los scripts crean el contenido útil.

Cookies, consentimiento, contexto de sesión y acceso para scraping
03

Estado y contexto de acceso

Identifica si las cookies, el consentimiento, los límites de inicio de sesión, la paginación o el mismo estado del visitante afectan la respuesta.

Usa sesiones y encabezados cuando la continuidad cambia los datos que recibes.

Variaciones de contenido regional a través de países y rutas
04

Variación geo/contenido

Prueba si el país, idioma, moneda, inventario, SERP, anuncios o la reputación de la ruta cambian el resultado.

Usa enrutamiento geo o premium solo cuando el objetivo demuestra que la respuesta varía según la ruta.

Verificaciones antes del scraping de monitoreo de marca

¿Dónde está el campo objetivo?

Encuentra si el campo existe en HTML crudo, DOM renderizado, una llamada API, datos estructurados, un archivo o un estado de interacción posterior.

¿Qué cambia la respuesta?

Muestra algunas URL y compara el estado, la URL final, la longitud del contenido, redirecciones, estados vacíos y diferencias en los resultados visibles.

¿Qué contexto se requiere?

Marca cualquier dependencia en consentimiento, localización, cookies, encabezados, límites de autenticación, paginación, filtros o solicitudes anteriores.

¿Cómo se ve el fallo?

Define las señales para respuestas bloqueadas, parciales, obsoletas, redirigidas, vacías, con tiempo de espera o desajustadas por región antes de escalar.

Cómo las fuentes de marca cambian la configuración de monitoreo

Modo de obtención

La disponibilidad de HTML crudo decide si la primera solicitud puede permanecer simple o necesita renderizado, esperas, capturas de pantalla o extracción.

Contexto de la solicitud

Los requisitos de estado deciden si agregar encabezados, cookies, sesiones, manejo de consentimiento o un perfil de visitante estable.

Elección de enrutamiento

Los hallazgos geográficos y de reputación deciden si el enrutamiento estándar es suficiente o si se justifica una ruta de país/premium.

Reglas de validación

Los estados de fallo conocidos se convierten en verificaciones para reintentos, escalación, revisión de QA y decidir cuándo un perfil más ligero sigue siendo completo.

01 / Esquema de Extracción

Demuestra la forma de la respuesta en un remitente de API antes de escalar el raspado a miles de URLs

Antes de una gran exportación, ejecuta una solicitud real de ScraperFly en Postman, Insomnia, Hoppscotch, Bruno, Thunder Client, curl o cualquier remitente de API que tu equipo ya utilice. Agrega la clave de API, la URL objetivo, el método, el formato de salida y la configuración de entrega, luego compara el resultado esperado con la respuesta que recibes. Si la muestra regresa como el artefacto incorrecto, campos faltantes, contenido bloqueado, HTML vacío o un desajuste específico de región, ajusta HTML, texto, Markdown, PDF, JSON, renderizado, país, proxy premium, encabezados, sesiones, esperas o reintentos hasta que la respuesta esté lista para convertirse en el perfil de lote.

Una solicitud probadaEsperado vs recibidoFormato confirmadoListo para escalar
Un remitente de API limpio con clave de API, método, URL, formato de salida y controles de envío

01 / Remitente de solicitudes

Comienza en la herramienta que tu equipo ya utiliza para pruebas de API

Abre Postman, Insomnia, Hoppscotch, Bruno, Thunder Client, curl, o cualquier remitente que pueda hacer solicitudes GET, POST y PUT. El punto no es la herramienta; el punto es ejecutar el perfil de solicitud exacto una vez antes de que se convierta en un trabajo por lotes.

PostmanInsomniaHoppscotchBrunoThunder Clientcurl
Resultado esperado comparado con el resultado recibido mientras se ajustan el formato de salida, proxy premium, país y configuraciones de renderizado

02 / Esperado vs recibido

Ajusta la solicitud hasta que la salida recibida coincida con el resultado esperado

Cambia entre salida HTML, texto limpio, Markdown, PDF, JSON o captura de pantalla e inspecciona lo que regresa. Si la respuesta es incompleta, ajusta el renderizado, proxy premium, país, encabezados, sesiones, esperas o reintentos hasta que la muestra produzca el artefacto de datos que tu flujo de trabajo necesita.

  • ¿El tipo de contenido coincide con el flujo de trabajo?
  • ¿Están presentes y son legibles los campos requeridos?
  • ¿El país o el proxy premium cambian el resultado?
  • ¿El renderizado produce contenido de página faltante?
Una solicitud de muestra validada que se escala en archivos, registros de base de datos y salidas de automatización

03 / Escalar solo después de la prueba

Convierte la muestra validada en un perfil de extracción repetible

Una vez que una URL devuelve el artefacto correcto, reutiliza la misma configuración de solicitud para el conjunto de URL más grande. Eso mantiene los trabajos por lotes vinculados a un perfil conocido en lugar de descubrir errores de formato, enrutamiento o renderizado después de miles de solicitudes.

Exportaciones por lotesRegistros de base de datosAutomatizacionesEvidencia de QA
Calidad de alerta

Campos limpios hacen que las alertas de marca sean más confiables

Separe lo que dijo la página pública de cómo fue capturada y cómo el equipo lo clasificó. Eso mantiene las alertas legibles, revisables y más fáciles de enrutar.

Contexto de mención

Término de marca, texto circundante, título, tipo de fuente, idioma y sección visible de la página.

Capturar contexto

URL solicitada, URL final, marca de tiempo, estado, tipo de contenido, tamaño de respuesta, formato de salida y estado de renderizado.

Revisar contexto

Severidad de alerta, estado de duplicado, captura de pantalla, PDF, notas del revisor y propietario descendente.

Constructor de solicitudes de monitoreo de marca

Construye controles de marca repetibles con salida legible y prueba cuando las alertas importan

Usa texto o Markdown para revisión, HTML para extracción personalizada, metadatos JSON para enriquecimiento y registros, y capturas de pantalla o PDFs cuando un estado de página visible requiera evidencia.

MENT
Menciones

Captura el contexto de la mención con fuente y marca de tiempo

La evidencia de marca necesita texto visible, URL de origen, URL final, fecha, tipo de página y contexto circundante.

menciónfuentefecha
REV
Reseñas

Supervisa cuidadosamente las fuentes de reseñas y reputación

Las calificaciones, el texto de la reseña, la clasificación, el idioma, la paginación y la visibilidad de la respuesta pueden cambiar lo que ve la monitorización.

calificaciónreseñapaginación
QA
Prueba

Utiliza la captura visual para alertas sensibles

Las capturas de pantalla ayudan a confirmar menciones de alto riesgo, reclamos cambiados o estados de páginas públicas antes de la escalada.

captura de pantallaprueba

Controles que dan forma a la monitorización de marcas

url

La página pública, fuente de reseña, listado o artículo que se está monitoreando.

format

La forma de salida para alertas, enriquecimiento, análisis o prueba.

render

Ejecución en el navegador cuando la evidencia de la marca está del lado del cliente.

country

Enrutamiento regional cuando las menciones o páginas varían según el mercado.

ejemplo de cURL

Genera Markdown con la misma forma de solicitud que puedes mover a producción

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Manejo de errores

Convierte los fallos de scraping en soluciones

Cada flujo de trabajo de datos web eventualmente se encuentra con una respuesta mala: una URL faltante, una clave inválida, una estructura HTML vacía, un objetivo 403, un límite de tasa, un tiempo de espera de renderizado, una captura de PDF rota o una carga útil JSON que no contiene los campos que tu producto esperaba. ScraperFly está diseñado para hacer que esos momentos sean diagnosticables. Inspeccionas el estado HTTP, el código de error estable, el perfil de solicitud y el artefacto devuelto, luego eliges el siguiente movimiento útil más económico: corregir la solicitud, agregar créditos, desacelerar, reintentar con retroceso, habilitar el renderizado, cambiar de país, usar enrutamiento premium, preservar encabezados o validar la salida antes de escalar.

Forma de error estableDecisiones de reintentoEscalación consciente de costosValidación de salida
Desarrollador revisando código y parámetros de solicitud de API en una laptop

01 / Configuración de solicitud y acceso

Corrige primero los errores de solicitud

Algunas fallas no son problemas del objetivo en absoluto. Ocurren antes de que ScraperFly pueda hacer un intento de entrega significativo: una URL faltante o mal formada, un formato de salida no soportado, un tipo de archivo visual incompatible, una clave de API faltante, una clave inválida, o una clave que ha sido pausada o deshabilitada. Estos errores son señales de configuración, no señales de reintento: detén el flujo de trabajo, señala al desarrollador el campo exacto que necesita corrección, y mantén los créditos enfocados en pruebas reales del objetivo en lugar de entradas incorrectas repetidas.

missing_urlinvalid_urlunsupported_formatinvalid_api_key
  • Valida la URL y la codificación antes de enviar un lote.
  • Usa salidas soportadas: HTML, texto, Markdown, JSON, captura de pantalla o PDF.
  • Ajusta los tipos de archivo de captura de pantalla al tipo de salida de imagen y el tipo de archivo PDF a la salida PDF.
  • Trata las claves de API faltantes o inválidas como trabajo de configuración, no como trabajo de reintento.
Tablero de negocios con gráficos, documentos y planificación de uso en un escritorio

02 / Créditos, límites y concurrencia

Separar límites de fallos

Una carga de trabajo puede fallar porque la cuenta no tiene créditos utilizables, se ha alcanzado el límite del plan mensual, o la concurrencia es demasiado agresiva para el plan actual y la mezcla de objetivos. ScraperFly hace visibles esos límites como señales operativas, no como fallas misteriosas de raspado. Eso mantiene la decisión de compra práctica: comienza gratis, prueba el objetivo, compra créditos de pago por uso para trabajos irregulares, pasa a créditos mensuales cuando el volumen se vuelve predecible, y usa retroceso cuando la presión de solicitud es el verdadero problema.

usage_limit_reachedrate_limitedcreditsretroceso
  • Usar el estado de la cuenta para verificar créditos restantes antes de ejecuciones grandes.
  • Reintentar límites de tasa con retroceso en lugar de aumentar la presión de inmediato.
  • Mantener proyectos únicos en pago por uso cuando el volumen es desigual.
  • Mover trabajos recurrentes predecibles a créditos mensuales cuando el patrón esté comprobado.
Sala de servidores que representa rutas de entrega, enrutamiento e infraestructura de red

03 / Entrega objetivo y red

Encontrar fallos de entrega primero

Muchas plataformas de scraping colapsan los problemas de entrega en un fallo de solicitud vago. En producción, eso no es suficiente. El equipo necesita saber si la solicitud se agotó, si el objetivo ascendente devolvió un error temporal del servidor, si la conexión falló, si la respuesta fue demasiado grande, si las redirecciones fueron a algún lugar inesperado, o si la página regresó como un HTML pequeño sin contenido útil. ScraperFly convierte esos fallos en evidencia de entrega: prueba primero el perfil ligero, compara el estado y el tamaño de la respuesta, luego decide si la siguiente solicitud necesita retroceso, otra ruta, proxy premium, segmentación por país, o una captura más estrecha.

tiempo de espera5xxredireccionesrespuesta_demasiado_grande
  • Reintentar fallos temporales de red y ascendentes con una política de retroceso controlada.
  • Comparar URL final, estado, tipo de contenido y tamaño de respuesta entre muestras.
  • Escalar el enrutamiento solo cuando la respuesta demuestre que el camino simple es inestable.
  • Tratar respuestas sobredimensionadas como un problema de alcance antes de escalar el mismo perfil.
Pantalla de seguridad digital que representa señales de anti-bot y acceso protegido

04 / Bloques de anti-bot, geográficos y de acceso

Leer bloques antes de la escalación

Una pantalla de error 403, 401, 429, CAPTCHA, desafío WAF, muro de inicio de sesión, bucle de consentimiento o desajuste específico de región no es solo un error; es una pista sobre lo que el sitio espera del visitante. Los competidores a menudo empujan a los equipos hacia un perfil predeterminado más pesado, pero eso puede agotar el presupuesto sin demostrar la solución. El mejor camino de ScraperFly es la escalación basada en evidencia: preservar encabezados realistas cuando el contexto importa, usar sesiones cuando la continuidad cambia la respuesta, habilitar renderizado cuando el contenido útil es generado por el navegador, y elegir enrutamiento premium o por país cuando la reputación o la geografía cambian el resultado.

403429CAPTCHAdesajuste de país
  • Usar enrutamiento premium cuando la reputación de IP es el cuello de botella comprobado.
  • Usar segmentación por país cuando el idioma, la moneda, el inventario o los resultados de búsqueda cambian según el mercado.
  • Usar encabezados, cookies y sesiones cuando el estado del visitante cambia la respuesta.
  • Reducir la concurrencia y agregar retroceso cuando las solicitudes repetidas activan la limitación del objetivo.
Desarrollador preparando código y artefactos de salida en una laptop

05 / Calidad de renderizado y salida

Enviar artefactos utilizables

Un estado 200 no es lo mismo que un raspado utilizable. El HTML crudo puede ser un shell de aplicación vacío, Markdown puede omitir el artículo principal, JSON puede carecer de metadatos esperados, el texto puede incluir ruido, las capturas de pantalla pueden estar en blanco, y la salida en PDF o imagen puede fallar si el paso del navegador se agota. ScraperFly es valioso porque la misma solicitud de API puede pasar de HTML crudo a DOM renderizado, texto limpio, Markdown, JSON, captura de pantalla o PDF, y luego ser verificada contra el artefacto que tu producto realmente necesita. Eso reduce el código de pegamento, las importaciones fallidas y las ejecuciones por lotes costosas que solo descubren una mala salida después del hecho.

render_timeoutbrowser_render_failedcampos JSONsalida PDF/imágenes
  • Habilitar renderizado cuando el HTML crudo es solo un shell y el contenido útil aparece después de JavaScript.
  • Valida texto, Markdown y JSON contra los campos esperados antes de agrupar.

  • Utiliza captura de pantalla o salida en PDF cuando la prueba visual o la evidencia de auditoría son importantes.
  • Considera los artefactos en blanco o parciales como fallos de calidad incluso cuando el estado HTTP es exitoso.
Señal de monitorización

Clasifica el comportamiento de la fuente antes de escalar una alerta

Una buena monitorización no trata cada cambio de captura como un evento de reputación. Registra qué cambió, por qué cambió y si la evidencia es lo suficientemente sólida como para actuar.

Cambios de contenido

Mención añadida, mención eliminada, título cambiado, calificación cambiada, oferta cambiada o copia de página actualizada.

Ruido de fuente

Paginación, duplicados, localización, redirecciones, ordenación, páginas obsoletas y cambios de diseño.

Problemas de captura

Tiempos de espera, HTML vacío, renderizado tardío, respuesta demasiado grande, 403, 429 o formato de salida no soportado.

Preguntas frecuentes de la marca

Preguntas comunes sobre los flujos de trabajo de scraping de monitorización de marcas

Respuestas prácticas para equipos que preservan el contexto de la fuente, revisan evidencia, frescura, duplicados, prueba visual y fiabilidad de captura antes de que las alertas se conviertan en decisiones.

Respuestas de la marca
Fuentes

Menciones y páginas

Comienza con evidencia pública que tu equipo pueda revisar.

¿Qué fuentes puede raspar la monitorización de marcas?

Artículos públicos, páginas de reseñas, listados, directorios, páginas de productos, páginas de comparación, páginas de perfil y otras páginas accesibles donde aparece la marca.

¿ScraperFly proporciona puntuación de sentimientos?

ScraperFly proporciona captura y entrega. Los equipos pueden integrar el texto, Markdown, metadatos o capturas de pantalla recopilados en su propio flujo de trabajo de análisis de sentimientos, alertas o reseñas.

Salida

Alertas legibles

Elige el formato que ayude a los revisores a actuar.

¿Es útil Markdown para alertas de marca?

Sí. Markdown mantiene los encabezados, enlaces y texto legible juntos, lo que facilita la revisión de menciones más que el marcado en bruto para muchos equipos.

¿Cuándo deben incluirse capturas de pantalla en las alertas?

Utiliza capturas de pantalla para menciones de alto riesgo, reclamaciones visuales, estados de página cambiados o casos donde la dirección, relaciones públicas, soporte o control de calidad necesitan pruebas.

Controles

Frescura y renderización

Utiliza controles más estrictos cuando mejoren la evidencia.

¿Por qué desapareció una mención del HTML capturado?

Puede haberse movido, eliminado, cargado después de JavaScript, cambiado la paginación o aparecer solo en un estado de página regional.

¿Debería usar enrutamiento por país para la monitorización de marcas?

Utiliza enrutamiento por país cuando las páginas, listados, reseñas, idioma, disponibilidad o fragmentos de búsqueda varían según el mercado.

Escalar

Calidad de alerta

Reduce el ruido antes de que las verificaciones recurrentes crezcan.

¿Cómo evito alertas duplicadas?

Almacena la URL de origen, la URL final, el título de la página, el texto mencionado, la marca de tiempo, el idioma y las huellas dactilares duplicadas antes de enviar alertas a downstream.

¿Cómo puedo mantener el monitoreo asequible?

Utiliza formatos ligeros para verificaciones rutinarias y reserva la renderización, el enrutamiento por país, capturas de pantalla, PDFs o entrega premium para fuentes que lo necesiten.

































