






ScraperFlyAPI de dados web pronta para IA

rendering

Raspe sites Next.js com o modo de captura correto

As páginas Next.js podem ser renderizadas no servidor, geradas estaticamente, reconstruídas incrementalmente, hidratadas ou do lado do cliente. O ScraperFly ajuda os desenvolvedores a inspecionar primeiro as páginas públicas do Next.js, manter o HTML fonte completo leve e habilitar a renderização do navegador apenas quando o JavaScript altera o conteúdo que o fluxo de trabalho precisa.

Fluxo de captura do Next.js

Escolha HTML bruto ou captura renderizada com base em como a rota é construída

O Next.js pode servir uma página completa antes que o navegador execute, ou pode enviar uma estrutura leve que se torna útil apenas após a hidratação e o carregamento de dados do lado do cliente. O ScraperFly oferece às equipes uma maneira prática de diferenciar isso antes que a lógica do parser, as tentativas e a capacidade do navegador se tornem parte do fluxo de trabalho de produção.

Comece com a resposta da fonte pública, inspecione se o conteúdo alvo já está lá, e então compare a saída renderizada quando a página provar que precisa da execução do JavaScript. Isso mantém as rotas estáticas e renderizadas no servidor rápidas, enquanto ainda suporta páginas construídas pelo cliente que precisam de um navegador para se tornarem completas.
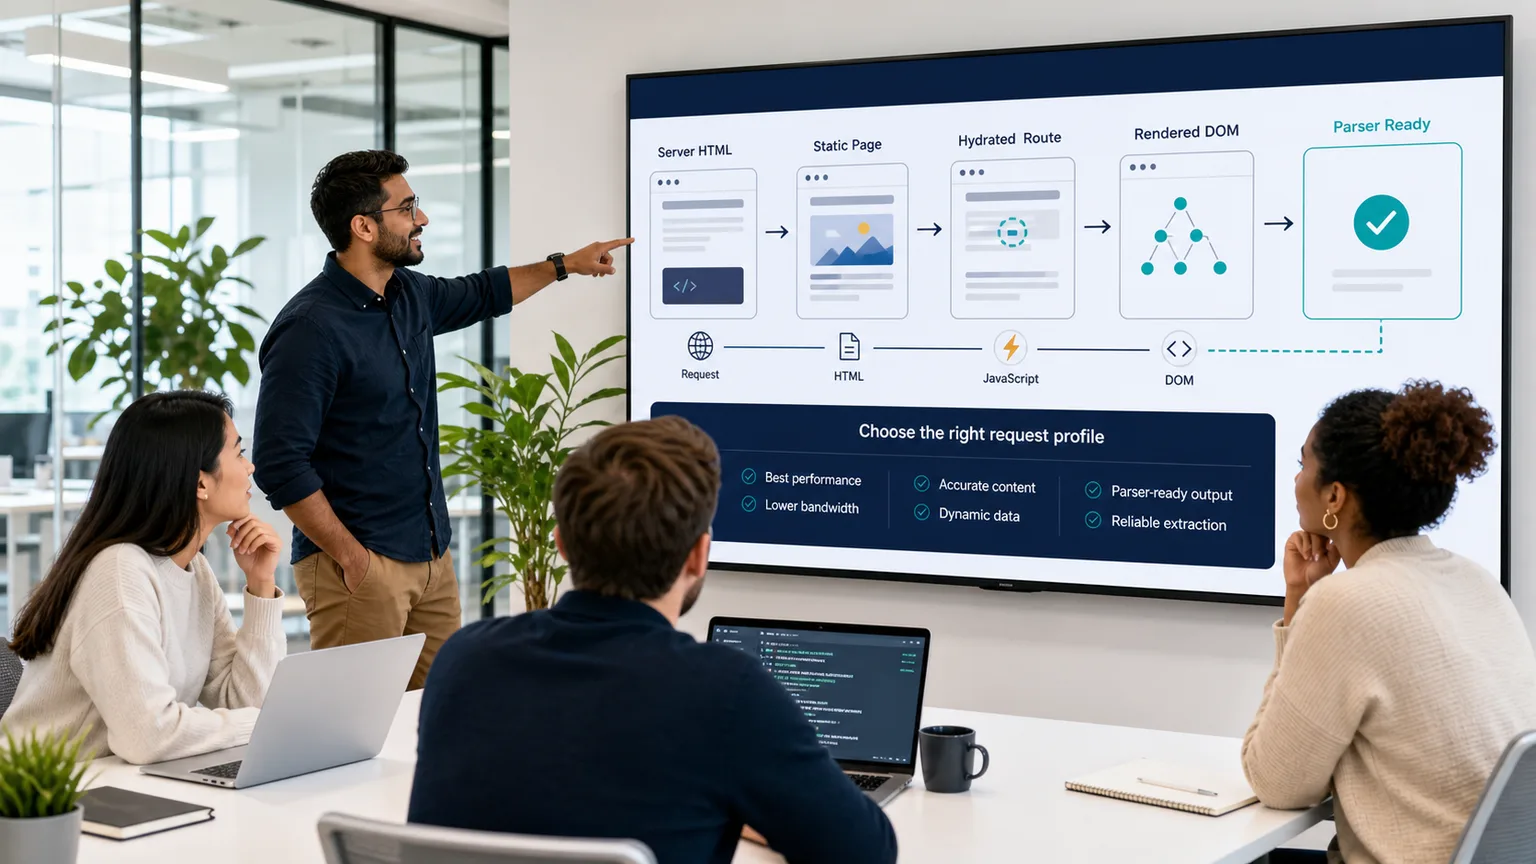
HTML do servidorrotas hidratadasrenderizar quando necessário
Equipe comparando HTML fonte, saída estática, rotas hidratadas e DOM renderizado para um fluxo de trabalho de scraping do Next.js

Por que as páginas do Next.js precisam de uma decisão de captura primeiro?

O Next.js não é um único padrão de renderização. Uma rota pública pode ser renderizada no servidor para cada solicitação, gerada estaticamente no momento da construção, atualizada através de regeneração incremental, ou montada no navegador a partir de componentes e chamadas de dados do cliente. Duas páginas no mesmo site podem se comportar de maneira diferente, então um único perfil de scraping padrão muitas vezes perde tempo ou perde conteúdo.

A pergunta útil não é se o site usa Next.js. A pergunta útil é onde os dados aparecem. Se a resposta da fonte já contém cartões de produtos, texto de artigos, preços, links, metadados, paginação ou listagens, uma solicitação HTML leve geralmente é suficiente. Se a primeira resposta contém uma estrutura de rota, espaços reservados, scripts ou estado parcial, a captura renderizada pode ser a maneira mais limpa de coletar a página que seus usuários realmente veem.

Conclusão prática: trate o scraping do Next.js como um problema de inspeção de resposta primeiro, depois escolha o menor perfil de solicitação que retorne o conteúdo necessário.

Quando o HTML fonte é suficiente para um scraping do Next.js?

O HTML fonte é suficiente quando a resposta inicial inclui os campos que sua aplicação irá analisar. Isso é comum em páginas renderizadas no servidor, páginas de marketing estáticas, páginas de documentação, rotas de artigos, páginas de categorias e listagens públicas onde o conteúdo é colocado no HTML para velocidade, SEO ou confiabilidade. Nesses casos, adicionar um navegador pode tornar a solicitação mais lenta e pesada sem melhorar o resultado.

Um fluxo de trabalho baseado na fonte também facilita a depuração. Sua equipe pode inspecionar a URL final, status, tipo de conteúdo, tamanho da resposta e marcação antes de adicionar esperas ou execução do navegador. Se os seletores, links, cabeçalhos, tabelas ou metadados incorporados necessários já estiverem presentes, mantenha a rota em HTML bruto e reserve controles mais pesados para os alvos que provarem que precisam deles.

Sinal da rota Next.js O que geralmente significa Melhor perfil do ScraperFly
Conteúdo útil aparece no HTML fonte A página provavelmente é renderizada no servidor ou estática o suficiente para análise direta Use HTML bruto e mantenha a solicitação leve.
HTML fonte tem uma estrutura, scripts ou espaços reservados O conteúdo visível pode ser criado após a hidratação Compare HTML renderizado antes de construir a lógica do parser.
A saída renderizada contém os campos ausentes A execução do navegador altera o resultado do scraping Use renderização para este padrão de rota e registre por que é necessário.
Conteúdo muda por localidade, cookie ou estado anterior A rota pode depender do contexto da solicitação Adicione cabeçalhos, cookies ou sessões apenas onde esse contexto importa.
A saída renderizada ainda está vazia ou bloqueada O problema pode ser roteamento, tempo, regras de acesso ou comportamento do alvo Inspecione as evidências antes de tentar novamente ou escalar a entrega.

Quando o scraping do Next.js deve usar renderização do navegador?

Use renderização quando o conteúdo público útil aparecer apenas após a execução do código do lado do navegador. Isso pode acontecer em rotas de aplicação hidratadas, grades de produtos interativas, resultados de busca, listas infinitas, widgets de revisão, blocos de preços dinâmicos, mapas, painéis com dados públicos, ou páginas onde o HTML inicial aponta principalmente o navegador para pacotes de JavaScript.

A renderização deve ser um controle direcionado, não um reflexo. Compare a resposta da fonte com o estado renderizado e procure uma diferença real de conteúdo. Se a renderização adicionar os campos ausentes, vale a pena usar para essa classe de rota. Se a renderização não melhorar a saída, o próximo passo não é tentativas cegas; inspecione o tempo, redirecionamentos, status, comportamento de recursos, tamanho da resposta e se a página pública realmente expõe os dados.

Para decisões mais profundas sobre o navegador, compare esta página com a API de renderização JavaScript, a API de scraping de navegador sem cabeça, e os guias da API de HTML renderizado.

Qual formato de saída deve uma solicitação de fluxo de trabalho do Next.js?

O formato certo depende do que o sistema a jusante fará com a página. HTML é melhor quando seletores, relações DOM, links, atributos, tabelas ou estado incorporado são importantes. Texto e Markdown são melhores quando a saída alimenta busca, resumos, classificação, revisão de conteúdo ou pipelines de IA. Metadados JSON ajudam com diagnósticos porque preservam evidências da solicitação, como status, URL final, tamanho da resposta e tipo de conteúdo. Capturas de tela e PDFs são úteis quando um humano precisa de prova visual do que a página renderizada mostrou.

Formato de saída Use para Vantagem do Next.js
HTML bruto Rotas renderizadas no servidor ou estáticas Rápido, amigável ao parser e geralmente a captura de menor peso.
HTML renderizado Rotas hidratadas e conteúdo construído pelo navegador Captura o DOM após o JavaScript alterar a página.
Texto Busca, monitoramento, análise leve Remove ruído de layout quando a estrutura não é necessária.
Markdown IA, RAG, documentação, revisão de conteúdo Mantém cabeçalhos, links e seções legíveis para fluxos de trabalho de modelos de linguagem.
Metadados JSON Registro e decisões de roteamento Torna os resultados das solicitações mais fáceis de comparar entre amostras de rota.
Captura de tela ou PDF QA, revisão de conformidade, monitoramento visual, arquivos Mostra como a página pública parecia após a captura.

Como as equipes devem testar rotas do Next.js antes da produção?

Teste um pequeno conjunto de rotas representativas primeiro. Inclua uma rota estática, uma rota renderizada no servidor, uma rota dinâmica e uma rota que parece pesada do lado do cliente. Envie cada alvo através do API Builder, compare o HTML fonte com a saída renderizada e escolha o menor formato que seu parser ou aplicação possa usar diretamente.

Esse conjunto de testes se torna seu manual de solicitações. Rotas simples podem permanecer em HTML bruto. Rotas construídas pelo cliente podem usar HTML renderizado ou uma saída de texto e Markdown mais limpa. Rotas que precisam de continuidade podem adicionar sessões. Rotas que dependem de idioma, região ou contexto de roteamento podem adicionar cabeçalhos, cookies, direcionamento por país ou entrega mais forte apenas quando as evidências apoiam isso.

Conclusão prática: construa o perfil de scraping do Next.js a partir de evidências de rota, não a partir de uma suposição geral sobre o framework.

Como o ScraperFly mantém o scraping do Next.js acessível?

O controle de custos começa evitando trabalho desnecessário do navegador. Uma página que retorna HTML completo renderizado no servidor não deve ter o mesmo peso de solicitação que uma rota hidratada com esperas, saída visual, contexto de sessão e roteamento mais forte. O ScraperFly torna essa decisão mais fácil porque o mesmo caminho da API pode começar leve e adicionar controles apenas quando o alvo provar que eles mudam o resultado.

Use a precificação como um loop de feedback de engenharia. Classifique padrões de rota, mantenha HTML bruto como padrão para respostas completas, reserve renderização para conteúdo do lado do cliente e gere capturas de tela ou PDFs apenas quando a prova visual fizer parte do fluxo de trabalho. A página de preços e o calculador de custo de crédito da API de scraping da web ajudam as equipes a estimar como essas escolhas afetam o volume antes de escalarem.

Como o scraping do Next.js se compara ao scraping do React e ao scraping de SPA?

O Next.js frequentemente se posiciona entre o scraping clássico de HTML e o scraping completo de SPA. Ele pode se comportar como um site renderizado no servidor, um site estático, um aplicativo React hidratado ou uma aplicação de página única pesada do lado do cliente, dependendo da rota. Isso torna importante testar a URL pública real em vez de tratar cada página do Next.js como um alvo exclusivo do navegador.

Se o site se comporta como uma aplicação React, o guia da API de scraping do React é uma comparação útil. Se a navegação e o conteúdo dependem fortemente do roteamento do lado do navegador, revise o fluxo de trabalho da API de scraping de SPA. Se o alvo lhe der a marcação fonte completa, mantenha o caminho de captura mais próximo da abordagem da API de scraping de HTML e reserve o navegador para páginas que realmente precisam dele.


Verificação de alvo do Next.js

Prove onde o conteúdo do Next.js aparece antes de escolher um navegador

As rotas do Next.js podem retornar HTML completo do servidor, conteúdo estático, estruturas hidratadas ou visualizações construídas pelo navegador. O ScraperFly ajuda as equipes a inspecionar a resposta pública real primeiro, e depois escolher HTML bruto, captura renderizada, sessões, cabeçalhos, roteamento ou saída visual apenas quando esses controles melhoram o resultado.

Resposta HTML bruta mapeada para dados visíveis da página
01

Disponibilidade de HTML bruto

Verifique se os campos que você precisa já estão presentes na primeira resposta HTML.

Melhor primeiro teste para páginas simples, artigos, documentos, listagens e detalhes de produtos.

Comparação antes e depois da renderização do JavaScript
02

Dependência de JavaScript

Compare HTML bruto com o DOM renderizado ou captura de tela antes de ativar a renderização do navegador.

Use renderização quando o HTML bruto é apenas uma casca e scripts criam o conteúdo útil.

Cookies, consentimento, sessão e contexto de acesso para scraping
03

Estado e contexto de acesso

Identifique se cookies, consentimento, limites de login, paginação ou o mesmo estado do visitante afetam a resposta.

Use sessões e cabeçalhos quando a continuidade muda os dados que você recebe.

Variações de conteúdo regional entre países e rotas
04

Variação geo/conteúdo

Teste se país, idioma, moeda, inventário, SERP, anúncios ou reputação da rota mudam o resultado.

Use roteamento geo ou premium apenas quando o alvo provar que a resposta varia por rota.

Verificações que mantêm o scraping do Next.js preciso

Onde está o campo alvo?

Verifique se o campo existe no HTML bruto, DOM renderizado, uma chamada de API, dados estruturados, um arquivo ou um estado de interação posterior.

O que muda na resposta?

Amostre algumas URLs e compare status, URL final, comprimento do conteúdo, redirecionamentos, estados vazios e diferenças nos resultados visíveis.

Qual contexto é necessário?

Marque qualquer dependência de consentimento, localidade, cookies, cabeçalhos, limite de autenticação, paginação, filtros ou solicitações anteriores.

Como é a falha?

Defina os sinais para respostas bloqueadas, parciais, obsoletas, redirecionadas, vazias, com tempo esgotado ou com região incompatível antes de escalar.

Mapeie a rota antes de escalar solicitações

Modo de busca

A disponibilidade de HTML bruto decide se a primeira solicitação pode permanecer simples ou precisa de renderização, esperas, capturas de tela ou extração.

Contexto da solicitação

Os requisitos de estado decidem se é necessário adicionar cabeçalhos, cookies, sessões, manuseio de consentimento ou um perfil de visitante estável.

Escolha de roteamento

Descobertas geográficas e de reputação decidem se o roteamento padrão é suficiente ou se uma rota de país/premium é justificada.

Regras de validação

Estados de falha conhecidos se tornam verificações para novas tentativas, escalonamento, revisão de QA e decisão de quando um perfil mais leve ainda está completo.

Construtor de solicitações Next.js

Construa uma solicitação de scraping Next.js que comece leve e renderize apenas quando a evidência exigir.

Use o API Builder para comparar HTML fonte com saída renderizada, escolha o formato de resposta que seu parser pode usar imediatamente e copie uma solicitação canônica do ScraperFly para seu aplicativo assim que o comportamento da rota estiver claro.

01
01

Capture HTML bruto quando a rota já contém os dados

Mantenha páginas estáticas e renderizadas no servidor leves em vez de pagar o custo do navegador por conteúdo que já está presente.

02
02

Use execução do navegador para rotas hidratadas ou carregadas pelo cliente

Retorne HTML renderizado, texto, Markdown, capturas de tela ou PDFs quando o JavaScript mudar o estado da página pública.

03
03

Preserve diagnósticos para decisões de rota

Compare o status, URL final, tipo de conteúdo, tamanho da resposta e prova visual antes de mover uma rota para o volume de produção.

Controles de solicitação Next.js

url

A rota pública Next.js para capturar.

render

Execute um navegador quando a hidratação ou dados do lado do cliente mudarem a resposta.

format

Retorne HTML, texto, Markdown, metadados JSON, captura de tela ou PDF.

wait

Dê tempo para os dados da rota do lado do cliente se estabilizarem quando a renderização estiver habilitada.

keep_headers

Preserve os cabeçalhos permitidos quando o local, tipo de conteúdo ou contexto de solicitação pública importam.

session

Reutilize o contexto apenas para rotas relacionadas que dependem de estado compartilhado.

exemplo de cURL

Gere Markdown com a mesma forma de solicitação que você pode mover para produção

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Controle de custo Next.js

Mantenha o trabalho do navegador para as rotas Next.js que provam que precisam disso

ScraperFly permite que as equipes separem rotas HTML completas de rotas hidratadas antes da escalabilidade. Use captura de fonte de baixo peso onde a página já está completa, depois adicione renderização, esperas, sessões, arquivos visuais ou roteamento mais forte apenas para padrões de rota onde esses controles mudam a saída.

Um pedido HTML leve retornando uma resposta simples
01

Fetch básico

Use um fetch básico quando o HTML público já contém os campos que você precisa.

Perfil de pedido mais leve; mantenha-o quando a resposta estiver completa.

Renderização JavaScript produzindo um DOM completo
02

Renderização

Use renderização quando o HTML bruto é uma casca e o JavaScript completa a página.

Perfil mais pesado; use-o apenas quando a saída do navegador alterar o resultado.

Várias solicitações preservando cookies e estado do visitante
03

Sessão com estado

Use sessões quando cookies, consentimento, local ou paginação alterarem a resposta.

Perfil de estado mais pesado; preserve-o apenas quando a continuidade for importante.

Roteamento de solicitações através de rotas geográficas e de maior qualidade
04

Roteamento e geo premium

Use roteamento premium ou geográfico apenas quando a origem, país, reputação ou conteúdo regional alterarem o resultado.

Perfil de roteamento mais pesado; aplique-o apenas a alvos que provem que precisam.

O que muda o peso da solicitação

Mais trabalho de infraestrutura

Renderização de navegador, escolhas de roteamento e esperas mais longas significam que a plataforma precisa fazer mais do que retornar uma simples resposta.

Mais incerteza no alvo

Redirecionamentos, estados vazios, limites de taxa e páginas de desafio frequentemente requerem opções de entrega mais robustas ou tentativas novamente.

Mais estado a preservar

Cookies, sessões, consentimento e fluxos de múltiplas páginas adicionam partes móveis que um fetch sem estado simples não possui.

Mais evidências a retornar

Capturas de tela, PDFs, saída renderizada e artefatos de resposta mais ricos são úteis, mas são mais pesados do que HTML simples.

Como manter o volume previsível

Amostre antes de escalar

Teste um pequeno conjunto de URLs primeiro e agrupe alvos pelo perfil mais leve que retorna dados completos.

Não renderize por padrão

Inspecione o HTML bruto antes de ativar a renderização. Muitas páginas públicas já contêm os dados que você precisa.

Escalone com base em evidências

Suba apenas quando a resposta mostrar conteúdo ausente, dependência de estado, variação geográfica ou problemas de roteamento.

Meça resultados úteis

Otimize em torno de registros válidos entregues, não no volume bruto de solicitações. Um perfil mais leve é melhor apenas quando permanece completo.

Perguntas sobre Next.js

Perguntas comuns sobre scraping de sites Next.js

Respostas rápidas para equipes avaliando o comportamento da API de web scraping: formatos de solicitação, renderização JavaScript, roteamento de proxy, créditos, arquivos, segurança e faturamento.

Respostas rápidas

HTML bruto vs captura de navegador

Decida com base na resposta, não no nome do framework.

Toda página Next.js deve usar renderização?

Não. Comece com o HTML fonte e renderize apenas quando o JavaScript adicionar o conteúdo que seu fluxo de trabalho precisa.

O que prova que a renderização é necessária?

Uma diferença significativa entre HTML fonte e saída renderizada: campos ausentes, seções preguiçosas, dados carregados pelo cliente ou um shell de rota que se torna útil após a execução.

Formatos para rotas Next.js

Escolha a forma da resposta em torno do fluxo de trabalho a montante.

O HTML renderizado é sempre a melhor saída?

HTML renderizado é o melhor para análise de DOM. Texto, Markdown, metadados, capturas de tela e PDFs podem ser melhores para busca, IA, diagnósticos ou revisão visual.

Quando devo usar Markdown?

Use Markdown quando títulos, seções e links legíveis importarem mais do que relações exatas de DOM.

Cabeçalhos, sessões e roteamento

Adicione o contexto da solicitação apenas quando o comportamento da rota depender disso.

As páginas do Next.js precisam de sessões?

Apenas quando o conteúdo público depender de cookies compartilhados, preferências, estado de consentimento ou uma solicitação anterior.

Quando o roteamento por país é importante?

Use o roteamento por país quando uma página pública mudar por localização, moeda, idioma, disponibilidade ou redirecionamentos regionais.

Testando antes da produção

Classifique os padrões de rota antes de aumentar o volume.

O que devo testar primeiro?

Teste rotas estáticas, renderizadas no servidor, hidratadas e pesadas no cliente que sejam representativas, e então atribua a cada classe de rota o menor perfil de solicitação que funcione.

Como posso manter os custos previsíveis?

Mantenha rotas HTML completas leves e reserve renderização, esperas, saída visual e roteamento mais forte para as rotas que provarem precisar desses controles.





