






Next.js Erfassungsworkflow
Wählen Sie rohes HTML oder gerenderte Erfassung basierend darauf, wie die Route aufgebaut ist
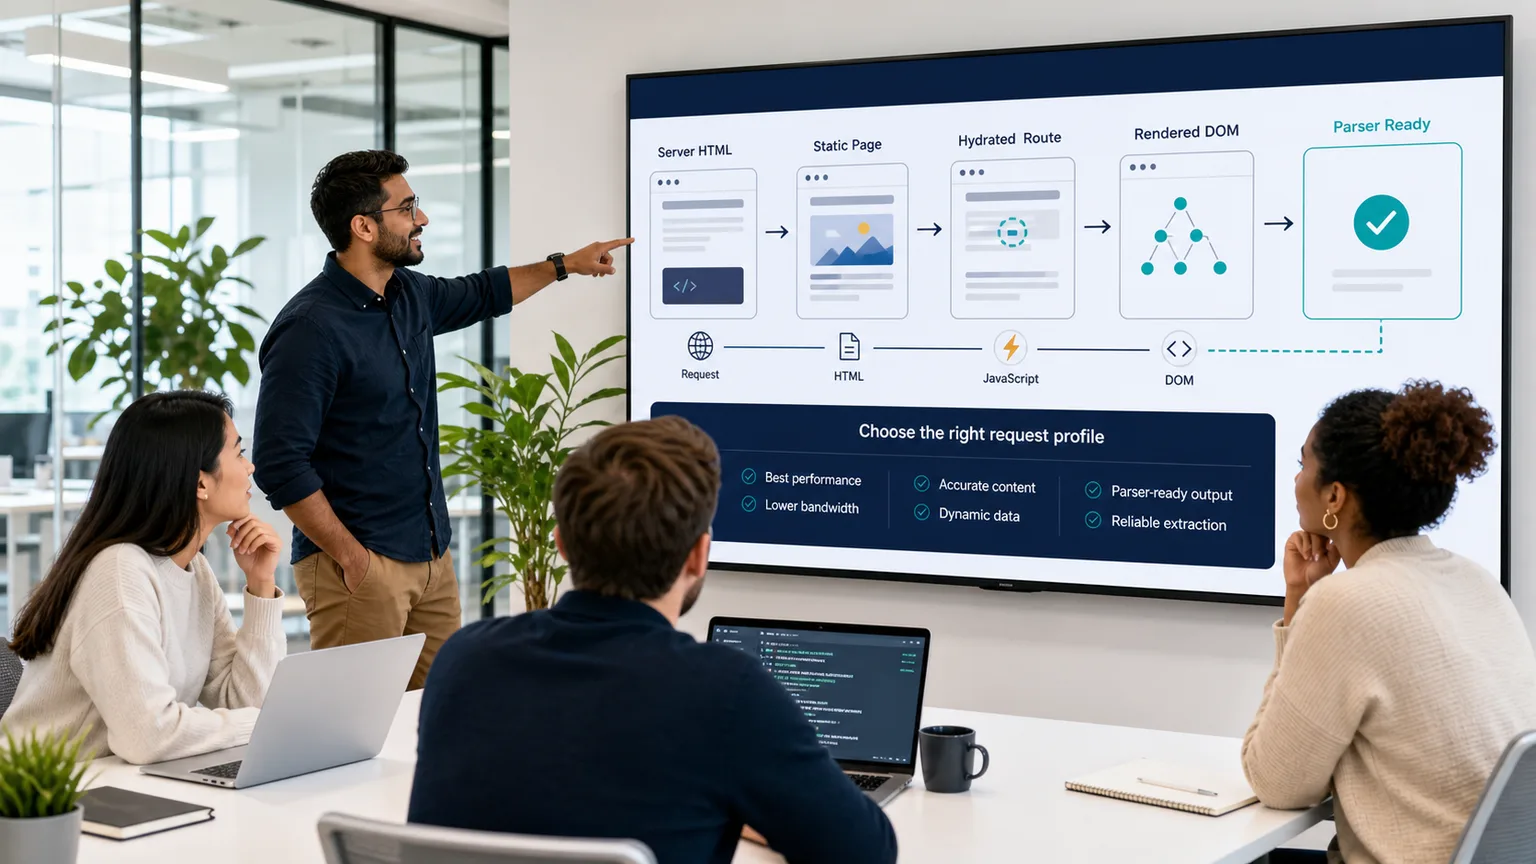
Next.js kann eine vollständige Seite bereitstellen, bevor der Browser läuft, oder es kann eine leichte Hülle senden, die erst nach der Hydration und dem Laden von Daten auf der Client-Seite nützlich wird. ScraperFly bietet Teams eine praktische Möglichkeit, den Unterschied zu erkennen, bevor Parser-Logik, Wiederholungen und Browser-Kapazität Teil des Produktionsworkflows werden.
Beginnen Sie mit der öffentlichen Quellantwort, überprüfen Sie, ob der Zielinhalt bereits vorhanden ist, und vergleichen Sie dann die gerenderte Ausgabe, wenn die Seite beweist, dass sie eine JavaScript-Ausführung benötigt. Das hält statische und servergerenderte Routen schnell, während es gleichzeitig clientseitig erstellte Seiten unterstützt, die einen Browser benötigen, um vollständig zu werden.
Warum benötigen Next.js-Seiten zuerst eine Erfassungsentscheidung?
Next.js ist kein einheitliches Rendering-Muster. Eine öffentliche Route kann für jede Anfrage servergerendert, zur Build-Zeit statisch generiert, durch inkrementelle Regeneration aktualisiert oder im Browser aus Client-Komponenten und Datenaufrufen zusammengesetzt werden. Zwei Seiten auf derselben Website können sich unterschiedlich verhalten, sodass ein einzelnes Standard-Scraping-Profil oft Zeit verschwendet oder Inhalte verpasst.
Die nützliche Frage ist nicht, ob die Website Next.js verwendet. Die nützliche Frage ist, wo die Daten erscheinen. Wenn die Quellantwort bereits Produktkarten, Artikeltexte, Preise, Links, Metadaten, Paginierung oder Auflistungen enthält, ist eine leichte HTML-Anfrage oft ausreichend. Wenn die erste Antwort eine Routenhülle, Platzhalter, Skripte oder einen teilweisen Zustand enthält, kann die gerenderte Erfassung der sauberste Weg sein, um die Seite zu sammeln, die Ihre Benutzer tatsächlich sehen.
Praktische Erkenntnis: Behandeln Sie das Scraping von Next.js zuerst als ein Problem der Antwortinspektion und wählen Sie dann das kleinste Anfrageprofil, das den benötigten Inhalt zurückgibt.
Wann ist Quell-HTML für ein Next.js-Scraping ausreichend?
Quell-HTML ist ausreichend, wenn die anfängliche Antwort die Felder enthält, die Ihre Anwendung parsen wird. Das ist häufig bei servergerenderten Seiten, statischen Marketingseiten, Dokumentationsseiten, Artikelrouten, Kategorieseiten und öffentlichen Auflistungen der Fall, bei denen Inhalte in das HTML für Geschwindigkeit, SEO oder Zuverlässigkeit eingefügt werden. In diesen Fällen kann das Hinzufügen eines Browsers die Anfrage langsamer und schwerer machen, ohne das Ergebnis zu verbessern.
Ein Quell-zuerst-Workflow erleichtert auch das Debugging. Ihr Team kann die endgültige URL, den Status, den Inhaltstyp, die Antwortgröße und das Markup überprüfen, bevor es Wartezeiten oder Browserausführungen hinzufügt. Wenn die erforderlichen Selektoren, Links, Überschriften, Tabellen oder eingebetteten Metadaten bereits vorhanden sind, halten Sie die Route auf rohem HTML und reservieren Sie schwerere Kontrollen für die Ziele, die beweisen, dass sie benötigt werden.
| Next.js Routen-Signal | Was es normalerweise bedeutet | Bestes ScraperFly-Profil |
|---|---|---|
| Nützlicher Inhalt erscheint im Quell-HTML | Die Seite ist wahrscheinlich servergerendert oder statisch genug für direktes Parsen | Verwenden Sie rohes HTML und halten Sie die Anfrage leicht. |
| Quell-HTML hat eine Hülle, Skripte oder Platzhalter | Der sichtbare Inhalt kann nach der Hydration erstellt werden | Vergleichen Sie gerendertes HTML, bevor Sie die Parser-Logik erstellen. |
| Gerenderte Ausgabe enthält die fehlenden Felder | Die Browserausführung ändert das Scraping-Ergebnis | Verwenden Sie das Rendering für dieses Routenmuster und protokollieren Sie, warum es benötigt wird. |
| Inhalt ändert sich je nach Region, Cookie oder vorherigem Zustand | Die Route kann vom Anfragekontext abhängen | Fügen Sie Header, Cookies oder Sitzungen nur dort hinzu, wo dieser Kontext wichtig ist. |
| Gerenderte Ausgabe ist immer noch leer oder blockiert | Das Problem kann Routing, Timing, Zugriffsregeln oder Zielverhalten sein | Überprüfen Sie Beweise, bevor Sie es erneut versuchen oder die Lieferung eskalieren. |
Wann sollte das Scraping von Next.js das Browser-Rendering verwenden?
Verwenden Sie das Rendering, wenn der nützliche öffentliche Inhalt erst nach der Ausführung von Code auf der Browser-Seite erscheint. Das kann bei hydrierten Anwendungsrouten, interaktiven Produktgitter, Suchergebnissen, unendlichen Listen, Bewertungs-Widgets, dynamischen Preisblöcken, Karten, Dashboards mit öffentlichen Daten oder Seiten geschehen, bei denen das anfängliche HTML hauptsächlich den Browser auf JavaScript-Bundles verweist.
Rendering sollte eine gezielte Kontrolle sein, kein Reflex. Vergleichen Sie die Quellantwort mit dem gerenderten Zustand und suchen Sie nach einem echten Inhaltsunterschied. Wenn das Rendering die fehlenden Felder hinzufügt, ist es wert, für diese Routenklasse verwendet zu werden. Wenn das Rendering die Ausgabe nicht verbessert, ist der nächste Schritt nicht blindes Wiederholen; überprüfen Sie Timing, Weiterleitungen, Status, Ressourcenverhalten, Antwortgröße und ob die öffentliche Seite tatsächlich die Daten offenbart.
Für tiefere Entscheidungen im Browser vergleichen Sie diese Seite mit der JavaScript Rendering API, der Headless Browser Scraping API und den gerenderten HTML API Leitfäden.
Welches Ausgabeformat sollte ein Next.js-Workflow anfordern?
Das richtige Format hängt davon ab, was das nachgelagerte System mit der Seite tun wird. HTML ist am besten, wenn Selektoren, DOM-Beziehungen, Links, Attribute, Tabellen oder eingebetteter Zustand wichtig sind. Text und Markdown sind besser, wenn die Ausgabe Suchanfragen, Zusammenfassungen, Klassifizierungen, Inhaltsüberprüfungen oder KI-Pipelines speist. JSON-Metadaten helfen bei der Diagnose, da sie Anfragebeweise wie Status, endgültige URL, Antwortgröße und Inhaltstyp bewahren. Screenshots und PDFs sind nützlich, wenn ein Mensch visuelle Beweise dafür benötigt, was die gerenderte Seite gezeigt hat.
| Ausgabeformat | Verwenden Sie es für | Next.js Vorteil |
|---|---|---|
| Rohes HTML | Servergerenderte oder statische Routen | Schnell, parserfreundlich und normalerweise die leichteste Erfassung. |
| Gerendertes HTML | Hydrierte Routen und browserbasierte Inhalte | Erfasst das DOM, nachdem JavaScript die Seite geändert hat. |
| Text | Suche, Überwachung, leichte Analyse | Entfernt Layoutgeräusche, wenn die Struktur nicht erforderlich ist. |
| Markdown | KI, RAG, Dokumentation, Inhaltsüberprüfung | Hält lesbare Überschriften, Links und Abschnitte für Sprachmodell-Workflows. |
| JSON-Metadaten | Protokollierung und Routing-Entscheidungen | Erleichtert den Vergleich von Anfrageergebnissen über Routenproben. |
| Screenshot oder PDF | QA, Compliance-Überprüfung, visuelle Überwachung, Archive | Zeigt, wie die öffentliche Seite nach der Erfassung aussah. |
Wie sollten Teams Next.js-Routen vor der Produktion testen?
Testen Sie zuerst eine kleine Gruppe repräsentativer Routen. Schließen Sie eine statische Route, eine servergerenderte Route, eine dynamische Route und eine Route ein, die clientlastig erscheint. Senden Sie jedes Ziel durch den API Builder, vergleichen Sie Quell-HTML mit gerenderter Ausgabe und wählen Sie das kleinste Format, das Ihr Parser oder Ihre Anwendung direkt verwenden kann.
Dieses Testset wird Ihr Anfrage-Playbook. Einfache Routen können auf rohem HTML bleiben. Clientseitig erstellte Routen können gerendertes HTML oder eine sauberere Text- und Markdown-Ausgabe verwenden. Routen, die Kontinuität benötigen, können Sitzungen hinzufügen. Routen, die von Sprache, Region oder Routing-Kontext abhängen, können Header, Cookies, Länderauswahl oder stärkere Lieferungen nur hinzufügen, wenn die Beweise dies unterstützen.
Praktische Erkenntnis: Erstellen Sie das Next.js-Scraping-Profil aus Routenbeweisen, nicht aus einer standortweiten Annahme über das Framework.
Wie hält ScraperFly das Scraping von Next.js erschwinglich?
Die Kostenkontrolle beginnt damit, unnötige Browserarbeit zu vermeiden. Eine Seite, die vollständiges servergerendertes HTML zurückgibt, sollte nicht das gleiche Anfragegewicht wie eine hydrierte Route mit Wartezeiten, visueller Ausgabe, Sitzungs-Kontext und stärkerem Routing tragen. ScraperFly erleichtert diese Entscheidung, da der gleiche API-Pfad leicht beginnen und Kontrollen nur hinzufügen kann, wenn das Ziel beweist, dass sie das Ergebnis ändern.
Verwenden Sie die Preisgestaltung als Feedbackschleife für Ingenieure. Klassifizieren Sie Routenmuster, halten Sie rohes HTML als Standard für vollständige Antworten, reservieren Sie das Rendering für clientseitige Inhalte und generieren Sie Screenshots oder PDFs nur, wenn visuelle Beweise Teil des Workflows sind. Die Preisseite und der Web Scraping API Kreditkostenrechner helfen Teams, abzuschätzen, wie sich diese Entscheidungen auf das Volumen auswirken, bevor sie skalieren.
Wie vergleicht sich das Scraping von Next.js mit React- und SPA-Scraping?
Next.js sitzt oft zwischen klassischem HTML-Scraping und vollem SPA-Scraping. Es kann sich je nach Route wie eine servergerenderte Seite, eine statische Seite, eine hydrierte React-App oder eine clientlastige Single-Page-Anwendung verhalten. Das macht es wichtig, die tatsächliche öffentliche URL zu testen, anstatt jede Next.js-Seite als rein browserbasiertes Ziel zu behandeln.
Wenn die Website sich wie eine React-Anwendung verhält, ist der React Scraping API Leitfaden ein nützlicher Vergleich. Wenn Navigation und Inhalt stark von browserseitigem Routing abhängen, überprüfen Sie den SPA Scraping API Workflow. Wenn das Ziel Ihnen vollständiges Quell-Markup gibt, halten Sie den Erfassungsweg näher am HTML Scraping API Ansatz und sparen Sie den Browser für Seiten, die ihn wirklich benötigen.







