






Flujo de trabajo de captura de Next.js
Elige HTML sin procesar o captura renderizada según cómo se construya la ruta
Next.js puede servir una página completa antes de que el navegador se ejecute, o puede enviar una estructura ligera que solo se vuelve útil después de la hidratación y la carga de datos del lado del cliente. ScraperFly ofrece a los equipos una forma práctica de diferenciar antes de que la lógica del analizador, los reintentos y la capacidad del navegador se conviertan en parte del flujo de trabajo de producción.
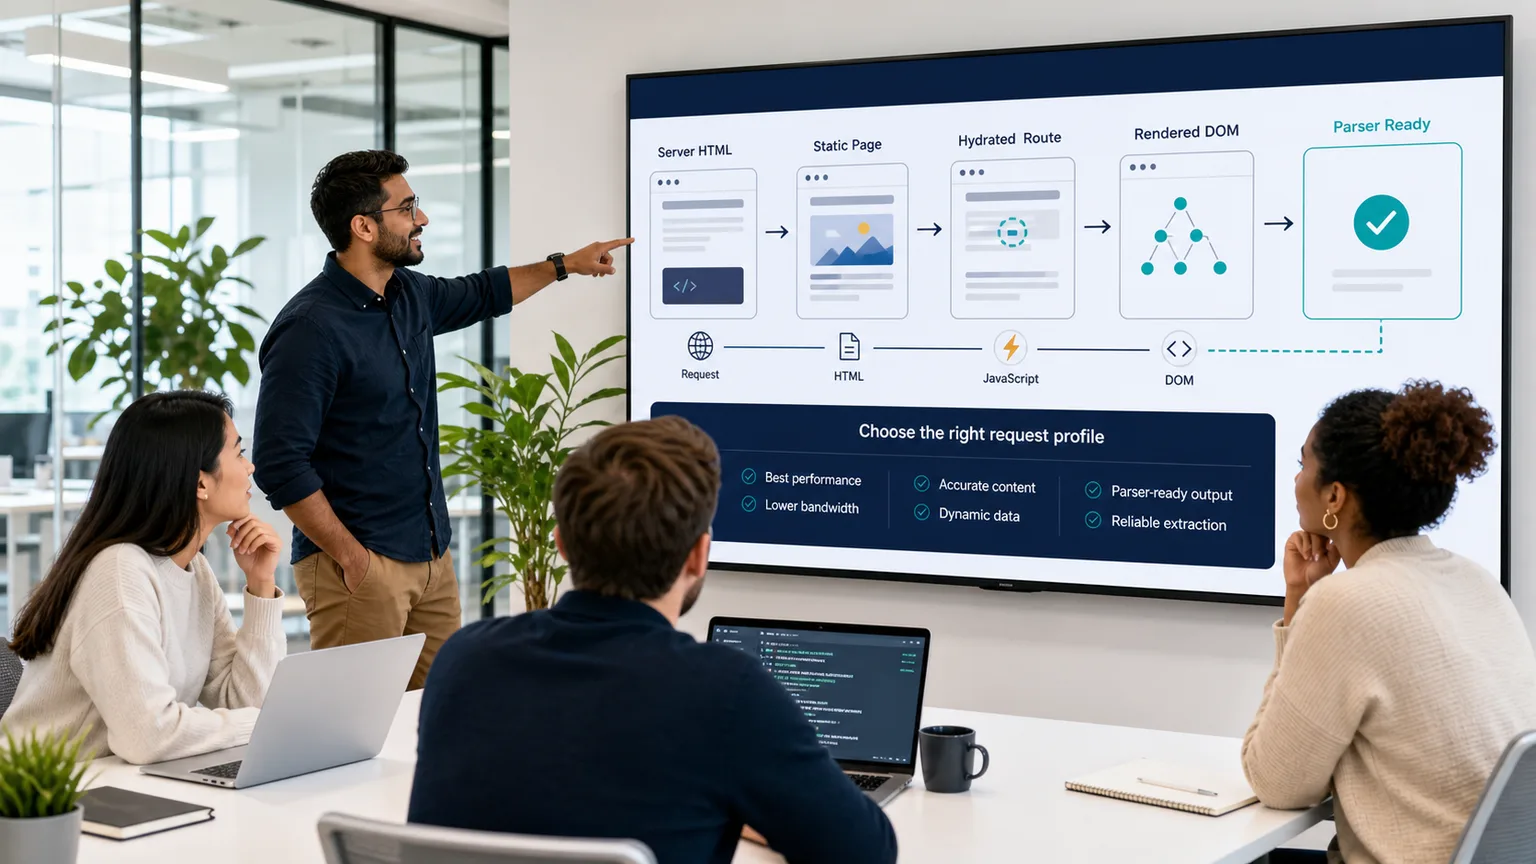
Comienza con la respuesta de fuente pública, inspecciona si el contenido objetivo ya está allí, luego compara la salida renderizada cuando la página demuestra que necesita ejecución de JavaScript. Eso mantiene las rutas estáticas y renderizadas en el servidor rápidas mientras aún se admite páginas construidas por el cliente que necesitan un navegador para completarse.
¿Por qué las páginas de Next.js necesitan una decisión de captura primero?
Next.js no es un único patrón de renderizado. Una ruta pública puede ser renderizada en el servidor para cada solicitud, generada estáticamente en el momento de la construcción, actualizada a través de regeneración incremental, o ensamblada en el navegador a partir de componentes y llamadas de datos del cliente. Dos páginas en el mismo sitio pueden comportarse de manera diferente, por lo que un único perfil de scraping predeterminado a menudo pierde tiempo o se pierde contenido.
La pregunta útil no es si el sitio utiliza Next.js. La pregunta útil es dónde aparece el dato. Si la respuesta de fuente ya contiene tarjetas de producto, texto de artículo, precios, enlaces, metadatos, paginación o listados, una solicitud HTML ligera suele ser suficiente. Si la primera respuesta contiene una estructura de ruta, marcadores de posición, scripts o estado parcial, la captura renderizada puede ser la forma más limpia de recopilar la página que tus usuarios realmente ven.
Conclusión práctica: trata el scraping de Next.js como un problema de inspección de respuesta primero, luego elige el perfil de solicitud más pequeño que devuelva el contenido necesario.
¿Cuándo es suficiente el HTML fuente para un scraping de Next.js?
El HTML fuente es suficiente cuando la respuesta inicial incluye los campos que tu aplicación analizará. Eso es común en páginas renderizadas en el servidor, páginas de marketing estáticas, páginas de documentación, rutas de artículos, páginas de categorías y listados públicos donde el contenido se coloca en el HTML por velocidad, SEO o fiabilidad. En esos casos, agregar un navegador puede hacer que la solicitud sea más lenta y pesada sin mejorar el resultado.
Un flujo de trabajo basado en la fuente también facilita la depuración. Tu equipo puede inspeccionar la URL final, el estado, el tipo de contenido, el tamaño de la respuesta y el marcado antes de agregar esperas o ejecución del navegador. Si los selectores, enlaces, encabezados, tablas o metadatos incrustados requeridos ya están presentes, mantén la ruta en HTML sin procesar y reserva controles más pesados para los objetivos que demuestren que los necesitan.
| Señal de ruta de Next.js | Lo que generalmente significa | Mejor perfil de ScraperFly |
|---|---|---|
| El contenido útil aparece en HTML fuente | La página probablemente está renderizada en el servidor o es lo suficientemente estática para un análisis directo | Usa HTML sin procesar y mantén la solicitud ligera. |
| HTML fuente tiene una estructura, scripts o marcadores de posición | El contenido visible puede ser creado después de la hidratación | Compara HTML renderizado antes de construir la lógica del analizador. |
| La salida renderizada contiene los campos faltantes | La ejecución del navegador cambia el resultado del scraping | Usa renderizado para este patrón de ruta y registra por qué es necesario. |
| El contenido cambia por localización, cookies o estado previo | La ruta puede depender del contexto de la solicitud | Agrega encabezados, cookies o sesiones solo donde ese contexto importa. |
| La salida renderizada sigue vacía o bloqueada | El problema puede ser enrutamiento, temporización, reglas de acceso o comportamiento del objetivo | Inspecciona la evidencia antes de reintentar o escalar la entrega. |
¿Cuándo debería el scraping de Next.js usar renderizado en el navegador?
Usa renderizado cuando el contenido público útil aparece solo después de que se ejecuta el código del lado del navegador. Eso puede suceder en rutas de aplicaciones hidratadas, cuadrículas de productos interactivas, resultados de búsqueda, listas infinitas, widgets de reseñas, bloques de precios dinámicos, mapas, paneles de control con datos públicos, o páginas donde el HTML inicial apunta principalmente al navegador hacia paquetes de JavaScript.
El renderizado debe ser un control específico, no un reflejo. Compara la respuesta de fuente con el estado renderizado y busca una diferencia real de contenido. Si el renderizado agrega los campos faltantes, vale la pena usarlo para esa clase de ruta. Si el renderizado no mejora la salida, el siguiente paso no son reintentos ciegos; inspecciona la temporización, redirecciones, estado, comportamiento de recursos, tamaño de respuesta y si la página pública realmente expone los datos.
Para decisiones más profundas sobre el navegador, compara esta página con la API de renderizado de JavaScript, la API de scraping de navegador sin cabeza, y las guías de la API de HTML renderizado.
¿Qué formato de salida debería solicitar un flujo de trabajo de Next.js?
El formato correcto depende de lo que el sistema de downstream hará con la página. HTML es mejor cuando los selectores, relaciones DOM, enlaces, atributos, tablas o estado incrustado importan. Texto y Markdown son mejores cuando la salida alimenta búsqueda, resúmenes, clasificación, revisión de contenido o tuberías de IA. Los metadatos JSON ayudan con diagnósticos porque preservan evidencia de solicitud como estado, URL final, tamaño de respuesta y tipo de contenido. Capturas de pantalla y PDFs son útiles cuando un humano necesita prueba visual de lo que mostró la página renderizada.
| Formato de salida | Úsalo para | Ventaja de Next.js |
|---|---|---|
| HTML sin procesar | Rutas renderizadas en el servidor o estáticas | Rápido, amigable con el analizador y generalmente la captura de menor peso. |
| HTML renderizado | Rutas hidratadas y contenido construido por el navegador | Captura el DOM después de que JavaScript cambia la página. |
| Texto | Búsqueda, monitoreo, análisis ligero | Elimina el ruido de diseño cuando la estructura no es necesaria. |
| Markdown | IA, RAG, documentación, revisión de contenido | Mantiene encabezados, enlaces y secciones legibles para flujos de trabajo de modelos de lenguaje. |
| Metadatos JSON | Registro y decisiones de enrutamiento | Facilita la comparación de resultados de solicitudes a través de muestras de ruta. |
| Captura de pantalla o PDF | QA, revisión de cumplimiento, monitoreo visual, archivos | Muestra cómo se veía la página pública después de la captura. |
¿Cómo deberían los equipos probar las rutas de Next.js antes de la producción?
Prueba un pequeño conjunto de rutas representativas primero. Incluye una ruta estática, una ruta renderizada en el servidor, una ruta dinámica y una ruta que parece pesada del lado del cliente. Envía cada objetivo a través del API Builder, compara HTML fuente con salida renderizada, y elige el formato más pequeño que tu analizador o aplicación pueda usar directamente.
Ese conjunto de pruebas se convierte en tu manual de solicitudes. Las rutas simples pueden permanecer en HTML sin procesar. Las rutas construidas por el cliente pueden usar HTML renderizado o una salida más limpia de texto y Markdown. Las rutas que necesitan continuidad pueden agregar sesiones. Las rutas que dependen de idioma, región o contexto de enrutamiento pueden agregar encabezados, cookies, segmentación por país o entrega más fuerte solo cuando la evidencia lo respalde.
Conclusión práctica: construye el perfil de scraping de Next.js a partir de la evidencia de la ruta, no a partir de una suposición general sobre el marco.
¿Cómo mantiene ScraperFly el scraping de Next.js asequible?
El control de costos comienza evitando trabajo innecesario del navegador. Una página que devuelve HTML completo renderizado en el servidor no debería tener el mismo peso de solicitud que una ruta hidratada con esperas, salida visual, contexto de sesión y enrutamiento más fuerte. ScraperFly facilita esa decisión porque la misma ruta de API puede comenzar ligera y agregar controles solo cuando el objetivo demuestra que cambian el resultado.
Usa la fijación de precios como un bucle de retroalimentación de ingeniería. Clasifica patrones de ruta, mantén HTML sin procesar como el predeterminado para respuestas completas, reserva el renderizado para contenido del lado del cliente, y genera capturas de pantalla o PDFs solo cuando la prueba visual sea parte del flujo de trabajo. La página de precios y el calculador de costos de crédito de API de scraping web ayudan a los equipos a estimar cómo esas elecciones afectan el volumen antes de escalar.
¿Cómo se compara el scraping de Next.js con el scraping de React y SPA?
Next.js a menudo se sitúa entre el scraping clásico de HTML y el scraping completo de SPA. Puede comportarse como un sitio renderizado en el servidor, un sitio estático, una aplicación React hidratada o una aplicación de una sola página pesada del lado del cliente, dependiendo de la ruta. Eso hace que sea importante probar la URL pública real en lugar de tratar cada página de Next.js como un objetivo exclusivo del navegador.
Si el sitio se comporta como una aplicación React, la guía de API de scraping de React es una comparación útil. Si la navegación y el contenido dependen en gran medida del enrutamiento del lado del navegador, revisa el flujo de trabajo de la API de scraping de SPA. Si el objetivo te proporciona un marcado fuente completo, mantén la ruta de captura más cerca del enfoque de la API de scraping de HTML y guarda el navegador para las páginas que realmente lo necesiten.







