






Renderização React
Compare o HTML fonte com a saída renderizada antes de raspar o aplicativo
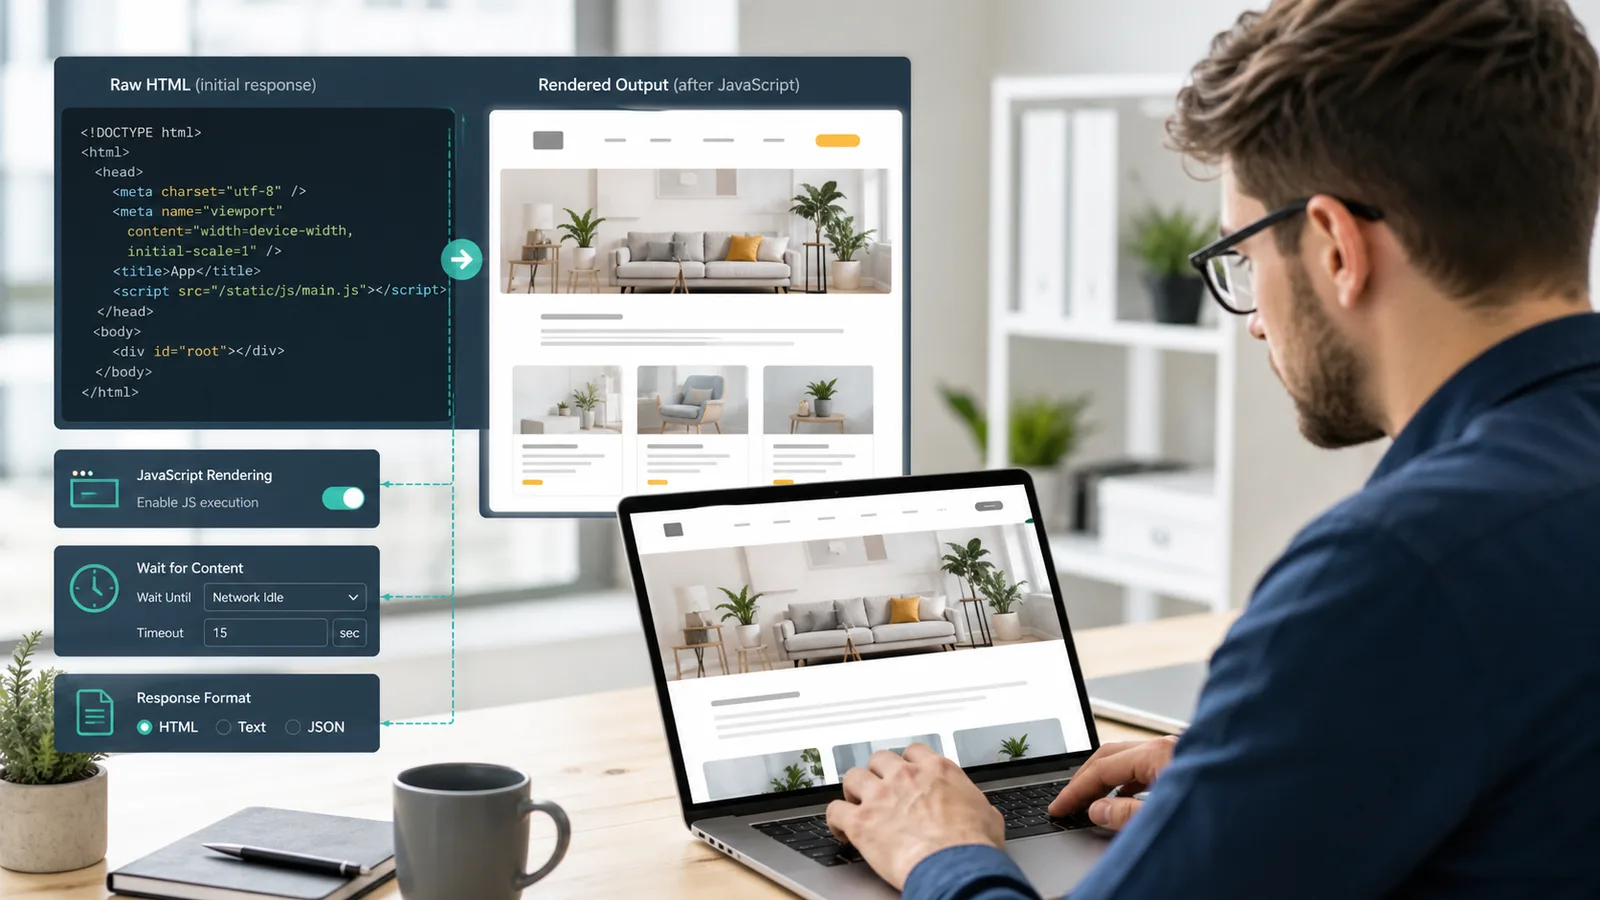
Sites React podem parecer completos em um navegador enquanto a primeira resposta HTML contém apenas uma pequena estrutura do aplicativo. ScraperFly ajuda as equipes a provar essa diferença antes de construir a lógica do parser, trabalhadores de fila ou infraestrutura de navegador em torno da resposta errada.
Comece com o HTML fonte, inspecione o que o alvo realmente retorna, depois habilite a renderização do navegador, esperas, sessões, cabeçalhos, roteamento por país ou saída visual apenas quando a página React renderizada fornecer evidências melhores para seu fluxo de trabalho.
Por que os sites React são diferentes para raspar?
Sites React frequentemente separam a primeira resposta do servidor da página que um usuário finalmente vê. O HTML fonte pode conter um elemento raiz, tags de script, metadados de rota, dados de hidratação ou um pequeno espaço reservado. Os cartões de produto úteis, seções de artigos, resultados de pesquisa, preços, tabelas, avaliações, filtros ou conteúdo de perfil podem aparecer apenas após a execução do JavaScript no navegador.
Isso não significa que toda página React precise do perfil de raspagem mais pesado. Algumas aplicações React ainda expõem metadados úteis, estado embutido, conteúdo renderizado no servidor ou cargas úteis estruturadas na resposta inicial. Outras precisam de HTML renderizado porque o conteúdo é construído do lado do cliente. O fluxo de trabalho prático é comparar ambos os estados antes de decidir como a página deve ser capturada.
Conclusão prática: A raspagem de React deve começar com evidências, não suposições sobre se a página precisa de um navegador.
O que você deve inspecionar antes de renderizar uma página React?
A primeira verificação é a resposta fonte. Procure o conteúdo útil, não apenas um código de status bem-sucedido. Uma resposta 200 ainda pode ser uma estrutura vazia se a página espera que o navegador busque dados, hidrate componentes e construa o DOM final. Inspecione o corpo, o tamanho da resposta, as cargas úteis de script, os metadados, a URL final e se os campos alvo aparecem no HTML que seu parser recebe.
Se o HTML fonte já contém os campos que você precisa, mantenha a solicitação simples. Se o HTML fonte não contém o conteúdo útil, compare a saída renderizada. Se a saída renderizada altera o DOM de maneira significativa, a renderização é justificada. Se a saída renderizada ainda estiver vazia, o problema pode ser tempo, roteamento, recursos bloqueados, uma rota ruim, conteúdo público indisponível ou uma página que requer um fluxo de trabalho diferente.
| Sinal React | O que isso significa | Melhor próximo passo |
|---|---|---|
| HTML fonte contém conteúdo alvo | A página provavelmente pode ser capturada sem renderização do navegador | Use uma solicitação HTML leve e construa o parser a partir de evidências da fonte. |
| HTML fonte é principalmente um elemento raiz e scripts | A página provavelmente constrói conteúdo útil no navegador | Teste o HTML renderizado antes de escrever a lógica de extração. |
| DOM renderizado contém os campos alvo | A execução do JavaScript altera o resultado da raspagem | Use renderização para este tipo de página e registre por que é necessário. |
| Página renderizada ainda está incompleta | O problema pode ser tempo, contexto da solicitação, roteamento ou comportamento do alvo | Inspecione o tempo de espera, status, URL final, tamanho da resposta e prova visual. |
| Página visual difere por região ou estado | A rota pode depender de localização, cookies, cabeçalhos ou continuidade de sessão | Adicione contexto deliberadamente em vez de tornar cada solicitação mais pesada. |
Quando o ScraperFly deve renderizar um site React?
Habilite a renderização quando o conteúdo público útil aparecer após a execução do JavaScript do lado do cliente. Exemplos comuns incluem grades de produtos React, resultados de pesquisa, painéis com dados públicos, páginas de artigos baseadas em rota, seções preguiçosas, widgets de avaliação, blocos de preços, filtros e páginas onde a primeira resposta HTML contém espaços reservados em vez do conteúdo final.
A renderização deve ser precisa. Não a ative apenas porque o site usa React; ative-a porque a resposta bruta não contém o que o fluxo de trabalho precisa e a resposta renderizada contém. Isso mantém páginas simples rápidas e acessíveis, enquanto ainda fornece páginas construídas pelo navegador o ambiente que precisam.
Para decisões mais amplas de captura de navegador, use o guia da API de renderização JavaScript e a página da API de raspagem de navegador sem cabeça. Para alvos de fonte-primeiro, compare a abordagem da API de raspagem HTML antes de tornar a renderização o padrão.
Qual formato de saída funciona melhor após a renderização do React?
HTML renderizado é a melhor escolha quando seu parser precisa do DOM final, seletores, atributos, links, tabelas, cartões de produtos ou conteúdo de rota. Texto e Markdown são melhores quando a página React deve alimentar pesquisa, resumos, contexto de IA, revisão de documentação ou ingestão RAG sem ruído de layout. Metadados JSON são úteis para registrar evidências de solicitação. Capturas de tela e PDFs são úteis quando um humano precisa verificar como a página renderizada parecia.
Essa escolha deve acontecer antes de construir conversores. Uma raspagem React que alimenta um parser pode precisar de HTML renderizado. Uma raspagem React que alimenta um LLM pode ser melhor como Markdown. Um fluxo de trabalho de monitoramento pode precisar de metadados mais uma captura de tela. Um fluxo de trabalho de conformidade ou QA pode precisar de um PDF. ScraperFly permite que a solicitação retorne a forma que o sistema downstream pode usar imediatamente.
| Fluxo de trabalho React | Saída para testar | Por que ajuda | Quando evitar |
|---|---|---|---|
| Parsing DOM | HTML renderizado | Retorna a página após o React construir a marcação útil | Quando o HTML fonte já contém os campos alvo. |
| Ingestão de conteúdo | Texto ou Markdown | Remove muito do ruído de layout antes da pesquisa ou processamento de IA | Quando seletores exatos ou relacionamentos DOM importam. |
| Diagnósticos | Metadados JSON | Mostra status, URL final, tipo de conteúdo, tamanho da resposta e contexto da solicitação | Quando o fluxo de trabalho espera campos alvo extraídos por conta própria. |
| QA Visual | Captura de tela | Confirma como a página pública renderizada parecia | Quando o fluxo de trabalho só precisa de texto legível por máquina. |
| Arquivo ou aprovação | Cria um registro portátil para revisão | Quando o conteúdo precisa de parsing automatizado frequente. |
Como devem ser tratados esperas, sessões, cabeçalhos e roteamento?
Páginas React podem falhar por razões que parecem semelhantes do lado de fora. Uma página pode precisar de tempo de espera extra porque os dados carregam após a renderização inicial. Pode precisar de cabeçalhos porque a rota pública espera contexto de idioma ou conteúdo. Pode precisar de sessões porque solicitações relacionadas dependem de cookies ou estado compartilhados. Pode precisar de roteamento por país porque o conteúdo muda por região, moeda ou disponibilidade. Pode precisar de entrega mais forte quando o caminho simples retorna repetidamente uma saída inutilizável.
A resposta certa não é habilitar tudo. Adicione um controle de cada vez e compare o resultado. Se uma espera corrigir conteúdo ausente, registre a razão do tempo. Se sessões mudarem a resposta, mantenha-as apenas para aquele fluxo relacionado. Se a região mudar a página, mantenha o roteamento por país vinculado ao alvo. Um fluxo de trabalho de raspagem React é mais fácil de operar quando cada controle habilitado tem uma razão visível.
Use sessões para fluxos públicos com estado, cabeçalhos personalizados para contexto de solicitação legítimo, e controles de roteamento quando o caminho de entrega muda o resultado.
Quais falhas são comuns ao raspar sites React?
A falha mais comum é tratar uma resposta fonte vazia como um bloqueio alvo quando na verdade é apenas uma estrutura normal do React. Outra falha comum é renderizar muito rapidamente e capturar a página antes que os dados do lado do cliente terminem de carregar. As equipes também enfrentam redirecionamentos de rota, conteúdo que muda por região, respostas excessivas, dados públicos ausentes, escolhas de saída não suportadas e fluxos de trabalho que esperam que a API extraia o estado da aplicação automaticamente.
Um bom tratamento de erros mantém esses casos separados. Compare HTML fonte, HTML renderizado, estado da captura de tela, URL final, status, tamanho da resposta e tempo de espera. Corrija entradas malformadas e opções não suportadas em vez de tentar novamente. Tente novamente falhas temporárias com retrocesso limitado. Escale o roteamento apenas quando evidências repetidas mostram que o caminho simples não é suficiente.
O bloco de tratamento de erros abaixo fornece uma estrutura de falha mais ampla. Para páginas React, a chave é distinguir "o navegador ainda não construiu a página" de "o alvo retornou uma página ruim" e de "o perfil da solicitação está errado."
Como a raspagem React pode permanecer acessível?
A renderização é poderosa, mas o trabalho do navegador é mais pesado do que uma simples solicitação HTML. O custo permanece previsível quando as equipes classificam alvos antes de escalar: páginas HTML brutas, páginas React renderizadas, páginas que precisam de esperas, rotas regionais, fluxos dependentes de sessão, capturas de QA visual e arquivos PDF. Cada classe deve ter seu próprio perfil de solicitação em vez de herdar um padrão caro.
É aqui que o caminho do ScraperFly é prático. Comece grátis, teste páginas React reais, mantenha capturas simples leves e use controles mais pesados apenas onde eles mudam a resposta. Um projeto pontual pode permanecer flexível com créditos, enquanto cargas de trabalho renderizadas recorrentes podem mudar para um plano mensal uma vez que o perfil esteja comprovado.
Revise preços após amostrar alvos reais, não antes. A estimativa útil é baseada em quantas páginas realmente precisam de renderização, esperas, saída visual, sessões ou entrega mais forte.
Onde uma equipe deve começar?
Comece no API Builder com uma URL pública React. Solicite HTML fonte primeiro. Se o conteúdo útil estiver ausente, habilite a renderização e compare o resultado. Em seguida, escolha o formato de resposta que seu fluxo de trabalho pode usar: HTML renderizado para parsers, texto ou Markdown para conteúdo legível, metadados JSON para diagnósticos, captura de tela ou PDF para prova visual.
Uma vez que o perfil da solicitação esteja comprovado, mova-o para cURL, Python, Node.js, uma fila de backend, um trabalho de monitoramento ou um fluxo de trabalho de agente. Mantenha o perfil explícito para que falhas futuras possam ser diagnosticadas a partir de evidências em vez de suposições.












