






Contexto da página em primeiro lugar
Inspecione os metadados antes que uma URL entre em seu pipeline
ScraperFly ajuda equipes a capturar o contexto prático em torno de uma página pública antes que essa URL se torne parte da busca, monitoramento, ingestão de IA, QA, enriquecimento ou relatórios. Em vez de tratar cada página como um trabalho de rastreamento, comece com uma resposta real e inspecione o que o alvo realmente retorna.
A resposta pode incluir URL final, status, tipo de conteúdo, tamanho da resposta, metadados, cabeçalhos, links, texto legível, Markdown e prova visual quando necessário. Isso dá aos desenvolvedores evidências suficientes para decidir se a página está pronta para processamento posterior ou se a renderização, cabeçalhos, sessões, segmentação por país ou entrega mais robusta melhorarão o resultado.
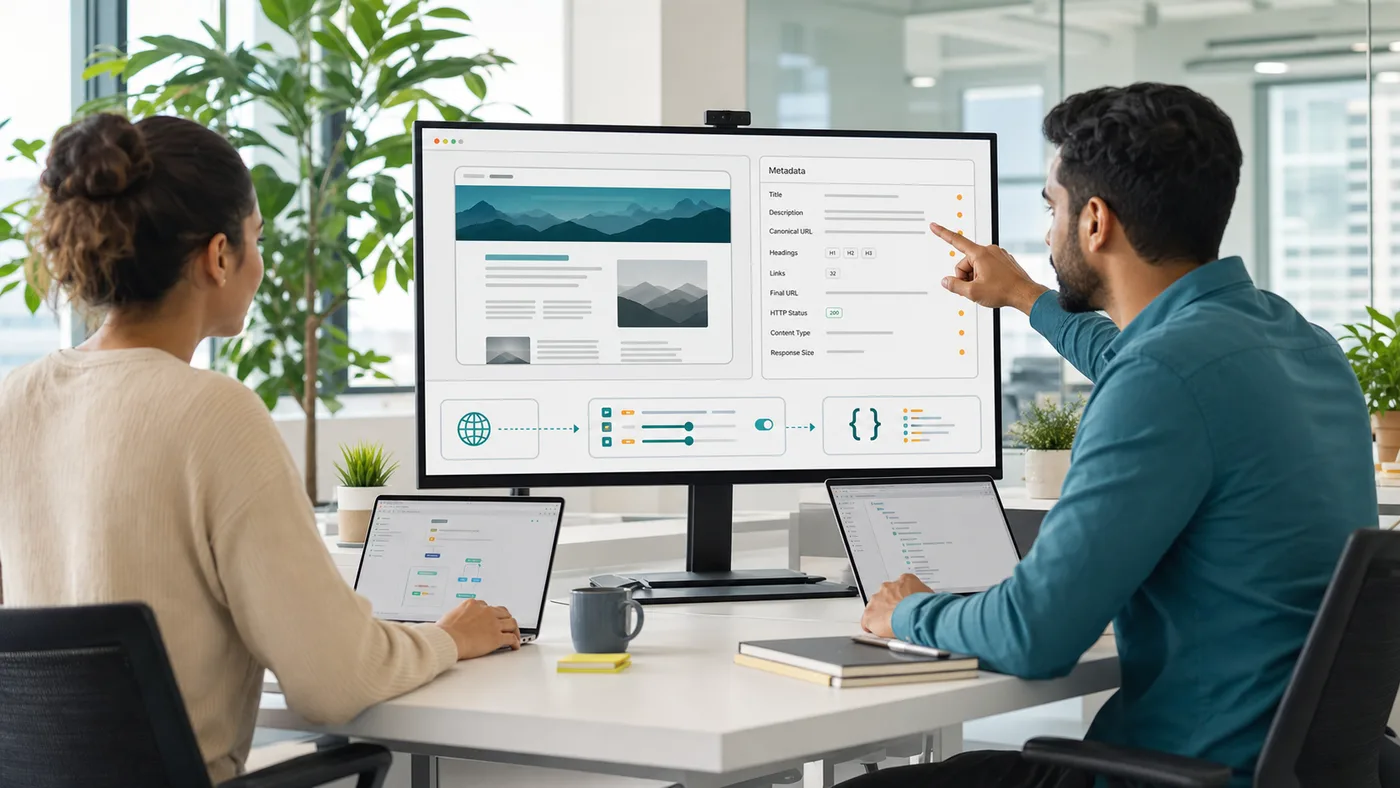
O que é uma API de metadados de página da web?
Uma API de metadados de página da web busca uma URL pública e retorna o contexto da página que ajuda um aplicativo a entender o que foi retornado. Esse contexto pode incluir o título da página, descrição meta, URL canônica, diretrizes de robôs, tags Open Graph, tags de cartão do Twitter, cabeçalhos, links, URL final, status HTTP, tipo de conteúdo, tamanho da resposta, texto limpo, Markdown, capturas de tela ou PDFs, dependendo do perfil de solicitação.
Isso é diferente de um rastreador completo ou de um conjunto de auditoria de SEO finalizado. A API de metadados fornece ao seu sistema evidências confiáveis da página solicitada. Seu produto pode então decidir o que armazenar, indexar, comparar, classificar, resumir, enriquecer ou enviar para outro fluxo de trabalho. Essa separação é importante porque mantém a página útil sem prometer análises de gráfico de links, monitoramento de links quebrados, rastreamento de classificação ou extração de campos específicos que pertencem a uma camada separada.
Resumo prático: use a captura de metadados de página da web quando seu produto precisar de contexto de página confiável antes de tomar uma decisão de armazenamento, análise, monitoramento ou IA.
Quais metadados as equipes devem capturar de uma página pública?
Os metadados corretos dependem do fluxo de trabalho. Um índice de busca pode se preocupar com título, descrição, cabeçalhos, URL canônica e contexto de corpo legível. Um fluxo de trabalho de QA pode precisar de URL final, status, tamanho da resposta, captura de tela e prova em PDF. Um pipeline de IA pode precisar de texto limpo ou Markdown com metadados de origem suficientes para explicar de onde veio a resposta. Um inventário de conteúdo pode precisar de links, cabeçalhos, idioma, sinais de publicação e relacionamentos de página.
ScraperFly é mais forte quando as equipes usam metadados como uma camada de decisão. Capture a resposta da página, inspecione os campos que importam e mantenha a solicitação leve, a menos que o alvo prove que precisa de mais ajuda. Se o HTML de origem já contiver o título da página, cabeçalhos, metadados e links úteis, uma solicitação simples geralmente é suficiente. Se o JavaScript do frontend alterar o contexto útil, a renderização pode ser adicionada para esse tipo de página.
| Área de metadados | Exemplos | Mais adequado para | Decisão de solicitação |
|---|---|---|---|
| Contexto da resposta | URL final, status, tipo de conteúdo, tamanho da resposta | Registro, QA, depuração, decisões de armazenamento | Capture em cada amostra representativa. |
| Metadados do cabeçalho HTML | Título, descrição meta, robôs, canônico | Indexação de busca, inventário de conteúdo, QA de página | Comece do HTML de origem e, em seguida, compare a renderização quando os campos estiverem ausentes. |
| Metadados de visualização social | Campos Open Graph e Twitter card | QA de visualização, revisão de conteúdo, enriquecimento | Valide modelos representativos antes de escalar. |
| Estrutura da página | Cabeçalhos H1-H3, seções, texto legível, Markdown | Ingestão de IA, verificações de qualidade de conteúdo, sumarização | Escolha Markdown ou texto quando os detalhes do DOM não forem necessários. |
| Links da página | Canônico, links internos, links externos, hreflang | Contexto de página única, dicas de descoberta, verificações de localização | Use como evidência da página, não como um gráfico de rastreamento completo por si só. |
| Prova visual | Captura de tela ou PDF | Arquivo, revisão, conformidade, QA humano | Adicione apenas quando um registro visual mudar o resultado do fluxo de trabalho. |
Quando a captura de metadados precisa de renderização?
A captura de metadados precisa de renderização quando a resposta de origem não contém o contexto da página que seu fluxo de trabalho precisa. Algumas páginas públicas enviam um cabeçalho HTML completo e cabeçalhos significativos imediatamente. Outras enviam uma camada de aplicativo fina e permitem que o JavaScript do lado do navegador atualize tags de título, conteúdo de rota, cabeçalhos dinâmicos, links, módulos de produto ou seções de corpo legíveis após o carregamento da página.
A movimentação prática é a comparação, não a suposição. Busque o HTML de origem primeiro. Se metadados, cabeçalhos e links úteis estiverem presentes, mantenha a solicitação leve. Se a página parecer vazia, genérica ou incompleta, compare uma resposta renderizada. Adicione esperas apenas quando o conteúdo que carrega tarde mudar a saída. Use sessões, cabeçalhos, segmentação por país ou roteamento mais forte apenas quando esses controles mudarem a evidência da resposta.
Para páginas onde o JavaScript é o fator decisivo, combine esse fluxo de trabalho com a API de renderização JavaScript. Para páginas onde a extração de links é o trabalho principal, use o guia mais restrito da API de parser de links de página da web. A captura de metadados está entre essas necessidades: ela fornece contexto de página suficiente para escolher o próximo passo de forma inteligente.
Como isso é diferente da análise de conteúdo?
A análise de conteúdo foca na substância que usuários ou sistemas a jusante irão consumir: texto limpo, Markdown, conteúdo principal, corpo do artigo, resumos ou saída estruturada. A captura de metadados foca nas evidências circundantes que dizem a um sistema o que a página é, o que aconteceu durante a entrega, como a página se identifica e se a resposta é confiável o suficiente para processamento adicional.
Ambos são úteis, mas respondem a perguntas diferentes. Um parser de conteúdo pergunta: "O que devemos ler ou extrair desta página?" Um fluxo de trabalho de metadados pergunta: "O que esta URL retornou, como devemos interpretá-la e vale a pena enviá-la para a próxima etapa?" ScraperFly pode suportar ambas as formas de resposta, para que as equipes possam começar com o contexto da página e depois passar para texto, Markdown, metadados JSON, capturas de tela, PDFs ou análise específica de destino quando o fluxo de trabalho exigir.
| Necessidade | Use metadados quando | Use análise de conteúdo quando |
|---|---|---|
| Preparação do índice de busca | Você precisa de título, canônico, cabeçalhos, status e contexto de origem. | Você precisa de um corpo limpo ou documento Markdown para indexação. |
| Ingestão de IA | Você precisa de proveniência, URL final, tipo de conteúdo e esboço da página. | Você precisa de conteúdo legível para embeddings, resumos ou respostas. |
| Monitoramento | Você precisa de status, tamanho da resposta, comportamento de redirecionamento e evidência visível. | Você precisa comparar campos específicos da página ao longo do tempo. |
| Descoberta | Você precisa de links e relacionamentos de página de uma resposta. | Você precisa de entidades extraídas da própria página. |
| Revisão humana | Você precisa de contexto suficiente para decidir se a resposta é válida. | Você precisa de um artigo limpo, registro de produto ou resumo da página. |
Como as equipes podem manter os fluxos de trabalho de metadados práticos?
Comece com URLs representativas e defina os campos que importam antes de escalar. Um fluxo de trabalho de metadados se torna barulhento quando todos os campos possíveis são coletados sem uma razão a jusante. Ele se torna frágil quando as equipes assumem que o HTML de origem, DOM renderizado, captura de tela e Markdown são intercambiáveis. Cada formato de saída tem um trabalho: metadados de resposta explicam a entrega, HTML preserva a estrutura, Markdown ajuda na leitura e ingestão de IA, JSON mantém o contexto operacional inspecionável e arquivos visuais provam como a página parecia.
O caminho de controle de custos é direto. Mantenha páginas simples no HTML de origem. Ative a renderização apenas quando o JavaScript mudar os metadados ou conteúdo legível. Use capturas de tela ou PDFs quando a prova visual for importante. Use segmentação por país, sessões, cabeçalhos e roteamento premium quando resolverem um problema de resposta demonstrado. Em seguida, copie o perfil de solicitação comprovado do API Builder para o aplicativo em vez de reconstruir a lógica de solicitação do zero.
Resumo prático: a captura de metadados é mais útil quando ajuda seu produto a tomar uma melhor decisão a seguir, não quando coleta campos apenas porque existem.
Onde o ScraperFly se encaixa em um pipeline de metadados?
ScraperFly se posiciona na camada de solicitação e resposta. Ele busca a página pública, aplica os controles que seu alvo precisa e retorna a forma de resposta que seu fluxo de trabalho pode usar. Um pipeline de metadados pode então armazenar o contexto da resposta, passar texto limpo ou Markdown para sistemas de IA, registrar capturas de tela para QA, comparar a estrutura da página ou entregar links selecionados para um fluxo de descoberta separado.
Isso mantém a propriedade clara. ScraperFly ajuda com captura, renderização, roteamento, formatos de resposta, arquivos e evidência de solicitação. Seu aplicativo possui estratégia de rastreamento, pontuação, desduplicação, regras de enriquecimento, alertas e decisões de negócios. Essa separação torna o sistema mais fácil de depurar, pois cada estágio tem um trabalho claro.



