






Captura pronta para parser
Transforme páginas públicas em entradas limpas que seu próprio parser pode confiar
A análise do conteúdo do site começa antes que as regras de extração sejam escritas. Sua equipe precisa saber o que a página pública realmente retorna, se o conteúdo útil está no HTML fonte ou na saída renderizada, e qual formato de resposta tornará a análise posterior mais fácil em vez de mais confusa.
ScraperFly oferece aos desenvolvedores uma camada de captura prática para o conteúdo de sites públicos. Busque a página, inspecione a resposta, escolha HTML, texto, Markdown, metadados, capturas de tela ou PDFs, e mantenha a lógica de análise, classificação, enriquecimento e armazenamento dentro do seu próprio produto, onde as regras de negócios pertencem.
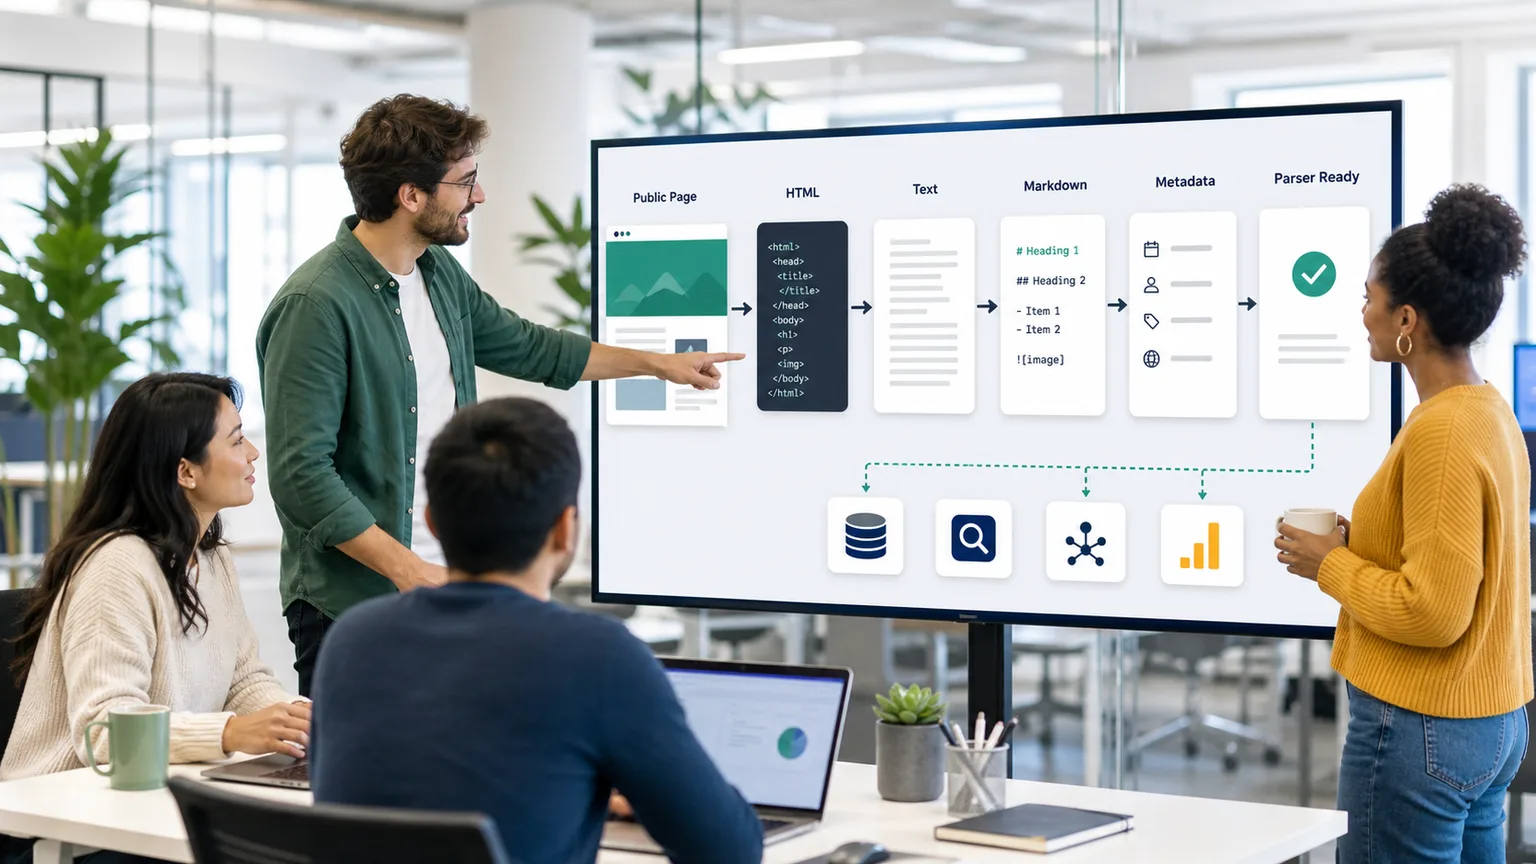
O que é uma API de conteúdo de site para análise?
Uma API de conteúdo de site para análise é útil quando fornece à sua aplicação uma entrada de página confiável para um parser, pipeline de conteúdo, índice de busca, fluxo de trabalho de IA, arquivo ou sistema de revisão de qualidade. A API deve capturar a página pública de forma confiável e retornar estrutura suficiente para que seu código downstream decida o que é importante.
ScraperFly foca na camada de captura e resposta. Pode retornar HTML bruto ou renderizado quando a estrutura do DOM é importante, texto quando o parser só precisa de conteúdo legível, Markdown quando cabeçalhos e links ajudam na revisão ou ingestão de IA, metadados JSON quando os logs precisam de contexto operacional, e arquivos visuais quando um humano precisa de prova de como a página apareceu.
Resumo prático: use ScraperFly para capturar conteúdo de sites públicos de forma limpa, e mantenha regras de análise específicas para o alvo no sistema que entende seu modelo de dados.
O que deve acontecer antes de construir regras de análise?
O erro caro é escrever parsers contra uma forma de página imaginada. Um site público pode expor conteúdo útil na primeira resposta HTML, escondê-lo atrás da renderização do lado do cliente, repeti-lo na navegação, movê-lo para metadados, ou retornar uma pequena estrutura que diz muito pouco até que um navegador seja executado. O primeiro trabalho é provar a forma de captura.
Comece com uma solicitação simples, inspecione o status, a URL final, o tipo de conteúdo, o tamanho da resposta e o conteúdo do corpo, e então decida o que o parser deve consumir. Se o HTML fonte já contém o conteúdo alvo, mantenha a solicitação leve. Se o JavaScript altera o resultado, teste a saída renderizada. Se o pipeline é voltado para IA, compare texto limpo e Markdown antes de construir conversores.
| Pergunta | O que inspecionar | Melhor decisão |
|---|---|---|
| O conteúdo útil já está presente? | HTML fonte, tamanho da resposta, cabeçalhos, links, tabelas, cartões de produto, corpo do artigo ou metadados incorporados. | Use uma solicitação HTML ou texto leve quando a primeira resposta for suficiente. |
| O JavaScript cria a página final? | Compare HTML fonte com HTML renderizado e estado visível da página. | Ative a renderização apenas quando a execução do navegador alterar o conteúdo capturado. |
| O parser precisa da estrutura do DOM? | Seletores, atributos, listas, links, paginação, tabelas estruturadas e blocos repetidos. | Use HTML quando as relações estruturais importam. |
| O consumidor é um fluxo de trabalho de IA ou revisão? | Cabeçalhos legíveis, links, seções de artigo, boilerplate e ruído de layout repetido. | Tente texto ou Markdown antes de construir uma camada de limpeza personalizada. |
| O resultado precisa de evidências? | Status, URL final, tipo de conteúdo, captura de tela, PDF ou artefato de arquivo. | Adicione metadados ou saída visual quando depuração, QA, conformidade ou revisão precisarem de prova. |
Qual formato de saída é melhor para analisar conteúdo de site?
Nenhum formato único é o melhor para todos os parsers. HTML é poderoso quando a lógica de extração precisa da estrutura do DOM, mas também traz navegação, layout, scripts e ruído de template repetido. Texto é compacto e fácil de pesquisar, mas remove a maior parte do contexto estrutural. Markdown é útil para fluxos de trabalho de conteúdo legível porque cabeçalhos, links e listas permanecem mais fáceis de entender. Metadados ajudam a depurar a solicitação sem forçar o parser a inferir tudo do corpo.
O caminho prático é testar duas ou três saídas em páginas-alvo reais antes da produção. Um parser para conteúdo de artigo pode preferir Markdown. Um trabalho de descoberta de links pode precisar de HTML. Um trabalho de monitoramento pode combinar texto com metadados JSON. Um fluxo de trabalho de QA pode anexar capturas de tela ou PDFs apenas para registros que precisam de revisão visual.
| Saída | Use quando | Observe a troca |
|---|---|---|
| HTML | O parser precisa de seletores, atributos, links, tabelas, dados incorporados ou padrões de DOM repetidos. | Requer limpeza e lógica de análise específica para o alvo. |
| HTML renderizado | A resposta fonte está incompleta até que o JavaScript construa a página. | Mais pesado do que uma solicitação básica, então ative-o para alvos comprovados. |
| Texto | O fluxo de trabalho precisa de conteúdo legível compacto para correspondência, pesquisa, resumos ou classificação. | O contexto estrutural é reduzido. |
| Markdown | Cabeçalhos, links, listas e seções legíveis ajudam IA, RAG, documentação ou revisão de analistas. | Não é um substituto para extração precisa do DOM. |
| Metadados JSON | Logs precisam de URL final, status, tipo de conteúdo, tempo ou contexto de resposta. | Metadados explicam a solicitação; não inventam campos de alvo personalizados. |
| Captura de tela ou PDF | Um revisor ou arquivo precisa de prova visual do estado da página pública. | Menos conveniente para análise de máquina e mais pesado do que a saída de texto. |
Compare o conjunto completo de formatos na página de formatos de resposta da API de web scraping, e então teste uma URL real no API Builder.
Quando a renderização ajuda um parser de conteúdo?
A renderização ajuda quando a execução do navegador altera o conteúdo útil. Isso é comum em páginas que hidratam corpos de artigos, cartões de produtos, listagens, avaliações, comentários, resultados de busca ou conteúdo específico de rota após a primeira resposta HTML. Não é um selo de qualidade por si só. Renderizar cada página pode tornar um parser mais lento, mais pesado e mais difícil de entender.
Um bom fluxo de trabalho de parser compara a captura de fonte bruta com a captura renderizada antes de escolher um padrão padrão. Se o HTML bruto contém os dados, mantenha o caminho simples. Se a página retorna uma estrutura vazia, conteúdo atrasado ou um DOM final diferente após a execução do código do lado do cliente, use a API de renderização JavaScript e escolha a menor saída útil após a renderização.
Onde deve viver a lógica de análise?
ScraperFly não deve ser tratado como uma caixa preta que magicamente conhece o significado comercial de cada alvo. Seu produto sabe qual preço importa, qual seção do artigo é importante, quais campos de revisão são aceitáveis, quais variantes de página são válidas e como o conteúdo extraído deve ser armazenado. Essa lógica pertence à sua aplicação.
ScraperFly torna essa aplicação mais fácil de construir ao lidar com a camada de solicitação: buscando páginas públicas, renderizando quando necessário, preservando cabeçalhos ou sessões quando o alvo requer contexto, roteando através de um país quando o conteúdo público difere por localização, e retornando formatos que reduzem o trabalho de limpeza. Seu parser pode então se concentrar nas regras específicas para o alvo que criam valor.
Para captura básica de marcação, veja a API de scraping de HTML. Para entradas legíveis downstream, compare as páginas da API de parser de HTML para texto e API de parser de HTML para Markdown.
Como o ScraperFly mantém os fluxos de trabalho de análise práticos?
Projetos de análise muitas vezes começam com alvos desconhecidos. Algumas páginas são simples. Algumas precisam de renderização. Algumas precisam de cabeçalhos, cookies, direcionamento por país ou roteamento premium. Algumas não devem ser escaladas até que a forma da resposta seja comprovada. ScraperFly suporta esse caminho incremental em vez de forçar o perfil de solicitação mais pesado desde o primeiro dia.
Comece grátis, teste páginas-alvo representativas e mantenha cada fonte no perfil de solicitação mais leve que retorne conteúdo utilizável completo. Use créditos pay-as-you-go enquanto o comportamento e o volume do alvo ainda são incertos, e então mova cargas de trabalho de parser recorrentes para créditos mensais uma vez que a demanda seja previsível. Isso mantém o esforço de engenharia e o custo da solicitação atrelados a evidências, não a suposições.
Resumo prático: o melhor parser de conteúdo de site começa com uma forma de captura comprovada, um pequeno conjunto de formatos de resposta e um caminho claro de atualização para alvos mais difíceis.










