






Спочатку контекст сторінки
Перевірте метадані перед тим, як URL потрапить у ваш конвеєр
ScraperFly допомагає командам захоплювати практичний контекст навколо публічної сторінки перед тим, як цей URL стане частиною пошуку, моніторингу, споживання AI, контролю якості, збагачення або звітності. Замість того, щоб розглядати кожну сторінку як завдання для обходу, почніть з одного реального відгуку та перевірте, що насправді повертає ціль.
Відповідь може включати фінальний URL, статус, тип контенту, розмір відповіді, метадані, заголовки, посилання, читабельний текст, Markdown та візуальне підтвердження, коли це необхідно. Це дає розробникам достатньо доказів, щоб вирішити, чи готова сторінка до подальшої обробки, чи покращить рендеринг, заголовки, сесії, цільове націлювання або більш потужна доставка результат.
Що таке API метаданих веб-сторінок?
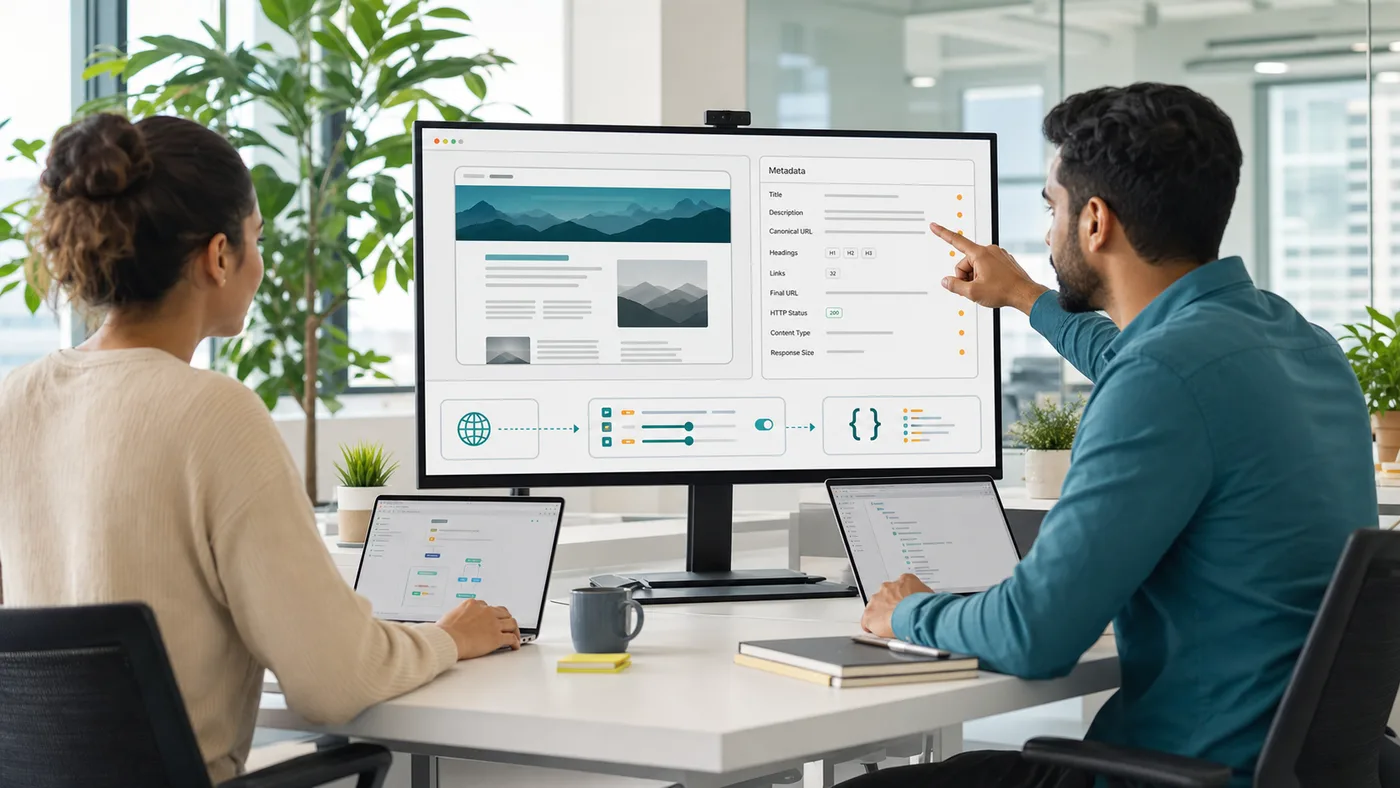
API метаданих веб-сторінок отримує публічний URL і повертає контекст сторінки, який допомагає додатку зрозуміти, що повернулося. Цей контекст може включати заголовок сторінки, метаопис, канонічний URL, директиви для роботів, теги Open Graph, теги карток Twitter, заголовки, посилання, фінальний URL, HTTP статус, тип контенту, розмір відповіді, чистий текст, Markdown, скріншоти або PDF в залежності від профілю запиту.
Це відрізняється від повного обходчика або завершеного набору SEO-аудиту. API метаданих надає вашій системі надійні докази з запитуваної сторінки. Ваш продукт може потім вирішити, що зберігати, індексувати, порівнювати, класифікувати, підсумовувати, збагачувати або передавати в інший робочий процес. Ця межа важлива, оскільки вона зберігає сторінку корисною, не обіцяючи аналітики графа посилань, моніторингу зламаних посилань, відстеження ранжування або вилучення полів, специфічних для цілей, які належать до окремого шару.
Практичний висновок: використовуйте захоплення метаданих веб-сторінок, коли вашому продукту потрібен надійний контекст сторінки перед тим, як він прийме рішення про зберігання, парсинг, моніторинг або AI.
Які метадані повинні захоплювати команди з публічної сторінки?
Правильні метадані залежать від робочого процесу. Пошуковий індекс може цікавитися заголовком, описом, заголовками, канонічним URL та читабельним контекстом тіла. Робочий процес контролю якості може потребувати фінального URL, статусу, розміру відповіді, скріншоту та підтвердження PDF. AI-потік може потребувати чистого тексту або Markdown з достатньою метаданою джерела, щоб пояснити, звідки прийшла відповідь. Інвентаризація контенту може потребувати посилань, заголовків, мови, сигналів публікації та відносин сторінок.
ScraperFly є найсильнішим, коли команди використовують метадані як шар прийняття рішень. Захоплюйте відповідь сторінки, перевіряйте важливі поля та зберігайте запит легким, якщо ціль не доведе, що їй потрібна додаткова допомога. Якщо вихідний HTML вже містить заголовок сторінки, заголовки, метадані та корисні посилання, простий запит зазвичай достатній. Якщо фронтенд JavaScript змінює корисний контекст, рендеринг може бути доданий для цього типу сторінки.
| Область метаданих | Приклади | Найкраще підходить для | Рішення запиту |
|---|---|---|---|
| Контекст відповіді | Фінальний URL, статус, тип контенту, розмір відповіді | Логування, контроль якості, налагодження, рішення про зберігання | Захоплюйте на кожному репрезентативному зразку. |
| Метадані HTML заголовка | Заголовок, метаопис, роботи, канонічний | Пошукова індексація, інвентаризація контенту, контроль якості сторінок | Почніть з вихідного HTML, а потім порівняйте рендеринг, коли поля відсутні. |
| Метадані соціального попереднього перегляду | Поля Open Graph та карток Twitter | Контроль якості попереднього перегляду, огляд контенту, збагачення | Перевірте репрезентативні шаблони перед масштабуванням. |
| Структура сторінки | Заголовки H1-H3, секції, читабельний текст, Markdown | Споживання AI, перевірки якості контенту, підсумовування | Виберіть Markdown або текст, коли деталі DOM не потрібні. |
| Посилання на сторінку | Канонічний, внутрішні посилання, зовнішні посилання, hreflang | Контекст односторінкової, підказки для відкриття, перевірки локалізації | Використовуйте як доказ сторінки, а не як повний граф обходу сам по собі. |
| Візуальне підтвердження | Скріншот або захоплення PDF | Архів, огляд, відповідність, контроль якості людиною | Додавайте лише тоді, коли візуальний запис змінює результат робочого процесу. |
Коли захоплення метаданих потребує рендерингу?
Захоплення метаданих потребує рендерингу, коли вихідна відповідь не містить контексту сторінки, який потрібен вашому робочому процесу. Деякі публічні сторінки надсилають повний HTML заголовок і значущі заголовки відразу. Інші надсилають тонку оболонку програми і дозволяють JavaScript на стороні браузера оновлювати теги заголовків, маршрутизувати контент, динамічні заголовки, посилання, модулі продуктів або читабельні секції тіла після завантаження сторінки.
Практичний крок - це порівняння, а не припущення. Спочатку отримайте вихідний HTML. Якщо метадані, заголовки та корисні посилання присутні, зберігайте запит легким. Якщо сторінка виглядає порожньою, загальною або неповною, порівняйте рендерену відповідь. Додавайте затримки лише тоді, коли контент, що завантажується пізніше, змінює вихід. Використовуйте сесії, заголовки, цільове націлювання або більш потужну маршрутизацію лише тоді, коли ці контролі змінюють докази відповіді.
Для сторінок, де JavaScript є вирішальним фактором, поєднайте цей робочий процес з API рендерингу JavaScript. Для сторінок, де вилучення посилань є основним завданням, використовуйте вужчий API парсера посилань веб-сторінок. Захоплення метаданих знаходиться між цими потребами: воно надає достатньо контексту сторінки, щоб розумно вибрати наступний крок.
Чим це відрізняється від парсингу контенту?
Парсинг контенту зосереджується на сутності, яку споживатимуть користувачі або системи нижнього рівня: чистий текст, Markdown, основний контент, тіло статті, підсумки або структурований вихід. Захоплення метаданих зосереджується на навколишніх доказах, які говорять системі, що таке сторінка, що сталося під час доставки, як сторінка ідентифікує себе і чи є відповідь достатньо надійною для подальшої обробки.
Обидва є корисними, але вони відповідають на різні запитання. Парсер контенту запитує: "Що ми повинні прочитати або вилучити з цієї сторінки?" Робочий процес метаданих запитує: "Що повернув цей URL, як ми повинні це інтерпретувати і чи варто це відправляти на наступний етап?" ScraperFly може підтримувати обидва формати відповіді, тому команди можуть почати з контексту сторінки, а потім перейти до тексту, Markdown, JSON метаданих, скріншотів, PDF або специфічного парсингу, коли це потрібно в робочому процесі.
| Потреба | Використовуйте метадані, коли | Використовуйте парсинг контенту, коли |
|---|---|---|
| Підготовка до пошукового індексу | Вам потрібні заголовок, канонічний, заголовки, статус і контекст джерела. | Вам потрібен чистий текст або документ Markdown для індексації. |
| Споживання AI | Вам потрібні походження, фінальний URL, тип контенту та структура сторінки. | Вам потрібен читабельний контент для вбудовування, підсумків або відповідей. |
| Моніторинг | Вам потрібні статус, розмір відповіді, поведінка перенаправлення та видимі докази. | Вам потрібно порівняти конкретні поля сторінки з часом. |
| Відкриття | Вам потрібні посилання та відносини сторінки з однієї відповіді. | Вам потрібні вилучені сутності з самої сторінки. |
| Огляд людиною | Вам потрібен достатній контекст, щоб вирішити, чи є відповідь дійсною. | Вам потрібна очищена стаття, запис продукту або підсумок сторінки. |
Як команди можуть зберегти робочі процеси метаданих практичними?
Почніть з репрезентативних URL і визначте важливі поля перед масштабуванням. Робочий процес метаданих стає шумним, коли збираються всі можливі поля без подальшої причини. Він стає крихким, коли команди вважають, що вихідний HTML, рендерений DOM, скріншот і Markdown є взаємозамінними. Кожен формат виходу має свою задачу: метадані відповіді пояснюють доставку, HTML зберігає структуру, Markdown допомагає читанню та споживанню AI, JSON зберігає оперативний контекст для перевірки, а візуальні файли підтверджують, як виглядала сторінка.
Шлях контролю витрат простий. Залишайте прості сторінки на вихідному HTML. Увімкніть рендеринг лише тоді, коли JavaScript змінює метадані або читабельний контент. Використовуйте скріншоти або PDF, коли візуальне підтвердження важливе. Використовуйте цільове націлювання, сесії, заголовки та преміум маршрутизацію, коли вони вирішують продемонстровану проблему відповіді. Потім скопіюйте перевірений профіль запиту з API Builder у додаток замість того, щоб відновлювати логіку запиту з нуля.
Практичний висновок: захоплення метаданих є найбільш корисним, коли воно допомагає вашому продукту приймати краще наступне рішення, а не коли воно збирає поля лише тому, що вони існують.
Де ScraperFly вписується в метадані?
ScraperFly знаходиться на рівні запиту та відповіді. Він отримує публічну сторінку, застосовує контролі, які потрібні вашій цілі, і повертає форму відповіді, яку може використовувати ваш робочий процес. Метадані можуть зберігати контекст відповіді, передавати чистий текст або Markdown системам AI, записувати скріншоти для контролю якості, порівнювати структуру сторінки або передавати вибрані посилання в окремий робочий процес відкриття.
Це зберігає чіткість власності. ScraperFly допомагає з захопленням, рендерингом, маршрутизацією, форматами відповіді, файлами та доказами запиту. Ваша програма володіє стратегією обходу, оцінюванням, дедуплікацією, правилами збагачення, сповіщеннями та бізнес-рішеннями. Це розділення робить систему легшою для налагодження, оскільки кожен етап має чітку задачу.



