






Сначала контекст страницы
Проверьте метаданные перед тем, как URL попадет в ваш поток
ScraperFly помогает командам захватывать практический контекст вокруг публичной страницы до того, как этот URL станет частью поиска, мониторинга, обработки ИИ, контроля качества, обогащения или отчетности. Вместо того чтобы рассматривать каждую страницу как задачу обхода, начните с одного реального ответа и проверьте, что на самом деле возвращает целевой ресурс.
Ответ может включать конечный URL, статус, тип контента, размер ответа, метаданные, заголовки, ссылки, читаемый текст, Markdown и визуальные доказательства, когда это необходимо. Это дает разработчикам достаточно доказательств, чтобы решить, готова ли страница к дальнейшей обработке или улучшит ли рендеринг, заголовки, сессии, таргетинг по странам или более сильная доставка результат.
Что такое API метаданных веб-страниц?
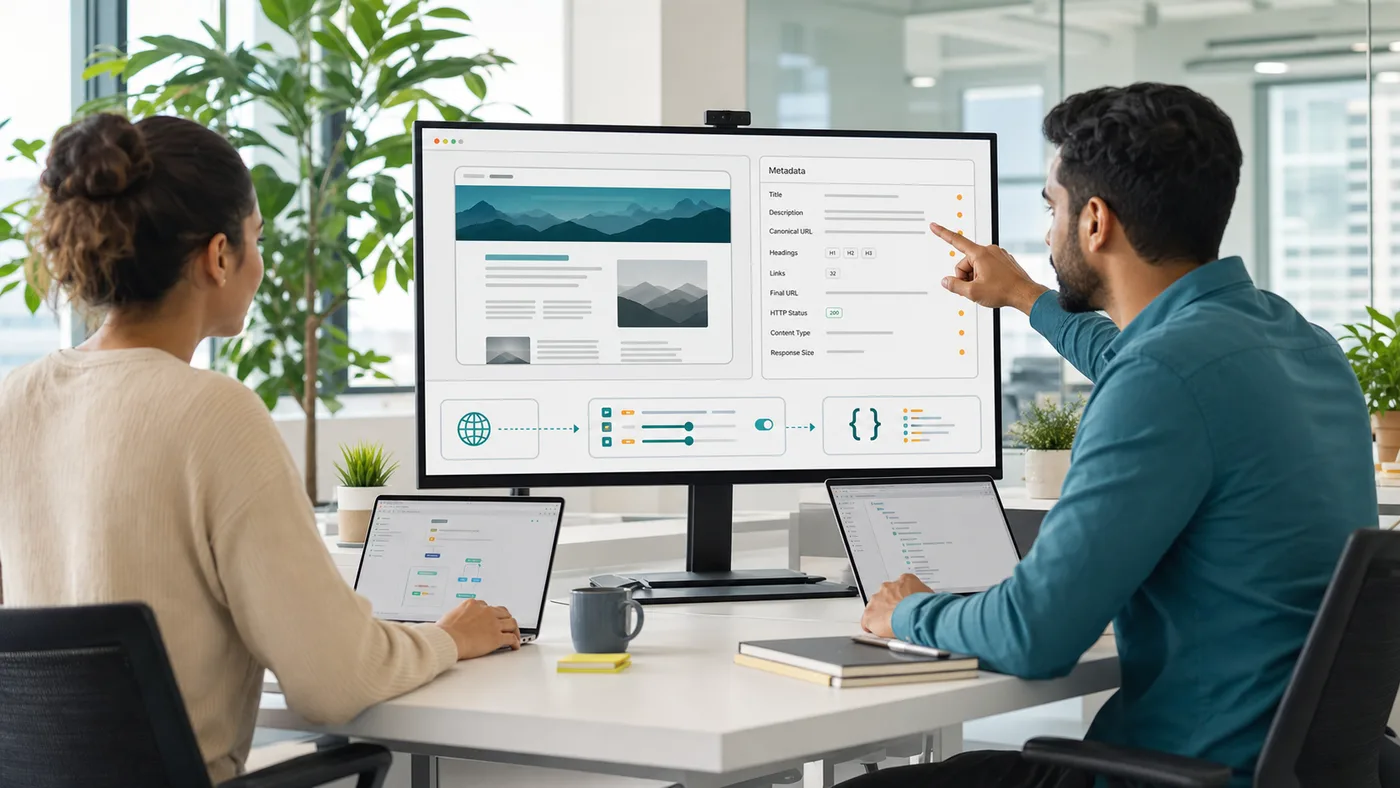
API метаданных веб-страниц извлекает публичный URL и возвращает контекст страницы, который помогает приложению понять, что вернулось. Этот контекст может включать заголовок страницы, метаописание, канонический URL, директивы для роботов, теги Open Graph, теги Twitter card, заголовки, ссылки, конечный URL, HTTP статус, тип контента, размер ответа, чистый текст, Markdown, скриншоты или PDF в зависимости от профиля запроса.
Это отличается от полного обходчика или завершенного набора инструментов SEO-аудита. API метаданных предоставляет вашей системе надежные доказательства с запрашиваемой страницы. Ваш продукт может затем решить, что хранить, индексировать, сравнивать, классифицировать, обобщать, обогащать или отправлять в другой поток. Эта граница важна, потому что она сохраняет полезность страницы, не обещая аналитики графа ссылок, мониторинга битых ссылок, отслеживания рангов или извлечения полей, специфичных для цели, которые принадлежат отдельному слою.
Практическое резюме: используйте захват метаданных веб-страниц, когда вашему продукту нужен надежный контекст страницы перед тем, как он примет решение о хранении, парсинге, мониторинге или ИИ.
Какие метаданные должны захватывать команды с публичной страницы?
Правильные метаданные зависят от рабочего процесса. Поисковый индекс может интересоваться заголовком, описанием, заголовками, каноническим URL и читаемым контекстом тела. Рабочий процесс контроля качества может потребовать конечный URL, статус, размер ответа, скриншот и PDF-доказательства. Поток ИИ может потребовать чистый текст или Markdown с достаточными исходными метаданными, чтобы объяснить, откуда пришел ответ. Инвентаризация контента может потребовать ссылки, заголовки, язык, сигналы публикации и отношения страниц.
ScraperFly наиболее эффективен, когда команды используют метаданные как уровень принятия решений. Захватывайте ответ страницы, проверяйте важные поля и держите запрос легким, если целевой ресурс не докажет, что ему нужна дополнительная помощь. Если исходный HTML уже содержит заголовок страницы, заголовки, метаданные и полезные ссылки, простого запроса обычно достаточно. Если фронтенд JavaScript изменяет полезный контекст, рендеринг можно добавить для этого типа страницы.
| Область метаданных | Примеры | Лучше всего подходит для | Решение по запросу |
|---|---|---|---|
| Контекст ответа | Конечный URL, статус, тип контента, размер ответа | Логирование, контроль качества, отладка, решения по хранению | Захватывайте на каждом репрезентативном образце. |
| Метаданные HTML заголовка | Заголовок, метаописание, роботы, канонический | Поисковая индексация, инвентаризация контента, контроль качества страниц | Начните с исходного HTML, затем сравните рендеринг, когда поля отсутствуют. |
| Метаданные социального превью | Поля Open Graph и Twitter card | Контроль качества превью, обзор контента, обогащение | Проверьте репрезентативные шаблоны перед масштабированием. |
| Структура страницы | Заголовки H1-H3, секции, читаемый текст, Markdown | Потребление ИИ, проверки качества контента, обобщение | Выбирайте Markdown или текст, когда детали DOM не нужны. |
| Ссылки страницы | Канонический, внутренние ссылки, внешние ссылки, hreflang | Контекст одной страницы, подсказки для открытия, проверки локализации | Используйте как доказательство страницы, а не как полный граф обхода сам по себе. |
| Визуальные доказательства | Скриншот или захват PDF | Архив, обзор, соблюдение, человеческий контроль качества | Добавляйте только тогда, когда визуальная запись изменяет результат рабочего процесса. |
Когда захват метаданных требует рендеринга?
Захват метаданных требует рендеринга, когда исходный ответ не содержит контекста страницы, необходимого вашему рабочему процессу. Некоторые публичные страницы сразу отправляют полный HTML заголовка и значимые заголовки. Другие отправляют тонкую оболочку приложения и позволяют JavaScript на стороне браузера обновлять теги заголовков, маршрутизировать контент, динамические заголовки, ссылки, модули продуктов или читаемые секции тела после загрузки страницы.
Практическое решение — это сравнение, а не предположение. Сначала извлеките исходный HTML. Если метаданные, заголовки и полезные ссылки присутствуют, держите запрос легким. Если страница выглядит пустой, общей или неполной, сравните рендеринг ответа. Добавляйте ожидания только тогда, когда контент, загружаемый поздно, изменяет вывод. Используйте сессии, заголовки, таргетинг по странам или более сильную маршрутизацию только тогда, когда эти элементы управления изменяют доказательства ответа.
Для страниц, где JavaScript является решающим фактором, сочетайте этот рабочий процесс с API рендеринга JavaScript. Для страниц, где извлечение ссылок является основной задачей, используйте более узкое руководство API парсера ссылок веб-страниц. Захват метаданных находится между этими потребностями: он предоставляет достаточно контекста страницы, чтобы разумно выбрать следующий шаг.
Как это отличается от парсинга контента?
Парсинг контента сосредоточен на содержании, которое downstream пользователи или системы будут потреблять: чистый текст, Markdown, основной контент, тело статьи, резюме или структурированный вывод. Захват метаданных сосредоточен на окружающих доказательствах, которые говорят системе, что такое страница, что произошло во время доставки, как страница идентифицирует себя и достаточно ли ответ надежен для дальнейшей обработки.
Оба полезны, но они отвечают на разные вопросы. Парсер контента спрашивает: "Что мы должны читать или извлекать с этой страницы?" Рабочий процесс метаданных спрашивает: "Что вернул этот URL, как мы должны это интерпретировать и стоит ли отправлять это на следующий этап?" ScraperFly может поддерживать обе формы ответа, так что команды могут начать с контекста страницы, а затем перейти к тексту, Markdown, JSON метаданным, скриншотам, PDF или парсингу, специфичному для цели, когда это требуется рабочим процессом.
| Потребность | Используйте метаданные, когда | Используйте парсинг контента, когда |
|---|---|---|
| Подготовка поискового индекса | Вам нужны заголовок, канонический, заголовки, статус и исходный контекст. | Вам нужен чистый текст или документ Markdown для индексации. |
| Потребление ИИ | Вам нужны происхождение, конечный URL, тип контента и структура страницы. | Вам нужно читаемое содержимое для встраивания, резюме или ответов. |
| Мониторинг | Вам нужны статус, размер ответа, поведение перенаправления и видимые доказательства. | Вам нужно сравнить конкретные поля страницы с течением времени. |
| Открытие | Вам нужны ссылки и отношения страниц из одного ответа. | Вам нужно извлеченные сущности с самой страницы. |
| Человеческий обзор | Вам нужен достаточный контекст, чтобы решить, является ли ответ действительным. | Вам нужен очищенный артикул, запись продукта или резюме страницы. |
Как команды могут сохранить рабочие процессы метаданных практичными?
Начните с репрезентативных URL и определите важные поля перед масштабированием. Рабочий процесс метаданных становится шумным, когда собираются все возможные поля без дальнейшей причины. Он становится хрупким, когда команды предполагают, что исходный HTML, рендеренный DOM, скриншот и Markdown взаимозаменяемы. Каждый формат вывода имеет свою задачу: метаданные ответа объясняют доставку, HTML сохраняет структуру, Markdown помогает чтению и потреблению ИИ, JSON сохраняет операционный контекст для проверки, а визуальные файлы доказывают, как выглядела страница.
Путь контроля затрат прост. Держите простые страницы на исходном HTML. Включайте рендеринг только тогда, когда JavaScript изменяет метаданные или читаемое содержимое. Используйте скриншоты или PDF, когда визуальные доказательства важны. Используйте таргетинг по странам, сессии, заголовки и премиум маршрутизацию, когда они решают продемонстрированную проблему ответа. Затем скопируйте проверенный профиль запроса из API Builder в приложение, а не создавайте логику запроса с нуля.
Практическое резюме: захват метаданных наиболее полезен, когда он помогает вашему продукту принять лучшее следующее решение, а не когда он собирает поля только потому, что они существуют.
Где ScraperFly вписывается в поток метаданных?
ScraperFly находится на уровне запросов и ответов. Он извлекает публичную страницу, применяет необходимые вашему целевому ресурсу элементы управления и возвращает форму ответа, которую может использовать ваш рабочий процесс. Поток метаданных может затем хранить контекст ответа, передавать чистый текст или Markdown в системы ИИ, записывать скриншоты для контроля качества, сравнивать структуру страниц или передавать выбранные ссылки в отдельный поток открытия.
Это сохраняет ясность владения. ScraperFly помогает с захватом, рендерингом, маршрутизацией, форматами ответов, файлами и доказательствами запроса. Ваше приложение отвечает за стратегию обхода, оценку, дедупликацию, правила обогащения, оповещения и бизнес-решения. Это разделение упрощает отладку системы, потому что каждый этап имеет четкую задачу.



