






ScraperFlyAPI de dados web pronta para IA

developer api

API de Análise de Links de Página da Web para evidências de páginas públicas

ScraperFly ajuda equipes a capturar a fonte de páginas públicas, estados renderizados, metadados da URL final e provas visuais para que o código a jusante possa inspecionar links, navegação, canônicos, referências, paginação e contexto da página com melhores evidências.

Evidência de link primeiro

Capture o estado da página pública antes que seu parser de links decida o que seguir

A análise de links parece simples até que a página de destino mude a evidência. A navegação pode ser renderizada no servidor ou construída no navegador, URLs canônicas podem diferir da URL solicitada, a paginação pode estar oculta atrás do JavaScript, e páginas públicas podem misturar links internos, referências externas, links de mídia, hreflang, dicas de robôs e redirecionamentos em uma única resposta.

ScraperFly oferece às equipes uma camada de captura confiável para essa evidência de página. Busque páginas públicas como HTML bruto ou renderizado, mantenha os metadados da resposta, preserve a prova visual quando a QA precisar, e deixe seu próprio parser decidir quais links extrair, normalizar, rastrear, pontuar ou ignorar.
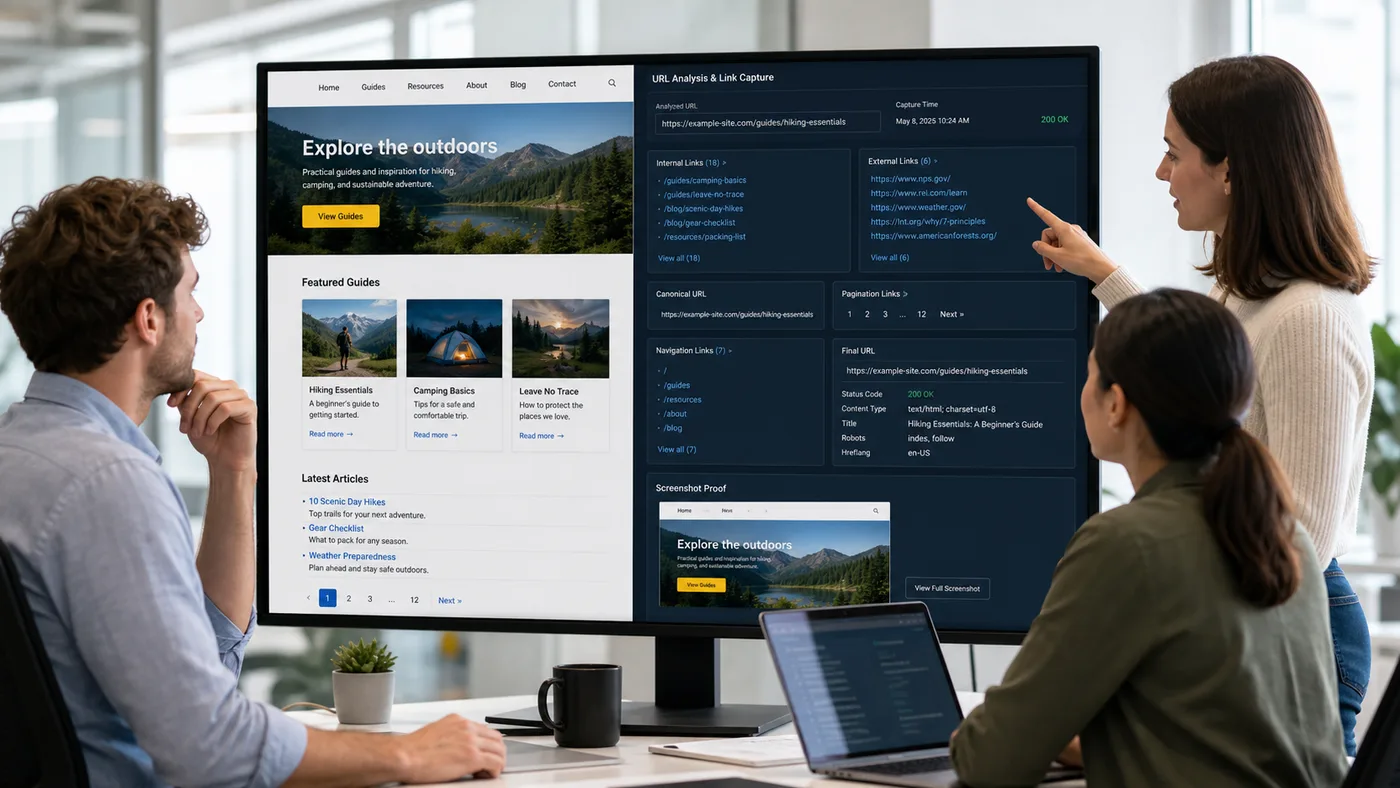
links internos canônicos paginações URL final
Equipe revisando evidência de link de página pública e saídas do parser

O que é uma API de parser de links de página da web?

Uma API de parser de links de página da web é um fluxo de trabalho que captura uma página pública e retorna evidências de origem suficientes para que o código a jusante inspecione os links. Isso pode incluir HTML bruto, HTML renderizado, metadados da URL final, status, tipo de conteúdo, tamanho da resposta, capturas de tela, PDFs e outros contextos que ajudam um parser a decidir o que está presente na página.

O parser em si permanece como a lógica do seu produto. ScraperFly não substitui o agendamento de rastreamento, pontuação de links, auditoria de SEO, normalização de URLs, deduplicação, decisões de sitemap ou regras de negócios. Ele fornece ao parser uma camada de entrada mais limpa para que essas decisões sejam baseadas no que a página pública realmente retornou.

Essa intenção é mais restrita do que uma API de parser de conteúdo da web geral. O foco é a evidência de links: âncoras, navegação, canônicos, paginação, hreflang, referências externas e comportamento da URL final que pode afetar descoberta, QA, monitoramento ou ferramentas internas.

Resumo prático: use ScraperFly para capturar a página e o contexto da resposta, e mantenha as decisões de extração e rastreamento em seu próprio parser de links.

Quais links e sinais de URL as equipes devem inspecionar?

Um parser de links útil não deve tratar cada href como igualmente significativo. Links de navegação, paginação, URLs canônicas, alternados hreflang, links de conteúdo interno, referências externas, links de mídia, links criados por scripts e URLs finais redirecionados carregam sinais diferentes. Capturá-los do estado correto da página é importante.

Antes de escalar, defina quais classes de links seu fluxo de trabalho precisa. Uma ferramenta de QA de SEO pode se preocupar com canônicos, hreflang, redirecionamentos e navegação rastreável. Um pipeline de descoberta de conteúdo pode se preocupar com links de artigos e paginação. Um fluxo de monitoramento pode se preocupar se um link público importante desapareceu de uma página renderizada.

SinalPor que é importanteMelhor evidência de capturaDecisão a jusante
Links internosRevelar navegação, caminhos de descoberta, conteúdo relacionado e estrutura do siteHTML ou HTML renderizadoExtrair, normalizar, deduplicar ou colocar na fila
Links externosMostrar referências, citações, parceiros, embeds e dependências externasHTML mais metadados da URL finalClassificar, verificar ou monitorar
URL canônicaPode diferir da URL solicitada e afetar o tratamento de duplicatasCabeçalho HTML e metadados da respostaNormalizar registros e evitar páginas duplicadas
Links de paginaçãoControlar se um fluxo de trabalho pode descobrir as próximas páginas de resultadosHTML, HTML renderizado, prova de captura de telaConstruir o escopo de rastreamento com cuidado
Links hreflang e regionaisExpor alternados de idioma ou regionaisCabeçalho HTML, URL final, amostras cientes do paísMapear cobertura de localidade ou variantes regionais
Redirecionamento e URL finalMostra o destino real após o comportamento do alvo ser aplicadoMetadados JSON e evidência de statusDepurar roteamento, canonização e qualidade de link

Os fluxos de trabalho de link mais fortes armazenam tanto a lista de links quanto o contexto de captura. Quando um parser produz um resultado inesperado, status, URL final, tipo de conteúdo, tamanho da resposta, HTML de origem e estado renderizado ajudam a explicar se o problema está na página, no perfil de solicitação ou na regra de extração.

Quando a análise de links deve usar HTML renderizado?

Muitas páginas públicas ainda expõem links úteis em HTML de origem. Nesses casos, HTML bruto é o formato de captura mais rápido e prático. Mas alguns sites constroem navegação, grades de produtos, rolagem infinita, links relacionados ou paginação após a execução do JavaScript do lado do navegador. Um parser que vê apenas HTML de origem pode perder esses links ou confundir espaços reservados com evidência real da página.

Use renderização JavaScript quando o conjunto de links úteis aparecer apenas no estado da página construída no navegador. Compare as respostas brutas e renderizadas antes de se comprometer com um perfil de solicitação mais pesado. Se a renderização não mudar os links que seu parser precisa, mantenha a solicitação leve.

A saída visual também pode ajudar. Capturas de tela ou PDFs não são a melhor fonte para extração automática, mas são úteis quando a QA precisa provar que uma área de navegação, controle de paginação, módulo de link ou estado da página apareceu no momento da captura.

Resumo prático: renderize apenas quando a execução do navegador mudar a evidência de link da qual seu parser depende.

Como o ScraperFly suporta QA de SEO e planejamento de rastreamento?

ScraperFly pode suportar QA de SEO capturando as páginas de origem públicas que as ferramentas a jusante inspecionam. A API pode fornecer HTML para extração de links, metadados para verificações de status e URL final, saída renderizada para navegação construída em JavaScript e capturas de tela para revisão. Seu próprio fluxo de trabalho ainda possui regras de rastreamento, pontuação, relatórios, priorização de problemas e lógica de remediação.

Essa fronteira mantém a página honesta e útil. Um parser de links pode usar ScraperFly para coletar amostras confiáveis, e então classificar links por tipo, profundidade, destino, modelo, idioma ou seção de origem. Um fluxo de monitoramento pode comparar se links importantes permanecem presentes. Uma ferramenta de QA pode preservar a prova de captura de tela quando uma página pública muda.

Use o API Builder para testar uma URL representativa, comparar HTML bruto e renderizado, inspecionar metadados e decidir se o parser de links precisa de HTML simples, renderização, cabeçalhos, sessões, roteamento por país ou arquivos visuais antes de escalar o alvo.

Como a análise de links pode permanecer previsível e acessível?

A extração de links pode se tornar cara quando cada página é tratada como uma aplicação renderizada complexa. A maioria das equipes deve começar com captura de HTML simples, provar quais links estão presentes, e então adicionar controles mais pesados apenas quando a evidência da resposta mostrar que eles melhoram o conjunto de links ou o valor de depuração.

DecisãoBom padrãoEscalar quando
Formato de capturaHTML bruto para extração de âncorasHTML renderizado muda navegação, paginação ou módulos de link
MetadadosMantenha status, URL final, tipo de conteúdo e tamanhoDepurar redirecionamentos, canônicos ou amostras inconsistentes
Prova visualIgnorar para extração de links apenas para máquinaQA precisa de evidência de que uma área de link apareceu visualmente
Controles de roteamentoUse o caminho padrão primeiroLocalização, idioma, acesso ou redirecionamentos mudam links de página pública
Modelo de custoUse créditos gratuitos e pague conforme o uso enquanto testaMova o monitoramento de links recorrentes para créditos mensais quando o volume for conhecido

O modelo de cobrança flexível do ScraperFly é útil aqui porque a análise de links muitas vezes começa como um projeto exploratório. Teste alguns modelos, mantenha páginas simples leves, adicione renderização ou prova visual apenas onde importa, e use a página de Preços para estimar o peso da solicitação antes que o monitoramento recorrente comece.


Resumo prático: a análise de links escala melhor quando cada controle de solicitação está vinculado a um sinal de link que o parser realmente precisa.

Fluxo de trabalho do parser de links

Construa a solicitação de captura antes de confiar na lista de links

Use o API Builder para testar páginas públicas representativas, comparar HTML bruto e renderizado, inspecionar metadados da URL final e escolher a forma de resposta que seu parser de links, ferramenta de QA de SEO ou fluxo de monitoramento pode usar imediatamente.

01
01

Capture âncoras e estrutura da página

Use HTML quando seu parser precisar de hrefs, navegação, canônicos, paginação, hreflang ou contexto DOM.

02
02

Renderize links construídos pelo navegador

Ative a renderização quando links públicos, cartões ou navegação aparecerem apenas após a execução do JavaScript do frontend.

03
03

Depure o comportamento da URL final

Use metadados da resposta para comparar URL solicitada, URL final, status, tipo de conteúdo, redirecionamentos e tamanho da resposta.

Controles de solicitação úteis para parser de links

url

A página alvo a ser buscada, renderizada, limpa ou capturada.

format

Selecione a resposta que seu produto precisa: html, texto, markdown, json, captura de tela ou pdf.

premium

Escalonar para roteamento mais forte para bloqueios, alvos instáveis ou conteúdo sensível à localização.

render

Execute o Chromium para SPAs, marcação injetada em JS, capturas de tela, PDFs e páginas apenas para navegador.

country

Solicite uma rota específica do país quando o conteúdo mudar por localização.

keep_headers

Encaminhe o contexto da solicitação selecionada, como user-agent, cookie, idioma e referer.

render_wait

Dê ao conteúdo dinâmico uma espera extra controlada antes da extração ou captura.

download

Retorne artefatos visuais como arquivos para download quando a saída for captura de tela ou PDF.

exemplo de cURL

Gere Markdown com a mesma forma de solicitação que você pode mover para produção

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Planejamento de destino de links

Mapeie o modelo da página antes de escalar a extração de links

Uma página inicial, página de categoria, página de busca, artigo, página de documentação e índice paginado podem expor sinais de link muito diferentes. Inspecione se os links estão presentes no HTML de origem, se a renderização muda o conjunto, se canônicos ou hreflang importam e se a prova visual é necessária para QA.

Resposta HTML bruta mapeada para dados visíveis da página
01

Disponibilidade de HTML bruto

Verifique se os campos que você precisa já estão presentes na primeira resposta HTML.

Melhor primeiro teste para páginas simples, artigos, documentos, listagens e detalhes de produtos.

Comparação antes e depois da renderização do JavaScript
02

Dependência de JavaScript

Compare HTML bruto com o DOM renderizado ou captura de tela antes de ativar a renderização do navegador.

Use renderização quando o HTML bruto é apenas uma casca e scripts criam o conteúdo útil.

Cookies, consentimento, sessão e contexto de acesso para scraping
03

Estado e contexto de acesso

Identifique se cookies, consentimento, limites de login, paginação ou o mesmo estado do visitante afetam a resposta.

Use sessões e cabeçalhos quando a continuidade muda os dados que você recebe.

Variações de conteúdo regional entre países e rotas
04

Variação geo/conteúdo

Teste se país, idioma, moeda, inventário, SERP, anúncios ou reputação da rota mudam o resultado.

Use roteamento geo ou premium apenas quando o alvo provar que a resposta varia por rota.

Perguntas antes de extrair links em escala

Onde está o campo alvo?

Verifique se o campo existe no HTML bruto, DOM renderizado, uma chamada de API, dados estruturados, um arquivo ou um estado de interação posterior.

O que muda na resposta?

Amostre algumas URLs e compare status, URL final, comprimento do conteúdo, redirecionamentos, estados vazios e diferenças nos resultados visíveis.

Qual contexto é necessário?

Marque qualquer dependência de consentimento, localidade, cookies, cabeçalhos, limite de autenticação, paginação, filtros ou solicitações anteriores.

Como é a falha?

Defina os sinais para respostas bloqueadas, parciais, obsoletas, redirecionadas, vazias, com tempo esgotado ou com região incompatível antes de escalar.

Configuração do parser de links

Modo de busca

A disponibilidade de HTML bruto decide se a primeira solicitação pode permanecer simples ou precisa de renderização, esperas, capturas de tela ou extração.

Contexto da solicitação

Os requisitos de estado decidem se é necessário adicionar cabeçalhos, cookies, sessões, manuseio de consentimento ou um perfil de visitante estável.

Escolha de roteamento

Descobertas geográficas e de reputação decidem se o roteamento padrão é suficiente ou se uma rota de país/premium é justificada.

Regras de validação

Estados de falha conhecidos se tornam verificações para novas tentativas, escalonamento, revisão de QA e decisão de quando um perfil mais leve ainda está completo.

Melhor evidência de link.

Escolha ScraperFly quando a extração de links precisar de evidência de origem, não de suposições de rastreadores.

ScraperFly ajuda equipes a testar a página pública real primeiro, escolher HTML bruto ou renderizado deliberadamente, preservar metadados para depuração e manter o custo de solicitação vinculado aos controles que realmente melhoram a evidência do link.

Equipe feliz validando um projeto em um laptop
01 / Comece fácil

Início fácil e gratuito antes de qualquer pressão de cobrança

ScraperFly lhe dá espaço para testar o alvo real primeiro. Use créditos gratuitos para verificar se a página funciona, se os dados estão presentes e quais controles são realmente necessários antes de comprometer dinheiro a um plano. Isso faz com que o primeiro experimento pareça leve: sem ciclo de aquisição, sem assinatura forçada, sem adivinhar seu volume mensal no primeiro dia.

Créditos gratuitosSem cartão para os primeiros testesValide antes de escalar
Profissional sorridente trabalhando com sucesso em um laptop
02 / Gaste de forma inteligente

Cobrança acessível e flexível para volume de scraping do mundo real

Nem toda carga de trabalho de scraping é uma curva mensal organizada. Alguns projetos têm picos, outros pausam e alguns só se tornam recorrentes depois que os dados provam valor. ScraperFly apoia essa realidade com um caminho de pagamento conforme o uso, além de planos de crédito mensais quando o volume constante faz sentido. Você pode comprar o que precisa, manter os custos visíveis e evitar transformar um pequeno teste em uma assinatura exagerada.

Pague conforme o usoMensal quando útilControle de custos
Desenvolvedor preparando saída estruturada de um laptop
03 / Envie mais rápido

Pré-processamento de resposta que remove trabalho de limpeza

Uma busca barata não é suficiente se sua equipe ainda precisa construir conversores, limpadores, capturas de tela, captura de PDF e formatação pronta para LLM ao redor disso. ScraperFly pode retornar a resposta como HTML, texto limpo, Markdown, JSON estruturado, PDF ou saída de imagem, para que seu pipeline chegue mais perto do ativo final em uma solicitação. Menos código de cola, menos partes móveis, entrega mais rápida.

HTMLTextoMarkdownJSONPDFImagem

Onde ScraperFly ajuda equipes de análise de links.

Compare as escolhas de solicitação em torno de HTML bruto, navegação renderizada, evidência da URL final, QA visual e controle de custo antes de escalar a monitorização recorrente de links.

Ponto de decisãoVantagem do ScraperFlyCompromisso típico do concorrente
Primeiro experimentoComece com créditos gratuitos e valide o alvo real antes de gastar. Você pode provar se HTML bruto, renderização, roteamento premium ou segmentação por país são realmente necessários.As avaliações muitas vezes o empurram rapidamente para um plano recorrente ou escondem o verdadeiro custo até que complementos entrem na solicitação.
Modelo de cobrançaUse créditos pay-as-you-go para trabalhos irregulares e, em seguida, mude para créditos mensais apenas quando a carga de trabalho se tornar previsível. Isso mantém testes pequenos e scraping baseado em projetos acessíveis.Muitas ferramentas são otimizadas em torno de assinaturas mensais, alocações fixas ou portões de nível que podem parecer pesados antes que o volume seja comprovado.
Peso da solicitaçãoMantenha páginas simples simples. Ative a renderização JavaScript, roteamento premium, sessões, cabeçalhos, esperas ou roteamento por país apenas quando as evidências da resposta indicarem que eles são importantes.Controles comparáveis podem existir, mas muitas vezes estão agrupados em níveis mais altos, padrões ou perfis de preços mais complexos.
Formatos de saídaRetorne a resposta na forma que seu produto precisa: HTML para parsers, texto ou Markdown para pipelines de conteúdo, JSON para metadados estruturados e saída em PDF/imagem para prova visual.Alguns provedores se concentram principalmente no acesso e deixam a formatação, captura, limpeza e preparação downstream para seu próprio código.
Fluxo de trabalho do desenvolvedorUma superfície de API pode cobrir teste de alvo, escalonamento, renderização, roteamento, sessões, cabeçalhos, formatação de resposta e verificações de status. O caminho do protótipo à produção permanece compacto.Ferramentas com foco em proxy, marketplaces de atores e plataformas de crawler podem ser poderosas, mas muitas vezes exigem mais código de integração ou um modelo operacional mais pesado.
Melhor ajusteEquipes que desejam entrega prática de dados da web: comece pequeno, meça o custo por resultado útil e escale apenas os controles que melhoram o resultado.Equipes com contratos fixos de alto volume, infraestrutura de proxy personalizada ou necessidades amplas de rastreamento de mercado podem preferir uma plataforma mais especializada.

Controle de custos

Mantenha a análise de links acessível mantendo páginas simples simples.

Muitos fluxos de trabalho de análise de links podem começar com HTML bruto e metadados. ScraperFly permite que as equipes testem páginas públicas com créditos gratuitos, usem pagamento conforme o uso enquanto o comportamento da fonte é irregular e adicionem renderização, arquivos visuais ou roteamento mais forte apenas quando esses controles melhoram a evidência do link capturado.

Um pedido HTML leve retornando uma resposta simples
01

Fetch básico

Use um fetch básico quando o HTML público já contém os campos que você precisa.

Perfil de pedido mais leve; mantenha-o quando a resposta estiver completa.

Renderização JavaScript produzindo um DOM completo
02

Renderização

Use renderização quando o HTML bruto é uma casca e o JavaScript completa a página.

Perfil mais pesado; use-o apenas quando a saída do navegador alterar o resultado.

Várias solicitações preservando cookies e estado do visitante
03

Sessão com estado

Use sessões quando cookies, consentimento, local ou paginação alterarem a resposta.

Perfil de estado mais pesado; preserve-o apenas quando a continuidade for importante.

Roteamento de solicitações através de rotas geográficas e de maior qualidade
04

Roteamento e geo premium

Use roteamento premium ou geográfico apenas quando a origem, país, reputação ou conteúdo regional alterarem o resultado.

Perfil de roteamento mais pesado; aplique-o apenas a alvos que provem que precisam.

Fatores de custo da análise de links.

Mais trabalho de infraestrutura

Renderização de navegador, escolhas de roteamento e esperas mais longas significam que a plataforma precisa fazer mais do que retornar uma simples resposta.

Mais incerteza no alvo

Redirecionamentos, estados vazios, limites de taxa e páginas de desafio frequentemente requerem opções de entrega mais robustas ou tentativas novamente.

Mais estado a preservar

Cookies, sessões, consentimento e fluxos de múltiplas páginas adicionam partes móveis que um fetch sem estado simples não possui.

Mais evidências a retornar

Capturas de tela, PDFs, saída renderizada e artefatos de resposta mais ricos são úteis, mas são mais pesados do que HTML simples.

Controles que devem conquistar seu lugar

Amostre antes de escalar

Teste um pequeno conjunto de URLs primeiro e agrupe alvos pelo perfil mais leve que retorna dados completos.

Não renderize por padrão

Inspecione o HTML bruto antes de ativar a renderização. Muitas páginas públicas já contêm os dados que você precisa.

Escalone com base em evidências

Suba apenas quando a resposta mostrar conteúdo ausente, dependência de estado, variação geográfica ou problemas de roteamento.

Meça resultados úteis

Otimize em torno de registros válidos entregues, não no volume bruto de solicitações. Um perfil mais leve é melhor apenas quando permanece completo.

FAQ do parser de link

Perguntas comuns sobre a análise de links de páginas da web com ScraperFly.

Respostas práticas para equipes que capturam evidências de páginas públicas para extração de links a jusante, QA de SEO, descoberta, monitoramento e planejamento de rastreamento.

Respostas rápidas

Captura versus rastreamento

Onde ScraperFly se encaixa no fluxo de trabalho de links.

O ScraperFly extrai automaticamente todos os links?

ScraperFly captura a página pública e o contexto da resposta. Seu parser possui regras de extração, normalização, deduplicação, filas de rastreamento e pontuação.

Ele pode substituir um rastreador de SEO?

Não. O ScraperFly pode fornecer evidências de origem para verificações de SEO a montante, enquanto o agendamento de rastreamento, pontuação, relatórios e priorização permanecem em seu sistema.

Links e contexto de URL

Saiba quais sinais de URL são importantes.

Quais links devo inspecionar?

Sinais comuns incluem links internos, referências externas, navegação, paginação, URL canônica, alternados hreflang, links de mídia e comportamento da URL final.

Por que manter metadados da URL final?

A URL final, status, tipo de conteúdo e tamanho da resposta ajudam a depurar redirecionamentos, canonização, comportamento de acesso e amostras inconsistentes.

Links JavaScript

Use a execução do navegador quando os links forem construídos pelo navegador.

Quando devo renderizar antes de analisar links?

Renderize quando links públicos, navegação, paginação, cartões ou módulos relacionados aparecerem apenas após a execução do JavaScript do frontend.

Cada solicitação de parser de link deve renderizar?

Não. Comece com HTML bruto e renderize apenas quando a evidência do link mudar no estado da página construída pelo navegador.

Depuração e prova

Mantenha a evidência útil para humanos e máquinas.

Capturas de tela são úteis para parsing de links?

Eles são úteis para QA e prova de navegação ou paginação visível, mas o HTML continua sendo a melhor fonte para extração por máquinas.

Como posso manter os custos previsíveis?

Use HTML bruto e metadados primeiro, depois adicione renderização, arquivos visuais ou roteamento mais forte apenas quando o alvo provar que eles melhoram a evidência do link.








