






Seitenkontext zuerst
Metadaten inspizieren, bevor eine URL in Ihre Pipeline gelangt
ScraperFly hilft Teams, den praktischen Kontext einer öffentlichen Seite zu erfassen, bevor diese URL Teil von Suche, Überwachung, KI-Eingabe, QA, Anreicherung oder Berichterstattung wird. Anstatt jede Seite als Crawling-Job zu behandeln, beginnen Sie mit einer echten Antwort und inspizieren Sie, was das Ziel tatsächlich zurückgibt.
Die Antwort kann die endgültige URL, den Status, den Inhaltstyp, die Antwortgröße, Metadaten, Überschriften, Links, lesbaren Text, Markdown und visuelle Beweise enthalten, wenn nötig. Das gibt Entwicklern genügend Beweise, um zu entscheiden, ob die Seite bereit für die nachgelagerte Verarbeitung ist oder ob Rendering, Header, Sitzungen, Länderauswahl oder eine stärkere Zustellung das Ergebnis verbessern werden.
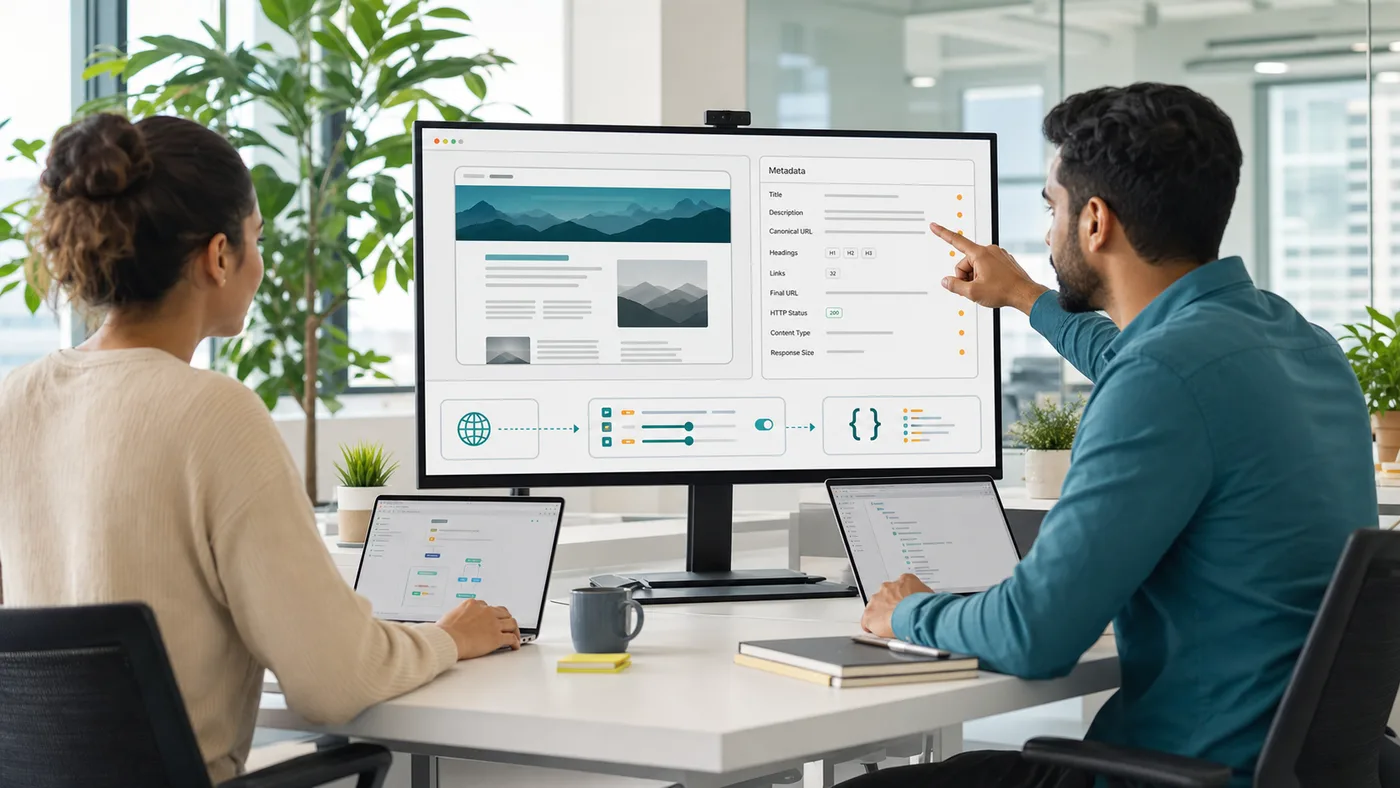
Was ist eine Webseiten-Metadaten-API?
Eine Webseiten-Metadaten-API ruft eine öffentliche URL ab und gibt den Seitenkontext zurück, der einer Anwendung hilft zu verstehen, was zurückgekommen ist. Dieser Kontext kann den Seitentitel, die Meta-Beschreibung, die kanonische URL, Robots-Direktiven, Open Graph-Tags, Twitter-Karten-Tags, Überschriften, Links, die endgültige URL, den HTTP-Status, den Inhaltstyp, die Antwortgröße, sauberen Text, Markdown, Screenshots oder PDFs je nach Anforderungsprofil umfassen.
Dies unterscheidet sich von einem vollständigen Crawler oder einer fertigen SEO-Audit-Suite. Die Metadaten-API liefert Ihrem System zuverlässige Beweise von der angeforderten Seite. Ihr Produkt kann dann entscheiden, was gespeichert, indiziert, verglichen, klassifiziert, zusammengefasst, angereichert oder an einen anderen Workflow gesendet werden soll. Diese Grenze ist wichtig, da sie die Seite nützlich hält, ohne Analysen des Linkgraphen, Überwachung von defekten Links, Ranking-Tracking oder zielgerichtete Feldextraktion zu versprechen, die in einer separaten Schicht gehört.
Praktische Erkenntnis: Verwenden Sie die Erfassung von Webseiten-Metadaten, wenn Ihr Produkt vertrauenswürdigen Seitenkontext benötigt, bevor es eine Speicher-, Parsing-, Überwachungs- oder KI-Entscheidung trifft.
Welche Metadaten sollten Teams von einer öffentlichen Seite erfassen?
Die richtigen Metadaten hängen vom Workflow ab. Ein Suchindex könnte sich für Titel, Beschreibung, Überschriften, kanonische URL und lesbaren Textkontext interessieren. Ein QA-Workflow könnte die endgültige URL, den Status, die Antwortgröße, Screenshots und PDF-Beweise benötigen. Eine KI-Pipeline könnte sauberen Text oder Markdown mit genügend Quellmetadaten benötigen, um zu erklären, woher die Antwort stammt. Ein Inhaltsinventar könnte Links, Überschriften, Sprache, Veröffentlichungszeichen und Seitenbeziehungen benötigen.
ScraperFly ist am stärksten, wenn Teams Metadaten als Entscheidungsschicht verwenden. Erfassen Sie die Seitenantwort, inspizieren Sie die relevanten Felder und halten Sie die Anfrage leicht, es sei denn, das Ziel beweist, dass es mehr Hilfe benötigt. Wenn das Quell-HTML bereits den Seitentitel, Überschriften, Metadaten und nützliche Links enthält, ist eine einfache Anfrage normalerweise ausreichend. Wenn das Frontend-JavaScript den nützlichen Kontext ändert, kann das Rendering für diesen Seitentyp hinzugefügt werden.
| Metadatenbereich | Beispiele | Am besten geeignet für | Anforderungsentscheidung |
|---|---|---|---|
| Antwortkontext | Endgültige URL, Status, Inhaltstyp, Antwortgröße | Protokollierung, QA, Debugging, Speicherentscheidungen | Erfassen Sie bei jeder repräsentativen Probe. |
| HTML-Head-Metadaten | Titel, Meta-Beschreibung, Robots, kanonisch | Suchindizierung, Inhaltsinventar, Seiten-QA | Beginnen Sie mit dem Quell-HTML und vergleichen Sie dann das Rendering, wenn Felder fehlen. |
| Soziale Vorschau-Metadaten | Open Graph- und Twitter-Kartenfelder | Vorschau-QA, Inhaltsüberprüfung, Anreicherung | Validieren Sie repräsentative Vorlagen, bevor Sie skalieren. |
| Seitenstruktur | H1-H3-Überschriften, Abschnitte, lesbarer Text, Markdown | KI-Eingabe, Inhaltsqualitätsprüfungen, Zusammenfassungen | Wählen Sie Markdown oder Text, wenn DOM-Details nicht benötigt werden. |
| Seitenlinks | Kanonisch, interne Links, externe Links, hreflang | Einzelseitenkontext, Entdeckungshinweise, Lokalisierungsprüfungen | Verwenden Sie als Seitenbeweis, nicht als vollständigen Crawl-Graph für sich allein. |
| Visuelle Beweise | Screenshot oder PDF-Erfassung | Archiv, Überprüfung, Compliance, menschliche QA | Fügen Sie nur hinzu, wenn ein visueller Nachweis das Workflow-Ergebnis ändert. |
Wann benötigt die Metadatenerfassung Rendering?
Die Metadatenerfassung benötigt Rendering, wenn die Quellantwort nicht den Seitenkontext enthält, den Ihr Workflow benötigt. Einige öffentliche Seiten senden sofort einen vollständigen HTML-Head und bedeutungsvolle Überschriften. Andere senden eine dünne Anwendungsschale und lassen JavaScript auf der Browserseite Titel-Tags, Routeninhalte, dynamische Überschriften, Links, Produktmodule oder lesbare Textabschnitte nach dem Laden der Seite aktualisieren.
Der praktische Schritt ist der Vergleich, nicht die Annahme. Holen Sie sich zuerst das Quell-HTML. Wenn Metadaten, Überschriften und nützliche Links vorhanden sind, halten Sie die Anfrage leicht. Wenn die Seite leer, generisch oder unvollständig aussieht, vergleichen Sie eine gerenderte Antwort. Fügen Sie Wartezeiten nur hinzu, wenn spät ladende Inhalte die Ausgabe ändern. Verwenden Sie Sitzungen, Header, Länderauswahl oder stärkere Routen nur, wenn diese Steuerungen die Antwortbeweise ändern.
Für Seiten, bei denen JavaScript der entscheidende Faktor ist, kombinieren Sie diesen Workflow mit der JavaScript-Rendering-API. Für Seiten, bei denen die Linkextraktion die Hauptaufgabe ist, verwenden Sie den engeren Webseiten-Link-Parser-API-Leitfaden. Die Metadatenerfassung liegt zwischen diesen Bedürfnissen: Sie gibt genügend Seitenkontext, um den nächsten Schritt intelligent zu wählen.
Wie unterscheidet sich das von der Inhaltsanalyse?
Die Inhaltsanalyse konzentriert sich auf den Stoff, den nachgelagerte Benutzer oder Systeme konsumieren werden: sauberen Text, Markdown, Hauptinhalt, Artikeltext, Zusammenfassungen oder strukturierte Ausgaben. Die Metadatenerfassung konzentriert sich auf die umgebenden Beweise, die einem System sagen, was die Seite ist, was während der Lieferung passiert ist, wie sich die Seite identifiziert und ob die Antwort vertrauenswürdig genug ist, um weiterverarbeitet zu werden.
Beide sind nützlich, aber sie beantworten unterschiedliche Fragen. Ein Inhaltsparser fragt: "Was sollten wir von dieser Seite lesen oder extrahieren?" Ein Metadaten-Workflow fragt: "Was hat diese URL zurückgegeben, wie sollten wir es interpretieren und ist es wert, an die nächste Stufe gesendet zu werden?" ScraperFly kann beide Antwortformen unterstützen, sodass Teams mit dem Seitenkontext beginnen und dann in Text, Markdown, JSON-Metadaten, Screenshots, PDFs oder zielgerichtete Parsing übergehen können, wenn der Workflow dies erfordert.
| Bedarf | Verwenden Sie Metadaten, wenn | Verwenden Sie Inhaltsanalyse, wenn |
|---|---|---|
| Suchindexvorbereitung | Sie benötigen Titel, kanonisch, Überschriften, Status und Quellkontext. | Sie benötigen einen sauberen Text oder ein Markdown-Dokument zur Indizierung. |
| KI-Eingabe | Sie benötigen Herkunft, endgültige URL, Inhaltstyp und Seitenübersicht. | Sie benötigen lesbaren Inhalt für Einbettungen, Zusammenfassungen oder Antworten. |
| Überwachung | Sie benötigen Status, Antwortgröße, Weiterleitungsverhalten und sichtbare Beweise. | Sie müssen spezifische Seitenfelder über die Zeit vergleichen. |
| Entdeckung | Sie benötigen Links und Seitenbeziehungen aus einer Antwort. | Sie benötigen extrahierte Entitäten von der Seite selbst. |
| Menschliche Überprüfung | Sie benötigen genügend Kontext, um zu entscheiden, ob die Antwort gültig ist. | Sie benötigen einen bereinigten Artikel, Produktdatensatz oder Seitenzusammenfassung. |
Wie können Teams Metadaten-Workflows praktisch halten?
Beginnen Sie mit repräsentativen URLs und definieren Sie die relevanten Felder, bevor Sie skalieren. Ein Metadaten-Workflow wird unübersichtlich, wenn jedes mögliche Feld ohne nachgelagerten Grund erfasst wird. Er wird fragil, wenn Teams annehmen, dass das Quell-HTML, das gerenderte DOM, Screenshots und Markdown austauschbar sind. Jedes Ausgabeformat hat eine Aufgabe: Antwortmetadaten erklären die Lieferung, HTML bewahrt die Struktur, Markdown hilft beim Lesen und KI-Eingang, JSON hält den operationellen Kontext überprüfbar, und visuelle Dateien beweisen, wie die Seite aussah.
Der Kostenkontrollweg ist einfach. Halten Sie einfache Seiten im Quell-HTML. Aktivieren Sie das Rendering nur, wenn JavaScript die Metadaten oder lesbaren Inhalt ändert. Verwenden Sie Screenshots oder PDFs, wenn visuelle Beweise wichtig sind. Verwenden Sie Länderauswahl, Sitzungen, Header und Premium-Routing, wenn sie ein nachgewiesenes Antwortproblem lösen. Kopieren Sie dann das bewährte Anforderungsprofil aus dem API Builder in die Anwendung, anstatt die Anforderungslogik von Grund auf neu zu erstellen.
Praktische Erkenntnis: Die Erfassung von Metadaten ist am nützlichsten, wenn sie Ihrem Produkt hilft, eine bessere nächste Entscheidung zu treffen, nicht wenn sie Felder nur sammelt, weil sie existieren.
Wo passt ScraperFly in eine Metadaten-Pipeline?
ScraperFly sitzt auf der Anfrage- und Antwortschicht. Es ruft die öffentliche Seite ab, wendet die Kontrollen an, die Ihr Ziel benötigt, und gibt die Antwortform zurück, die Ihr Workflow verwenden kann. Eine Metadaten-Pipeline kann dann den Antwortkontext speichern, sauberen Text oder Markdown an KI-Systeme übergeben, Screenshots für QA aufzeichnen, die Seitenstruktur vergleichen oder ausgewählte Links an einen separaten Entdeckungs-Workflow übergeben.
Dies hält das Eigentum klar. ScraperFly hilft bei der Erfassung, dem Rendering, dem Routing, den Antwortformaten, Dateien und Anforderungsbeweisen. Ihre Anwendung besitzt Crawling-Strategie, Scoring, Duplikation, Anreicherungsregeln, Alarmierung und Geschäftsentscheidungen. Diese Trennung macht das System einfacher zu debuggen, da jede Phase eine klare Aufgabe hat.



