






Чистая передача контента
Преобразуйте захваченные страницы в Markdown, который ваша команда может действительно использовать
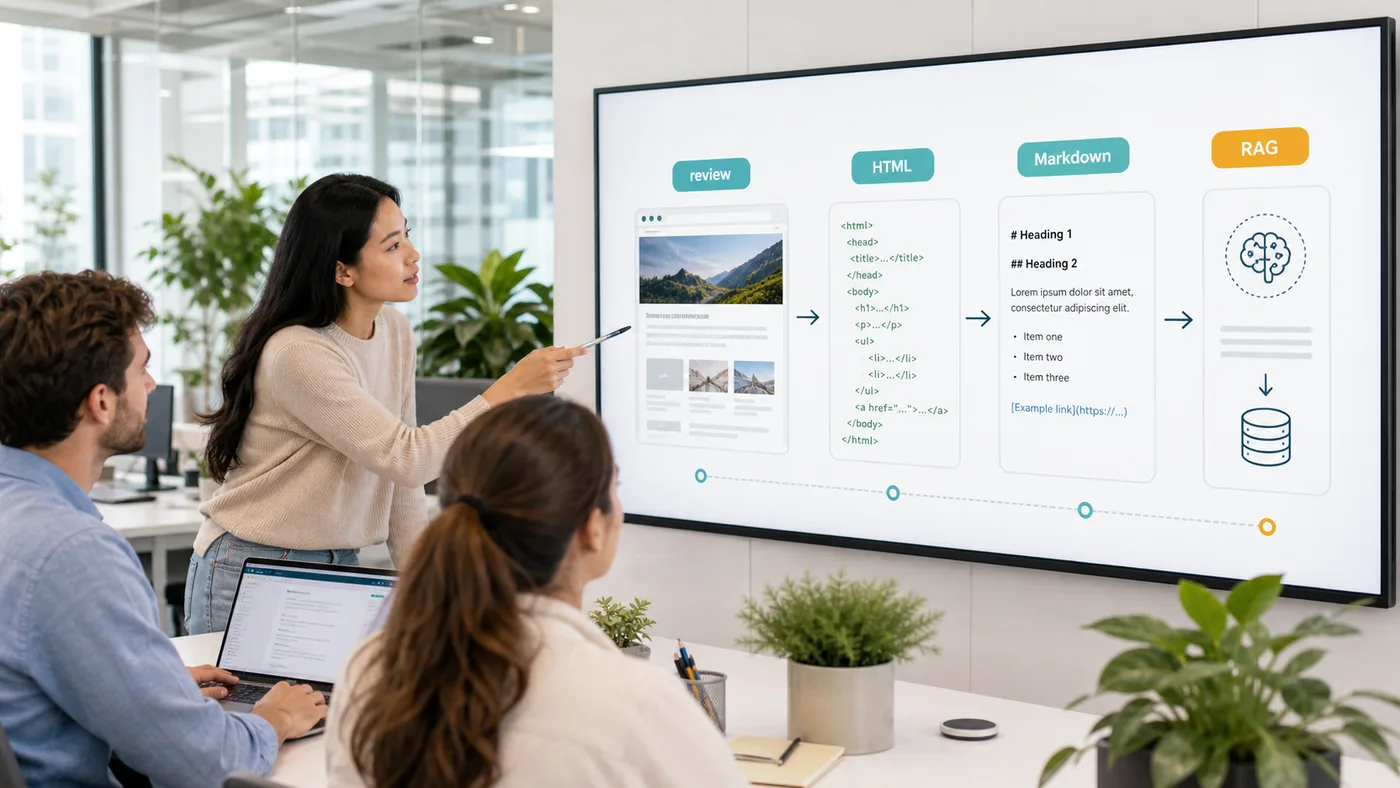
Сырой HTML мощен, но часто он слишком шумный для проверки контента, приема ИИ, документации, индексации поиска и RAG-пайплайнов. Навигация, повторяющиеся макеты, скрипты, атрибуты и шаблоны могут скрыть полезный контент страницы до того, как он достигнет людей или систем, которым он нужен.
ScraperFly помогает командам получать публичные страницы, рендерить их, когда требуется JavaScript, и возвращать Markdown в качестве более чистого рабочего формата. Результат легче читать, легче сравнивать и легче передавать в downstream-инструменты без необходимости создавать пользовательский конвертер для каждой цели.
Что такое API парсера HTML в Markdown?
API парсера HTML в Markdown получает публичную веб-страницу и возвращает читаемый Markdown вместо сырого разметки. Markdown может сохранить полезную структуру, такую как заголовки, абзацы, списки, ссылки и поток секций, при этом удаляя большую часть шумов макета, которые делают сырой HTML трудным для восприятия редакторами, агентами, поисковыми системами и контентными пайплайнами.
Этап захвата все еще важен. Если полезный контент страницы присутствует в исходном HTML, запрос может оставаться легким. Если сайт создает контент в браузере, рабочий процесс может потребовать отрендеренный HTML перед преобразованием в Markdown. ScraperFly сохраняет эти элементы управления в одном пути запроса, чтобы команды могли выбрать самый простой профиль, который возвращает полный контент.
Когда Markdown лучше, чем сырой HTML?
Markdown хорошо подходит, когда людям или рабочим процессам языковых моделей нужно читать страницу. Он легче для проверки, чем сырая разметка, менее загроможден, чем HTML браузера, и более структурирован, чем простой текст. Это делает его полезным для редакторской проверки, приема базы знаний, резюме ИИ, индексации поиска, легкого мониторинга и рабочих процессов документации.
Это не лучший формат для каждой задачи. Если парсеру нужны точные атрибуты, вложенные отношения DOM, целевая выборка или геометрия таблицы, сырой или отрендеренный HTML может быть безопаснее. Если рабочий процесс нуждается только в компактной читаемой прозе, чистый текст может быть достаточным. Главное — выбирать формат вывода в зависимости от потребителя, а не преобразовывать каждый захват в одну и ту же форму.
| Формат вывода | Лучше всего подходит для | Основное преимущество | Компромисс |
|---|---|---|---|
| Markdown | Прием ИИ, RAG, документация, редакторская проверка, читаемые архивы. | Сохраняет заголовки, списки, ссылки и читаемый поток секций. | Менее точно, чем HTML для парсинга, специфичного для DOM. |
| Сырой HTML | Селекторы, атрибуты, обнаружение ссылок, структурированный извлечение. | Сохраняет исходную разметку и отношения страниц. | Требует больше очистки перед проверкой человеком или ИИ. |
| Отрендеренный HTML | Страницы, где JavaScript создает полезный DOM. | Захватывает разметку, созданную браузером, перед преобразованием. | Тяжелее, чем захват исходного кода, и должен использоваться осознанно. |
| Текст | Компактный поиск, индексация и простой анализ контента. | Маленький и легкий для обработки. | Удаляет большую часть структуры, которую Markdown может сохранить. |
Как рендеринг влияет на качество Markdown?
Преобразование в Markdown может использовать только тот контент, который был захвачен. Если публичная страница отправляет полный контент статьи или продукта в начальном HTML-ответе, рендеринг может не улучшить Markdown. Если страница отправляет оболочку JavaScript и заполняет полезный контент после гидратации, преобразование в Markdown должно происходить после выполнения в браузере.
Лучший рабочий процесс сравнивает образцы перед масштабированием. Начните с захвата исходного кода, проверьте Markdown, затем протестируйте отрендеренный вывод, когда важные секции отсутствуют. Если важен контент, загружаемый поздно, может потребоваться установка ожидания. Если результат меняется в зависимости от сессии, заголовка или страны, эти элементы управления должны быть добавлены, потому что целевое поведение доказывает, что они важны, а не потому, что каждый запрос Markdown должен быть тяжелым по умолчанию.
Для страниц, созданных в браузере, API рендеринга JavaScript объясняет, когда рендеринг стоит включать. Для выбора между HTML, текстом, Markdown, JSON, скриншотами и PDF используйте руководство по форматам ответов.
Что должны проверить команды перед использованием Markdown в ИИ или RAG?
Markdown полезен для рабочих процессов ИИ, потому что он может сохранить читаемую структуру, не подвергая модель или пайплайн приема шумной разметке. Тем не менее, команды должны проверить вывод перед тем, как полагаться на него. Проверьте, сохранился ли основной контент после преобразования, имеют ли заголовки смысл, остаются ли ссылки полезными, уменьшена ли повторяющаяся навигация и не были ли важные таблицы или списки упрощены в запутанный текст.
Для RAG и поиска последовательность важна так же, как и читаемость. Храните достаточно доказательств ответа, чтобы объяснить каждый документ: целевой URL, конечный URL, статус, тип контента, размер ответа, настройки рендеринга и выбранный формат вывода. Этот контекст помогает командам отлаживать отсутствующие секции, устаревшие страницы, региональные варианты и случаи, когда одна и та же цель нуждается в HTML вместо Markdown.
| Проверка валидации | Почему это важно | Практическое действие |
|---|---|---|
| Основной контент | Рабочие процессы ИИ и проверки нуждаются в фактическом теле страницы, а не только в навигации. | Сравните Markdown с образцами исходной или отрендеренной страницы. |
| Структура заголовков | Полезные заголовки улучшают разбиение на части, резюме и человеческую проверку. | Проверьте, что H1, H2 и поток секций сохранились после преобразования. |
| Ссылки | Ссылки могут сохранить контекст цитирования, обнаружения и последующих действий. | Подтвердите, что важные якоря и URL остаются видимыми. |
| Таблицы и списки | Сложные структуры могут стать менее ясными при преобразовании. | Используйте рабочие процессы HTML или JSON, когда важна точная структура. |
| Метаданные доказательства | Команды должны знать, как была захвачена страница. | Храните статус, конечный URL, размер, настройки рендеринга и формат вместе с контентом. |
Где ScraperFly сокращает работу конвертера?
Без размещенного рабочего процесса команды часто получают HTML, управляют браузерными рабочими процессами, очищают шаблоны, пишут логику преобразования, обрабатывают неудачные цели, а затем создают отдельные проверки для приема ИИ или редакторской проверки. Это создает много вспомогательного кода вокруг того, что должно быть простым процессом передачи контента.
ScraperFly сокращает этот путь. Один и тот же запрос API может захватывать цель, рендерить страницы JavaScript, когда это необходимо, возвращать Markdown и сохранять альтернативные выходные данные для случаев, когда Markdown недостаточно. Разработчики могут протестировать цель в API Builder, сравнить формы ответов и перенести профиль запроса в производство, как только вывод будет подтвержден.
Как преобразование в Markdown остается экономически эффективным?
Сам по себе Markdown не является дорогой частью. Вес запроса увеличивается, когда рабочий процесс добавляет рендеринг браузера, более длительные ожидания, сессии, премиум маршрутизацию, скриншоты, PDF или повторные попытки. Экономически эффективный подход заключается в том, чтобы начать с самого легкого запроса, который может произвести полный Markdown, а затем добавлять элементы управления только тогда, когда цель доказывает, что они улучшают результат.
Это подходит как для небольших проектов, так и для производственных систем. Команды могут проверять цели с помощью бесплатных кредитов, использовать кредиты по мере необходимости для неравномерной работы по преобразованию и переносить повторяющиеся рабочие нагрузки на месячные кредиты, когда профиль запроса предсказуем. Страница цены объясняет, как этот путь покупки сохраняет тесты доступными, оставляя место для масштабирования.










