






ScraperFlyAPI веб-данных для AI

developer api

API для преобразования веб-страниц в Markdown для контента, готового к ИИ

ScraperFly преобразует публичные страницы в чистый Markdown, который сохраняет читаемую структуру для ИИ, RAG, документации, обзоров и рабочих процессов контента. Получите URL, рендерите только тогда, когда страница это требует, и возвращайте вывод, который ваша система может использовать без необходимости создания пользовательского слоя очистки.

ВЫВОД MARKDOWN

Преобразуйте публичные страницы в Markdown, который ваша система может действительно прочитать

ScraperFly предоставляет командам практический путь от публичного URL к чистому Markdown. Вместо того чтобы отправлять сырой разметку страницы в AI-промпт, инструмент документации, очередь проверки контента или поисковый индекс, ваше приложение может запросить ответ, который сохраняет полезные заголовки, абзацы, списки и ссылки в читаемом виде.

Важная часть — это контроль. Начните с легкого запроса, проверьте, что возвращает целевая страница, затем включите рендеринг браузера, ожидания, сессии, заголовки, таргетинг по странам или более сильную маршрутизацию только тогда, когда эти элементы улучшают Markdown, который получает ваш рабочий процесс.
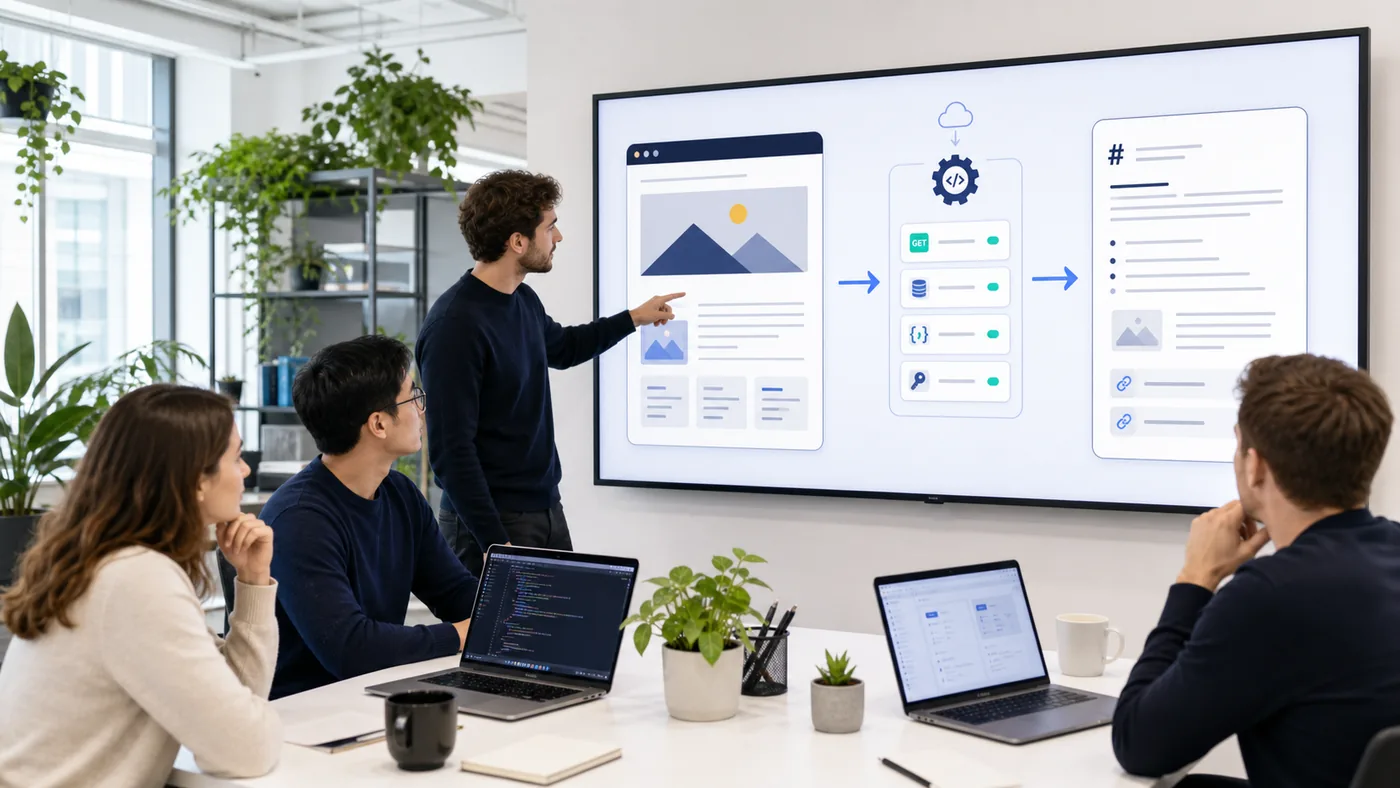
URL в Markdownзаголовки и ссылкиконтент, готовый для AI
Команда проверяет рабочий процесс, который преобразует публичную веб-страницу в чистый вывод Markdown

Что такое API для преобразования веб-страницы в Markdown?

API для преобразования веб-страницы в Markdown извлекает публичный URL и возвращает захваченное содержимое страницы в формате Markdown. Ответ предназначен для систем, которым нужен читаемый контент, а не инфраструктура браузера: поглощение RAG, AI-агенты, внутренний поиск, редакторская проверка, импорт документации, мониторинг заметок и легкий анализ контента.

Markdown полезен, потому что он находится между сырой HTML и простым текстом. Он может сохранять заголовки, поток абзацев, списки и ссылки, не заставляя каждого последующего потребителя понимать вложенность DOM, повторяющуюся навигацию, атрибуты, скрипты, стили или шум шаблона.

Это не то же самое, что обещать идеальное извлечение статей или извлечение пользовательских схем. Ответ в формате Markdown следует рассматривать как чистый формат контента. Если вашему продукту нужны точные поля продукта, авторские строки, даты, цены, рейтинги или структура на уровне селекторов, проверьте эти поля отдельно или оставьте HTML и метаданные доступными для парсера.

Практическое замечание: используйте преобразование страницы в Markdown, когда потребителю нужен читаемый контент страницы, а не точные доказательства DOM.

Когда командам следует использовать Markdown вместо HTML или текста?

Markdown наиболее эффективен, когда содержимое страницы будет прочитано, разбито на части, обобщено, проверено, индексировано или передано в рабочий процесс языковой модели. Он предоставляет принимающей системе больше структуры, чем простой текст, но меньше шума, чем сырая HTML.

HTML по-прежнему лучше подходит, когда важны селекторы, атрибуты, вложенные таблицы, точные ссылки или отношения DOM. Простой текст лучше, когда рабочий процесс требует только компактного читаемого текста. JSON-метаданные помогают с диагностикой запросов. Скриншоты и PDF помогают, когда визуальное состояние является доказательством.

Рабочий процессПочему Markdown помогаетКогда другой формат лучше
Поглощение RAG и AIСохраняет заголовки, списки, ссылки и читаемые разделы для более чистого разбиения.Используйте HTML, когда извлечение зависит от селекторов или скрытых атрибутов.
Редакторская проверкаУпрощает сканирование и аннотирование содержимого публичной страницы для людей.Используйте скриншот или PDF, когда важны макет и визуальное доказательство.
Импорт документацииПеремещает разделы страницы в формат, который инструменты документации могут обрабатывать естественным образом.Используйте текст, когда нужен только простой текст.
Индексирование поискаСохраняет полезную структуру, не добавляя HTML-шум в индекс.Используйте JSON-метаданные для отслеживания конечного URL, статуса, типа контента и контекста запроса.
Мониторинг заметокФиксирует читаемые изменения страницы, не сохраняя каждый раз полный рендеренный артефакт.Используйте скриншоты для визуальных регрессий, сломанных макетов или доказательств одобрения.

Практическое замечание: выбирайте Markdown, когда структура помогает читателю или модели, и сохраняйте HTML или визуальные форматы, когда доказательства должны быть точными.

Как рендеринг изменяет вывод Markdown?

Конвертер Markdown может работать только с содержимым, которое захватывает запрос. Многие публичные страницы отправляют полезное содержимое в первом HTML-ответе. Эти страницы должны оставаться простыми: извлеките URL, запросите Markdown и избегайте выполнения в браузере, если вывод не доказывает, что что-то отсутствует.

Другие страницы отправляют тонкую HTML-обертку и создают полезное содержимое после выполнения JavaScript. В этом случае рендеринг JavaScript может захватить состояние рендеренной страницы до того, как ответ будет преобразован в Markdown. Это делает Markdown более полным, но также делает запрос более тяжелым, поэтому рендеринг должен быть решением, основанным на доказательствах.

Полезные доказательства включают исходный HTML, рендеренный HTML, конечный URL, размер ответа, код состояния, состояние скриншота и несколько репрезентативных целевых образцов. Если Markdown уже полон из захвата источника, держите профиль легким. Если важные разделы появляются только после выполнения в браузере, намеренно рендерите этот шаблон URL.

Практическое замечание: рендерите для полноты Markdown, а не потому, что рендеринг доступен.

Чем преобразование страницы в Markdown отличается от парсера HTML в Markdown?

Фраза API парсера HTML в Markdown обычно начинается с захваченного HTML и сосредоточена на преобразовании. API для преобразования веб-страницы в Markdown начинается раньше в рабочем процессе: он принимает публичный URL, извлекает страницу, обрабатывает элементы управления запросом и затем возвращает Markdown в качестве выбранного формата ответа.

Это различие имеет значение в производстве. Захват страницы может включать перенаправления, заголовки, куки, сессии, таргетинг по странам, время ожидания, маршрутизацию через прокси, рендеринг JavaScript, проверки типа контента и ограничения по размеру ответа. Один конвертер не решает эти вопросы доставки. ScraperFly позволяет одной и той же модели запроса переходить от простого захвата источника к более полному состоянию страницы, когда цель доказывает, что это необходимо.

Если ваша команда уже имеет надежный HTML и нуждается только в преобразовании, рабочий процесс, сосредоточенный на парсере, может быть достаточным. Если проблема начинается с доставки публичного URL и продолжается в читаемом контенте, преобразование страницы в Markdown является более полным ментальным моделем.

Что командам следует проверить перед масштабированием захвата Markdown?

Хороший вывод Markdown — это не только вопрос форматирования. Он зависит от целевой страницы, состояния ответа, контента, который ваша система ожидает, и количества шума, которое страница добавляет вокруг полезных разделов.

  • Конечный URL и статус. Перенаправления, мягкие ошибки, страницы согласия или страницы вызова могут производить читаемый Markdown, который все равно является неправильным контентом.
  • Исходное против рендеренного содержимого. Сравните сырой захват с рендеренным захватом, прежде чем сделать выполнение в браузере по умолчанию.
  • Структура заголовков. Проверьте, отражают ли заголовки полезный контент или в основном повторяют навигацию и разделы шаблона.
  • Ссылки и списки. Убедитесь, что важные ссылки, элементы списка и границы разделов сохраняются в форме, которую ваше приложение может использовать.
  • Повторяющийся шаблон. Навигация, подвал, баннеры куки, рекомендации и реклама все еще могут появляться в Markdown и должны обрабатываться перед индексированием.
  • Таблицы и сложные макеты. Markdown может упростить сложные структуры. Держите HTML доступным, когда форма таблицы или точные отношения DOM имеют значение.

Эти проверки сохраняют честность вывода. Они также предотвращают то, чтобы команда рассматривала Markdown как магический слой очистки, когда настоящая проблема заключается в доставке, рендеринге, выборе цели или требовании извлечения на нижнем уровне.

Как командам следует выбирать между Markdown и другими форматами ScraperFly?

Самый безопасный подход — протестировать одну и ту же цель через несколько форматов ответа в API Builder. Используйте Markdown для читаемой структуры, текст для компактного текста, HTML для контроля парсера, JSON-метаданные для диагностики, скриншоты для визуального QA и PDF для переносных записей.

ФорматЛучшее соответствиеПравило принятия решения
MarkdownAI, RAG, документация, проверка и рабочие процессы читаемого контента.Используйте его, когда заголовки, ссылки и поток разделов улучшают опыт потребителя.
HTMLСелекторы, парсинг DOM, атрибуты, таблицы и точные отношения источника.Используйте его, когда парсеру нужна структурная точность.
ТекстЛегкий поиск, обобщения и простая обработка языка.Используйте его, когда структура не нужна.
JSON-метаданныеЛогирование, проверки статуса, конечный URL, тип контента и диагностика запросов.Используйте его вместе с форматами контента, чтобы упростить отладку запроса.
Скриншот или PDFВизуальное доказательство, QA, архив, соблюдение норм или человеческая проверка.Используйте визуальные файлы, когда внешний вид важнее, чем текст, читаемый машиной.

Для более широкого сравнения форматов ознакомьтесь с руководством по форматам ответов API для веб-скрапинга. Для рабочих процессов, специфичных для AI, свяжите решения по Markdown со страницей Scraping API для RAG и проверьте, нужны ли вашему контентному конвейеру Markdown, текст, HTML, метаданные или их комбинация.

Практическое замечание: не стандартизируйте один формат слишком рано; протестируйте цель и выберите ответ, который ваш продукт может использовать немедленно.

Как ScraperFly может сделать рабочие процессы Markdown предсказуемыми?

ScraperFly полезен, когда преобразование Markdown является частью более крупного рабочего процесса с публичными веб-данными. API может сохранять простые страницы легкими, добавлять рендеринг, когда JavaScript создает полезный контент, сохранять контекст запроса с заголовками и сессиями, маршрутизировать через специфические для страны или более сильные доставки, когда это необходимо, и возвращать альтернативные форматы, когда Markdown недостаточно.

Эта гибкость важна как для стоимости, так и для качества. Страница, которая чисто преобразуется из исходного HTML, не должна иметь тот же профиль запроса, что и рендеренная страница, которая требует ожиданий, непрерывности сессии или визуальных доказательств. Свяжите решение по выводу с весом запроса и используйте цены только после того, как поведение цели станет ясным.

Если цель — извлечение контента, а не форматирование Markdown, сравните эту страницу с API парсера веб-контента. Если цель — переносимый артефакт, используйте страницы PDF или скриншотов. Лучший рабочий процесс преобразования страницы в Markdown достаточно специфичен, чтобы быть полезным, и достаточно гибок, чтобы избежать ненужной инфраструктуры.


Рабочий процесс Markdown API

Создайте запрос URL-to-Markdown перед написанием кода очистки

Используйте API Builder, чтобы протестировать реальный публичный URL, сравнить исходный и рендеренный захват, выбрать вывод Markdown и оставить альтернативные форматы доступными, когда нижестоящий потребитель нуждается в большем количестве доказательств, чем читаемый контент.

URL
Ввод страницы

Начните с публичного URL, а не с предположения конвертера

Отправьте целевую страницу в ScraperFly и проверьте, что страница на самом деле возвращает, прежде чем встраивать предположения о Markdown в производство.

urlстатусфинальный URL
MD
Читаемый вывод

Возвращайте Markdown для проверки, RAG, документации и рабочих процессов AI

Сохраняйте заголовки, абзацы, списки и ссылки в форме, которая легче читается, разбивается на части, обобщается и передается в контентные системы.

format=markdownзаголовкиссылки
API
Контролируемый захват.

Добавляйте рендеринг или маршрутизацию только тогда, когда это необходимо для страницы

Используйте рендеринг, ожидания, сессии, заголовки, таргетинг по странам или более сильную маршрутизацию, когда они улучшают результат Markdown на реальных образцах.

рендерингожиданиямаршрутизация

Элементы управления, которые формируют вывод Markdown

url

Публичная страница, которую ScraperFly должен получить перед конвертацией.

format=markdown

Возвращайте читаемый Markdown вместо сырого HTML или простого текста.

render

Выполняйте JavaScript на стороне браузера, когда захват источника пропускает полезный контент.

render_wait

Ждите позднего контента, когда образцы доказательств показывают, что время влияет на вывод.

country

Запрашивайте состояние региональной страницы, когда контент меняется в зависимости от местоположения.

download

Используйте файловые артефакты только тогда, когда рабочий процесс требует сохраненного визуального или документального вывода.

пример cURL

Генерируйте Markdown с той же формой запроса, которую вы можете использовать в производстве

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Готовность Markdown

Проверьте поведение страницы перед масштабированием захвата URL в Markdown

Качество Markdown зависит от состояния страницы, которое захватывает ScraperFly. Пробуйте реальные URL для исходного контента, рендеренного контента, перенаправлений, языка, повторяющегося шаблона, сохранения ссылок, таблиц и точных разделов, которые нужны вашей системе.

01

Подтвердите, что контент существует на захваченной странице

Сравните исходный HTML и рендеренный вывод, чтобы команда знала, достаточно ли сырого захвата или оправдан ли рендеринг JavaScript.

Полезно, когда страницы отправляют тонкие HTML-оболочки или поздно загружаемые разделы.

02

Проверьте заголовки, ссылки и повторяющийся шаблонный шум

Читаемый Markdown все еще требует проверки. Навигация, нижние колонтитулы, баннеры согласия, реклама и рекомендации могут загрязнять контентные потоки.

Полезно перед индексацией, разбиением на части, суммированием или отправкой контента агенту.

03

Держите альтернативные выходные данные доступными для доказательства

Markdown не является визуальной записью и не является точным источником DOM. Храните HTML, метаданные JSON, скриншоты или PDF, когда рабочий процесс требует больше доказательств.

Полезно для отладки, контроля качества, соблюдения норм и специфической для парсера экстракции.

Вопросы перед выбором Markdown

Содержит ли исходный HTML уже полезный контент?

Если да, держите запрос легким и избегайте выполнения в браузере.

Изменяет ли рендеринг секции, которые имеют значение?

Если да, включите рендеринг для этого шаблона URL, а не глобально.

Будет ли потребитель использовать заголовки и ссылки?

Markdown наиболее эффективен, когда читаемая структура улучшает последующую работу.

Имеют ли селекторы или атрибуты все еще значение?

Держите HTML в рабочем процессе, когда требуется точное доказательство DOM.

Что изменяется в настройке запроса

Простые страницы остаются легкими

Захват источника плюс вывод Markdown достаточно, когда начальный ответ содержит контент.

Страницы JavaScript получают рендеринг на основе доказательств

Рендеринг, когда пример Markdown неполный без выполнения в браузере.

Региональные страницы нуждаются в соответствующем контексте

Используйте таргетинг по стране, заголовки или сессии, когда контент страницы меняется в зависимости от контекста посетителя.

Визуальное доказательство остается отдельным

Используйте вывод в виде скриншота или PDF, когда людям нужно проверить, как выглядела страница.

Почему ScraperFly

Выберите захват Markdown без привязки каждого сканирования к тяжелому рабочему процессу краулера

Многие инструменты рассматривают Markdown как функцию краулинга все или ничего или оставляют командам собирать вместе загрузчики, браузеры, конвертеры и скрипты очистки. ScraperFly сохраняет Markdown в той же модели запроса, что и HTML, текст, метаданные JSON, скриншоты, PDF, рендеринг и маршрутизация.

Легкий старт

Сначала протестируйте Markdown на реальных целях

Начните с бесплатных кредитов, сравните форматы ответов и докажите, действительно ли Markdown уменьшает объем работы, прежде чем тратить время на разработку.

бесплатные кредитыКонструктор APIобразцы URL
Гибкий вывод

Сохраняйте каждую форму ответа близкой

Используйте Markdown для читаемого контента, HTML для парсеров, текст для легкого копирования, JSON для диагностики и визуальные файлы для доказательства.

MarkdownHTMLJSON
Умная стоимость

Добавляйте более строгие меры только с доказательствами

Рендеринг, ожидания, сессии, таргетинг по странам и премиум маршрутизация доступны, когда они улучшают состояние страницы, а не принудительно по умолчанию.

рендерить по мере необходимостимаршрутизацияконтроль затрат

Где ScraperFly лучше подходит для рабочих процессов Markdown

Наилучший вариант — это команда, которая хочет читаемый контент страницы, не теряя контроля над захватом, выбором формата, весом запроса и контекстом отладки.

Точка принятия решенияПреимущество ScraperFlyТипичная альтернатива
Первый тестПопробуйте URL, проверьте вывод и сравните Markdown с HTML, текстом, JSON, скриншотом или PDF перед написанием кода.Часто начинается с фиксированного краулера, библиотеки конвертера или решения плана перед тем, как целевое поведение будет доказано.
Страницы JavaScriptВключайте рендеринг только тогда, когда захват источника упускает полезный контент, и Markdown улучшается после выполнения в браузере.Рендеринг может быть по умолчанию, в комплекте или неясным, что может сделать простые страницы тяжелее, чем необходимо.
Вывод доказательстваСохраняйте опции Markdown, HTML, метаданных, скриншотов и PDF близкими к одному и тому же рабочему процессу запросов.Читаемый Markdown может быть отделен от отладочных метаданных или визуальных доказательств.
Контроль затратСвяжите вес запроса с контролями, которые действительно изменили захваченный результат.Цены могут быть сложнее для понимания, когда краулинг, рендеринг, конверсия и поведение прокси объединены.

Контроль затрат Markdown

Сделайте переход от страницы к Markdown доступным, сопоставив вес запроса с реальным поведением цели

Сам по себе Markdown не должен делать простую публичную страницу тяжелой. Дорогая часть обычно заключается в окружающем профиле захвата: рендеринг браузера, ожидания, сессии, региональный контекст, премиум маршрутизация, скриншоты, PDF и повторные попытки. Используйте их, когда они улучшают результат Markdown или предоставляют необходимые доказательства.

Легкий HTML-запрос, возвращающий простой ответ
01

Базовый запрос

Используйте базовый запрос, когда публичный HTML уже содержит необходимые вам поля.

Самый легкий профиль запроса; сохраняйте его, когда ответ завершен.

Рендеринг JavaScript, создающий полный DOM
02

Рендеринг

Используйте рендеринг, когда сырой HTML является оболочкой, а JavaScript завершает страницу.

Более тяжелый профиль; используйте его только когда вывод браузера изменяет результат.

Несколько запросов с сохранением cookies и состояния посетителя
03

Состояние сессии

Используйте сессии, когда cookies, согласие, локализация или пагинация изменяют ответ.

Более тяжелый профиль состояния; сохраняйте его только когда важна непрерывность.

Маршрутизация запросов через гео и более качественные маршруты
04

Премиум маршрутизация и гео

Используйте премиум маршрутизацию или гео только когда источник, страна, репутация или региональный контент изменяют результат.

Самый тяжелый профиль маршрутизации; применяйте его только к целям, которые доказывают, что они в этом нуждаются.

Что может сделать захват Markdown более тяжелым

Рендеринг браузера

Полезно, когда JavaScript создает контент, которого нет в исходном HTML.

Время ожидания

Полезно, когда целевая страница загружает важные разделы после запуска браузера.

Сессия или заголовки

Полезно, когда контент зависит от согласия, языка, непрерывности или контекста запроса.

Визуальные файлы

Полезно для QA или архива, но не нужно для машинных Markdown-пайплайнов.

Как сохранить предсказуемость рабочих процессов Markdown

Начните с захвата источника

Используйте сырое состояние страницы, когда оно уже производит полный Markdown.

Сравните форматы перед масштабированием

Тестируйте Markdown на соответствие HTML и тексту, чтобы подтвердить, что он устраняет реальную downstream работу.

Рендеринг по целевому шаблону

Не делайте выполнение в браузере по умолчанию для каждого URL, когда только некоторые страницы нуждаются в этом.

Отделите доказательства от парсинга

Используйте скриншоты и PDF для визуальных доказательств, а не как замену для машинно-читаемого контента.

Часто задаваемые вопросы о Markdown

Распространенные вопросы о преобразовании веб-страниц в Markdown

Практические ответы для команд, решающих, когда Markdown является правильным форматом ответа, когда рендеринг стоит использовать и как сохранить захват контента, готового к AI, полезным, не перегружая скрап.

ЧАВО ПО MARKDOWN
FORMAT

Выбор Markdown

Используйте Markdown, когда читаемая структура помогает последующему рабочему процессу.

Когда Markdown лучше, чем текст?

Markdown лучше, когда заголовки, списки и ссылки помогают в обзоре, делении на части, документации, поиске или контексте ИИ.

Когда HTML все еще лучше?

HTML лучше, когда селекторы, атрибуты, точные отношения DOM или структура таблицы важны для парсера.

RENDERING

Захват правильного состояния страницы

Markdown может конвертировать только то, что захватывает запрос.

Должен ли каждый запрос Markdown использовать рендеринг?

Нет. Начните с захвата источника и включите рендеринг только тогда, когда JavaScript создает контент, который иначе пропустит Markdown.

Могут ли ожидания улучшить вывод Markdown?

Да, когда образцы страниц показывают, что важный контент появляется после короткой задержки браузера.

AI

Рабочие процессы ИИ и RAG

Читаемый Markdown может сделать последующий контент более удобным для использования.

Хорош ли Markdown для RAG?

Часто да. Это может сохранить поток разделов и ссылки, удаляя при этом большую часть «сырого» HTML-шума, который мешает поглощению.

Что мне следует проверить перед индексацией Markdown?

Проверьте основной контент, заголовки, ссылки, шаблоны, конечный URL, статус, размер ответа, язык и настройки рендеринга.

PROOF

Ограничения и альтернативы

Markdown полезен, но это не единственный вывод, который может понадобиться в производственном процессе.

Является ли Markdown тем же самым, что и извлечение статьи?

Нет. Markdown — это читаемый формат ответа, а не гарантированный артикул, автор, дата, цена или извлекатель схемы.

Могу ли я по-прежнему запрашивать скриншоты или PDF?

Да. Используйте визуальные файлы, когда внешний вид, архив, обзор или доказательство соблюдения важнее, чем содержимое, читаемое машиной.

