






Чистый текстовый вывод
Извлечение читаемого текста страницы без лишнего разметочного шума
Многие рабочие процессы скрапинга не требуют полного DOM. Им нужны читаемые части публичной страницы: текст статьи, описания продуктов, текст политики, детали списков, поддерживающий контент или заметки об обновлениях, которые могут быть использованы в поиске, QA, мониторинге, резюме или легкой классификации ИИ.
ScraperFly помогает командам получать публичную страницу, рендерить ее, когда JavaScript создает полезный контент, и возвращать чистый текст в качестве практичного формата вывода. Это позволяет сохранить простые рабочие процессы контента компактными, сохраняя возможность запрашивать HTML, Markdown, метаданные JSON, скриншоты или PDF, когда задача требует большей структуры или доказательства.
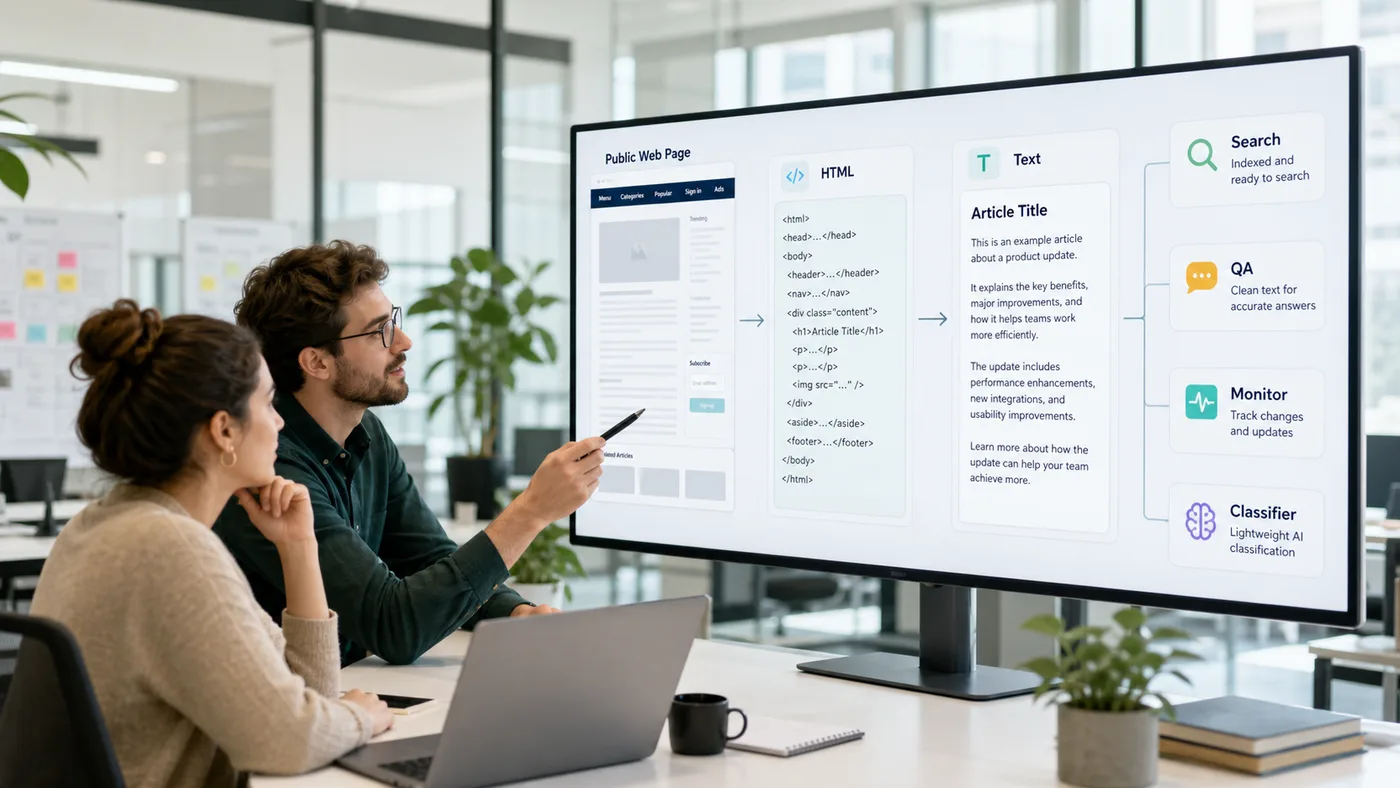
Что такое API парсера HTML в текст?
API парсера HTML в текст получает публичную веб-страницу и возвращает читаемый простой текст вместо сырой разметки. Цель не в том, чтобы сохранить каждое отношение DOM. Цель состоит в том, чтобы удалить код разметки, повторяющуюся навигацию, скрипты, атрибуты и визуальные конструкции, чтобы контент можно было проверять, индексировать, сравнивать, резюмировать или направлять в последующие системы.
Слой захвата все еще решает, полезен ли текст. Если целевая страница отправляет значимый контент в исходном HTML, текстовый вывод может оставаться легким. Если важный контент появляется только после выполнения JavaScript на стороне браузера, запрос может потребовать рендеринга перед преобразованием текста. ScraperFly сохраняет оба пути доступными через один API.
Когда текст лучше, чем HTML или Markdown?
Текст — это самый простой полезный формат, когда рабочий процесс больше заботится о словах, чем о структуре. Он хорошо подходит для индексирования в поисковых системах, мониторинга изменений, QA обзоров, классификации, обнаружения дубликатов, резюме и легкой предварительной обработки ИИ. Он предоставляет приложению компактный контент, который легче хранить и сравнивать, чем сырое HTML.
Текст не идеален, когда рабочий процесс требует заголовков, ссылок, цитат, списков, контекста таблиц или специфической для DOM извлечения. В таких случаях Markdown или HTML могут иметь более полезную структуру. Лучшая производственная настройка выбирает формат ответа от конечного потребителя, а не рассматривает каждую страницу как общий скрап.
| Формат | Лучше всего подходит для | Основное преимущество | Когда выбрать другой вывод |
|---|---|---|---|
| Текст | Поиск, мониторинг, QA, резюме, классификация, компактный анализ. | Маленький, читаемый и легкий для сравнения. | Когда важны заголовки, ссылки или отношения DOM. |
| Markdown | RAG, документация, редакторский обзор, ввод ИИ с читаемой структурой. | Сохраняет больше формы контента, чем простой текст. | Когда рабочий процесс требует только компактного прозы. |
| HTML | Селекторы, атрибуты, таблицы, ссылки, инспекция источника, структурированный парсинг. | Сохраняет разметку страницы для пользовательских правил извлечения. | Когда сырая разметка создает ненужную работу по очистке. |
| JSON метаданные | Диагностика, ведение журналов, доказательства ответа, QA запросов. | Объясняет статус, конечный URL, тип контента и контекст захвата. | Когда приложению нужен фактический читаемый текст. |
Как рендеринг JavaScript влияет на извлечение текста?
Преобразование текста может очистить только тот контент, который захватывает запрос. Если исходный HTML уже содержит полезный текст, рендеринг добавляет вес без улучшения вывода. Если страница отправляет оболочку приложения и заполняет видимый контент после гидратации, рендеринг может сделать финальный текст полным.
Дисциплинированный рабочий процесс тестирует оба состояния на реальных целях. Начните с захвата источника, проверьте текст, затем включите рендеринг, когда важный текст отсутствует. Если контент приходит поздно, может иметь значение настройка ожидания. Если страница меняется по языку, куки или региону, заголовки, сессии или маршрутизация по странам могут влиять на захваченный текст больше, чем сам рендеринг.
Для страниц, которые требуют выполнения в браузере, API рендеринга JavaScript объясняет решение о рендеринге. Для сравнения текста с HTML, Markdown, JSON, скриншотами и PDF используйте руководство по форматам ответов.
Что командам следует проверить перед масштабированием извлечения текста?
Чистый текст легко воспринимается, что делает плохой текст легким для пропуска. Перед пакетной обработкой большого набора URL проверьте, что основной контент присутствует, повторяющаяся навигация уменьшена, язык правильный, перенаправления не изменили страницу, и важные оговорки или детали цен не исчезли во время очистки.
Проверка особенно важна для мониторинга и рабочих процессов ИИ. Классификатор, поисковый индекс или резюме могут с удовольствием обрабатывать неполный текст, если запись захвата не объясняет, что произошло. Храните конечный URL, статус, тип контента, размер ответа, настройку рендеринга и формат вывода с каждым результатом, чтобы команда могла отделить изменения цели от ошибок извлечения.
| Проверка | Почему это важно | Полезный сигнал |
|---|---|---|
| Основное тело присутствует | Поиск, резюме и мониторинг нуждаются в фактическом контенте, а не только в текстовой разметке. | Сравните текстовый вывод с образцами источника или рендеринга. |
| Уровень шума | Навигация и повторяющийся шаблон могут исказить классификаторы и резюме. | Проверьте повторяющиеся фразы на нескольких URL. |
| Язык и регион | Цели могут варьировать копию по стране, языку, валюте или состоянию согласия. | Записывайте заголовки, маршрутизацию по странам, конечный URL и образцы видимого контента. |
| Размер ответа | Маленький текстовый вывод может указывать на перенаправления, мягкие блокировки или пустые состояния рендеринга. | Установите ожидаемые диапазоны размеров для каждого типа цели. |
| Соответствие формата | Некоторые рабочие процессы нуждаются в ссылках, таблицах или структуре цитирования. | Переключитесь на Markdown или HTML, когда простой текст удаляет слишком много контекста. |
Где текстовый вывод вписывается в производственные рабочие процессы?
Текстовый вывод полезен, когда результат скрапинга подает систему, которая читает, сравнивает или классифицирует контент, а не извлекает точные поля DOM. Задача мониторинга может сравнивать текстовые снимки. Поисковый конвейер может индексировать читаемый текст. Процесс QA может проверять, изменилась ли публичная страница. Легкий рабочий процесс ИИ может классифицировать или резюмировать контент, не включая разметку в запрос.
ScraperFly сохраняет этот рабочий процесс практичным, потому что текстовый вывод является одной из опций в той же модели запроса. Команды могут протестировать цель в API Builder, выбрать текстовый вывод, добавить рендеринг только при необходимости и сохранить HTML или скриншоты для отладки, когда текст сам по себе не может объяснить результат.
Как преобразование текста остается доступным?
Преобразование HTML в текст может оставаться легким, когда исходный ответ уже содержит контент. Стоимость увеличивается, когда рабочий процесс добавляет рендеринг браузера, время ожидания, сессии, маршрутизацию по странам, премиум-доставку, скриншоты, PDF или повторные попытки. Эффективный подход — начать с простого, проверить вывод и добавлять контроль только тогда, когда они улучшают захваченный текст.
Это делает текстовый вывод хорошим выбором для неравномерных проектов и повторяющихся систем. Команды могут проверить несколько целей с помощью бесплатных кредитов, использовать кредиты по мере необходимости для случайной работы по очистке и переводить предсказуемые задачи извлечения или мониторинга на месячные кредиты, когда профиль запроса подтвержден. Страница цен объясняет, как этот путь масштабируется, не заставляя каждый эксперимент переходить на подписку.







