






Transferência de conteúdo limpa
Transforme páginas capturadas em Markdown que sua equipe realmente pode usar
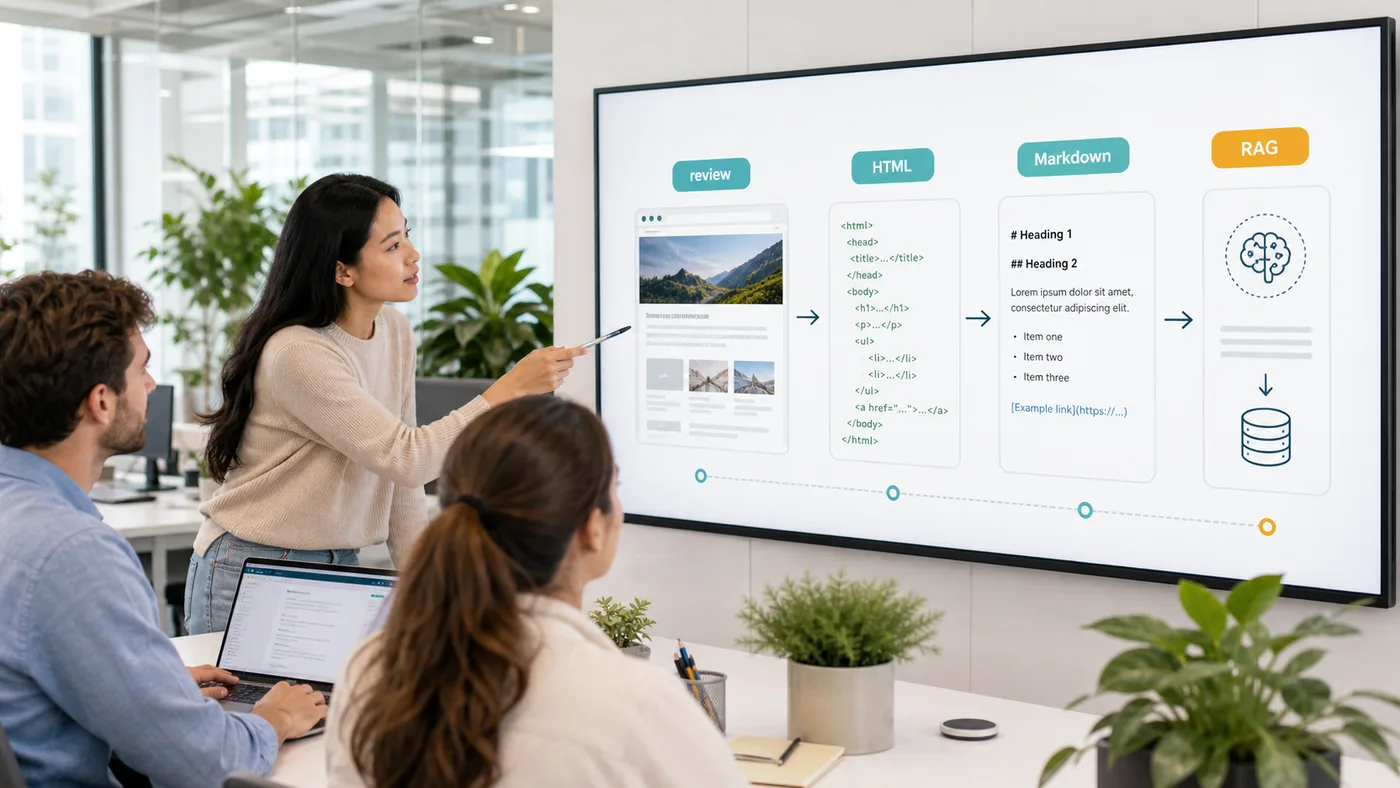
HTML bruto é poderoso, mas muitas vezes é barulhento para revisão de conteúdo, ingestão de IA, documentação, indexação de busca e pipelines RAG. Navegação, layout repetido, scripts, atributos e boilerplate podem enterrar o conteúdo útil da página antes que chegue às pessoas ou sistemas que precisam dele.
ScraperFly ajuda equipes a buscar páginas públicas, renderizá-las quando o JavaScript é necessário e retornar Markdown como um formato de trabalho mais limpo. O resultado é mais fácil de ler, mais fácil de comparar e mais fácil de passar para ferramentas subsequentes sem construir um conversor personalizado para cada alvo.
O que é uma API de parser de HTML para Markdown?
Uma API de parser de HTML para Markdown busca uma página da web pública e retorna Markdown legível em vez de marcação bruta. O Markdown pode preservar estruturas úteis, como títulos, parágrafos, listas, links e fluxo de seções, enquanto remove muito do ruído de layout que torna o HTML bruto difícil de consumir para editores, agentes, sistemas de busca e pipelines de conteúdo.
A etapa de captura ainda é importante. Se o conteúdo útil da página estiver presente no HTML de origem, a solicitação pode permanecer leve. Se um site constrói o conteúdo no navegador, o fluxo de trabalho pode precisar de HTML renderizado antes da conversão para Markdown. ScraperFly mantém esses controles em um único caminho de solicitação para que as equipes possam escolher o perfil mais simples que retorna conteúdo completo.
Quando o Markdown é melhor que o HTML bruto?
Markdown é uma boa opção quando humanos ou fluxos de trabalho de modelos de linguagem precisam ler a página. É mais fácil de inspecionar do que a marcação bruta, menos confuso do que o HTML do navegador e mais estruturado do que texto simples. Isso o torna útil para revisão editorial, ingestão de base de conhecimento, resumos de IA, indexação de busca, monitoramento leve e fluxos de trabalho de documentação.
Não é o melhor formato para todos os trabalhos. Se o parser precisar de atributos exatos, relacionamentos DOM aninhados, direcionamento de seletores ou geometria de tabela, HTML bruto ou renderizado pode ser mais seguro. Se o fluxo de trabalho precisar apenas de prosa legível compacta, texto limpo pode ser suficiente. O ponto é escolher o formato de saída em torno do consumidor, em vez de converter cada captura na mesma forma.
| Formato de saída | Melhor adequado para | Principal vantagem | Compensação |
|---|---|---|---|
| Markdown | Ingestão de IA, RAG, docs, revisão editorial, arquivos legíveis. | Preserva títulos, listas, links e fluxo de seção legível. | Menos preciso que HTML para parsing específico do DOM. |
| HTML bruto | Seletores, atributos, descoberta de links, extração estruturada. | Preserva a marcação de origem e os relacionamentos da página. | Requer mais limpeza antes da revisão humana ou de IA. |
| HTML renderizado | Páginas onde o JavaScript cria o DOM útil. | Captura a marcação construída pelo navegador antes da conversão. | Mais pesado que a captura de origem e deve ser usado deliberadamente. |
| Texto | Busca compacta, indexação e análise de conteúdo simples. | Pequeno e fácil de processar. | Remove muito da estrutura que o Markdown pode preservar. |
Como a renderização afeta a qualidade do Markdown?
A conversão para Markdown só pode usar o conteúdo que foi capturado. Se uma página pública enviar todo o conteúdo do artigo ou produto na resposta HTML inicial, a renderização pode não melhorar o Markdown. Se a página enviar um shell JavaScript e preencher o conteúdo útil após a hidratação, a conversão para Markdown deve ocorrer após a execução do navegador.
O melhor fluxo de trabalho compara amostras antes de escalar. Comece com a captura de origem, inspecione o Markdown e, em seguida, teste a saída renderizada quando seções importantes estiverem faltando. Se o conteúdo que carrega tarde for importante, pode ser necessário um ajuste de espera. Se o resultado mudar por sessão, cabeçalho ou país, esses controles devem ser adicionados porque o comportamento alvo prova que eles importam, não porque cada solicitação de Markdown deve ser pesada por padrão.
Para páginas construídas pelo navegador, a API de renderização JavaScript explica quando a renderização vale a pena ser habilitada. Para escolher entre HTML, texto, Markdown, JSON, capturas de tela e PDFs, use o guia de formatos de resposta.
O que as equipes devem validar antes de usar Markdown em IA ou RAG?
Markdown é útil para fluxos de trabalho de IA porque pode preservar uma estrutura legível sem expor um modelo ou pipeline de ingestão a marcação barulhenta. No entanto, as equipes devem validar a saída antes de confiar nela. Verifique se o conteúdo principal sobreviveu à conversão, se os títulos são significativos, se os links permanecem úteis, se a navegação repetida é reduzida e se tabelas ou listas importantes não foram achatadas em texto confuso.
Para RAG e busca, a consistência importa tanto quanto a legibilidade. Armazene evidências de resposta suficientes para explicar cada documento: URL alvo, URL final, status, tipo de conteúdo, tamanho da resposta, configuração de renderização e formato de saída selecionado. Esse contexto ajuda as equipes a depurar seções ausentes, páginas desatualizadas, variantes regionais e casos em que o mesmo alvo precisa de HTML em vez de Markdown.
| Verificação de validação | Por que isso importa | Ação prática |
|---|---|---|
| Conteúdo principal | Fluxos de trabalho de IA e revisão precisam do corpo real da página, não apenas da navegação. | Compare o Markdown com amostras da página de origem ou renderizada. |
| Estrutura de títulos | Títulos úteis melhoram a fragmentação, resumos e revisão humana. | Verifique se H1, H2 e fluxo de seção sobrevivem à conversão. |
| Links | Links podem preservar citação, descoberta e contexto de acompanhamento. | Confirme se âncoras e URLs importantes permanecem visíveis. |
| Tabelas e listas | Estruturas complexas podem se tornar menos claras quando convertidas. | Use fluxos de trabalho em HTML ou JSON quando a estrutura exata importa. |
| Metadados de evidência | As equipes precisam saber como a página foi capturada. | Armazene status, URL final, tamanho, configuração de renderização e formato com o conteúdo. |
Onde o ScraperFly reduz o trabalho de conversão?
Sem um fluxo de trabalho hospedado, as equipes frequentemente buscam HTML, operam trabalhadores de navegador, limpam boilerplate, escrevem lógica de conversão, lidam com alvos falhados e, em seguida, constroem verificações separadas para ingestão de IA ou revisão editorial. Isso cria muito código de cola em torno do que deveria ser uma transferência de conteúdo direta.
ScraperFly encurta esse caminho. A mesma solicitação de API pode capturar o alvo, renderizar páginas JavaScript quando necessário, retornar Markdown e manter saídas alternativas disponíveis para casos em que o Markdown não é suficiente. Os desenvolvedores podem testar um alvo no API Builder, comparar formas de resposta e mover o perfil de solicitação para produção uma vez que a saída seja comprovada.
Como a conversão para Markdown se mantém consciente dos custos?
Markdown em si não é a parte cara. O peso da solicitação cresce quando o fluxo de trabalho adiciona renderização de navegador, esperas mais longas, sessões, roteamento premium, capturas de tela, PDFs ou tentativas repetidas. O padrão consciente dos custos é começar com a solicitação mais leve que pode produzir Markdown completo, e então adicionar controles apenas quando o alvo provar que eles melhoram o resultado.
Isso se encaixa tanto em pequenos projetos quanto em sistemas de produção. As equipes podem validar alvos com créditos gratuitos, usar créditos pay-as-you-go para trabalho de conversão desigual e mover cargas de trabalho recorrentes para créditos mensais quando o perfil de solicitação é previsível. A página de preços explica como esse caminho de compra mantém os testes acessíveis enquanto deixa espaço para escalar.










