






Готовый к парсингу захват
Преобразуйте публичные страницы в чистые входные данные, которым может доверять ваш парсер
Парсинг контента веб-сайта начинается до написания правил извлечения. Ваша команда должна знать, что на самом деле возвращает публичная страница, находится ли полезный контент в исходном HTML или отрендеренном выводе, и какой формат ответа упростит последующий парсинг, а не сделает его более шумным.
ScraperFly предоставляет разработчикам практический уровень захвата для контента публичных веб-сайтов. Получите страницу, проверьте ответ, выберите HTML, текст, Markdown, метаданные, скриншоты или PDF, и оставьте логику парсинга, классификацию, обогащение и хранение внутри вашего продукта, где и должны находиться бизнес-правила.
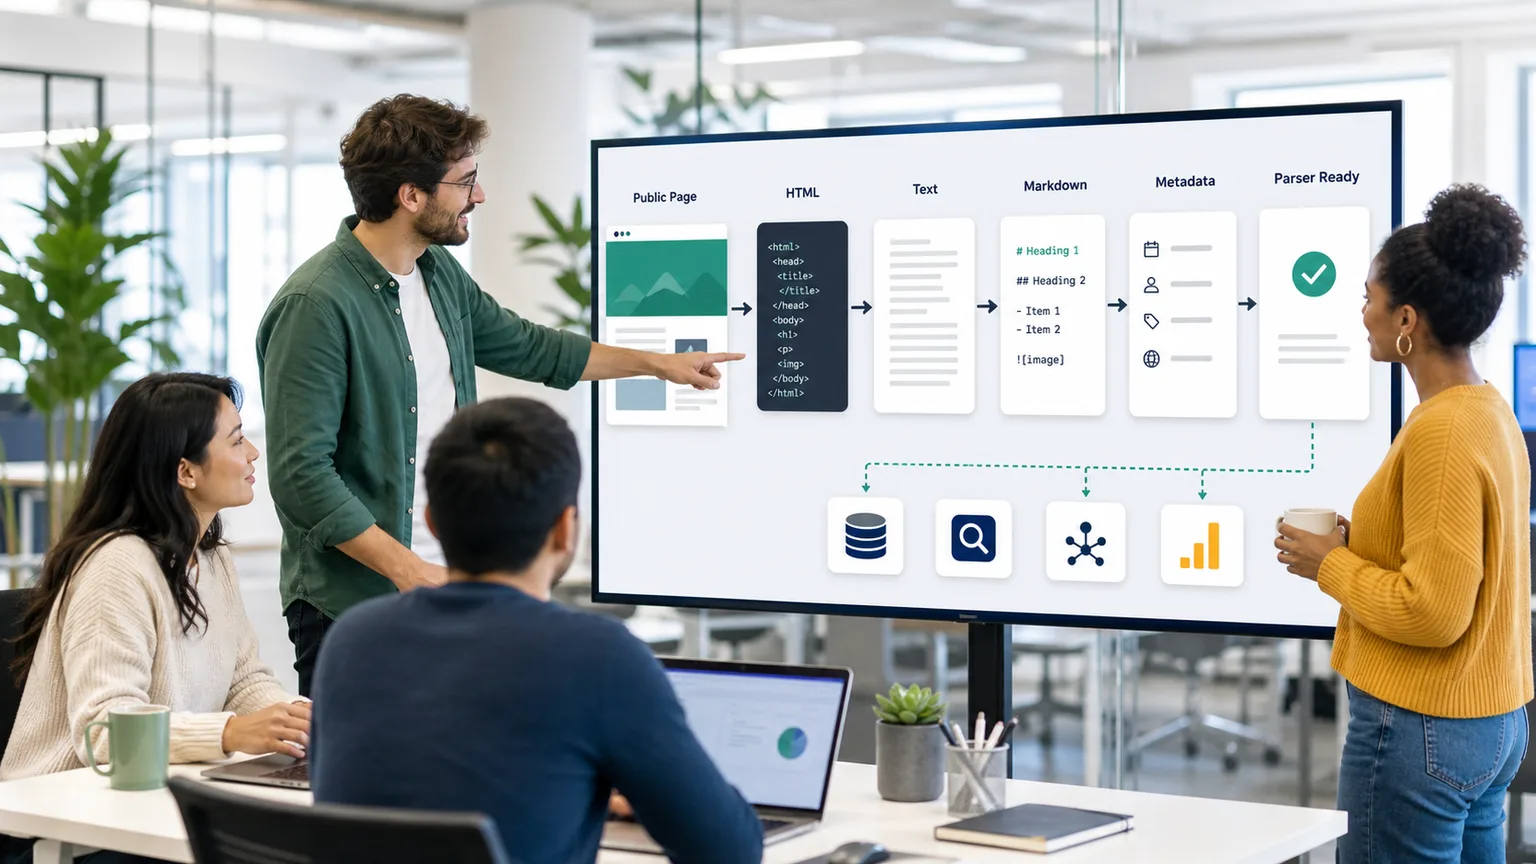
Что такое API для парсинга контента веб-сайта?
API для парсинга контента веб-сайта полезен, когда он предоставляет вашему приложению надежный ввод страницы для парсера, контентного конвейера, поискового индекса, AI-рабочего процесса, архива или системы контроля качества. API должен надежно захватывать публичную страницу и возвращать достаточно структуры, чтобы ваш последующий код мог решить, что имеет значение.
ScraperFly сосредоточен на уровне захвата и ответа. Он может возвращать сырой или отрендеренный HTML, когда структура DOM имеет значение, текст, когда парсеру нужно только читаемое содержимое, Markdown, когда заголовки и ссылки помогают в обзоре или поглощении AI, JSON-метаданные, когда журналам нужен операционный контекст, и визуальные файлы, когда человеку нужно доказательство того, как страница выглядела.
Практическое резюме: используйте ScraperFly для чистого захвата контента публичного веб-сайта, затем оставьте специфические для цели правила парсинга в системе, которая понимает вашу модель данных.
Что должно произойти перед созданием правил парсинга?
Дорогая ошибка — писать парсеры против воображаемой формы страницы. Публичный веб-сайт может скрывать полезный контент в первом HTML-ответе, прятать его за рендерингом на стороне клиента, повторять его в навигации, перемещать в метаданные или возвращать небольшую оболочку, которая говорит вам очень мало, пока браузер не запустится. Первая задача — доказать форму захвата.
Начните с простого запроса, проверьте статус, конечный URL, тип контента, размер ответа и содержимое тела, затем решите, что должен потреблять парсер. Если исходный HTML уже содержит целевой контент, оставьте запрос легким. Если JavaScript изменяет результат, протестируйте отрендеренный вывод. Если конвейер ориентирован на AI, сравните чистый текст и Markdown перед созданием конвертеров.
| Вопрос | Что проверять | Лучшее решение |
|---|---|---|
| Полезный контент уже присутствует? | Исходный HTML, размер ответа, заголовки, ссылки, таблицы, карточки продуктов, тело статьи или встроенные метаданные. | Используйте легкий HTML или текстовый запрос, когда первый ответ достаточен. |
| Создает ли JavaScript конечную страницу? | Сравните исходный HTML с отрендеренным HTML и видимым состоянием страницы. | Включайте рендеринг только тогда, когда выполнение браузера изменяет захваченный контент. |
| Нужна ли парсеру структура DOM? | Селекторы, атрибуты, списки, ссылки, пагинация, структурированные таблицы и повторяющиеся блоки. | Используйте HTML, когда структурные отношения имеют значение. |
| Является ли потребителем AI или рабочий процесс обзора? | Читаемые заголовки, ссылки, разделы статей, шаблоны и повторяющийся шум макета. | Попробуйте текст или Markdown перед созданием пользовательского слоя очистки. |
| Нужен ли результату доказательства? | Статус, конечный URL, тип контента, скриншот, PDF или артефакт архива. | Добавьте метаданные или визуальный вывод, когда отладка, QA, соблюдение или обзор требуют доказательства. |
Какой формат вывода лучше всего подходит для парсинга контента веб-сайта?
Нет единого формата, который был бы лучшим для каждого парсера. HTML мощен, когда логика извлечения требует структуры DOM, но он также приносит навигацию, макет, скрипты и повторяющийся шум шаблона. Текст компактен и легко ищется, но он удаляет большую часть структурного контекста. Markdown полезен для рабочих процессов читаемого контента, потому что заголовки, ссылки и списки остаются легче для понимания. Метаданные помогают отладить запрос, не заставляя парсер делать выводы из тела.
Практический путь — протестировать два или три вывода на реальных целевых страницах перед производством. Парсер для контента статей может предпочесть Markdown. Работа по обнаружению ссылок может потребовать HTML. Мониторинговая работа может сочетать текст с JSON-метаданными. Рабочий процесс QA может прикреплять скриншоты или PDF только для записей, которые требуют визуального обзора.
| Вывод | Используйте его, когда | Следите за компромиссом |
|---|---|---|
| HTML | Парсеру нужны селекторы, атрибуты, ссылки, таблицы, встроенные данные или повторяющиеся шаблоны DOM. | Требует очистки и специфической для цели логики парсинга. |
| Отрендеренный HTML | Исходный ответ неполный, пока JavaScript не построит страницу. | Тяжелее, чем базовый запрос, поэтому включайте его для проверенных целей. |
| Текст | Рабочий процесс нуждается в компактном читаемом контенте для сопоставления, поиска, резюме или классификации. | Структурный контекст снижен. |
| Markdown | Заголовки, ссылки, списки и читаемые разделы помогают AI, RAG, документации или обзору аналитиков. | Не является заменой для точного извлечения DOM. |
| JSON-метаданные | Журналы нуждаются в конечном URL, статусе, типе контента, времени или контексте ответа. | Метаданные объясняют запрос; они не создают пользовательские целевые поля. |
| Скриншот или PDF | Обозревателю или архиву нужно визуальное доказательство состояния публичной страницы. | Менее удобно для машинного парсинга и тяжелее, чем текстовый вывод. |
Сравните полный набор форматов на странице форматов ответов API для веб-скрапинга, затем протестируйте реальный URL в API Builder.
Когда рендеринг помогает парсеру контента?
Рендеринг помогает, когда выполнение браузера изменяет полезный контент. Это распространено на страницах, которые наполняют тела статей, карточки продуктов, списки, отзывы, комментарии, результаты поиска или контент, специфичный для маршрута, после первого HTML-ответа. Это не знак качества само по себе. Рендеринг каждой страницы может сделать парсер медленнее, тяжелее и сложнее для понимания.
Хороший рабочий процесс парсера сравнивает сырой захват источника с отрендеренным захватом перед выбором по умолчанию. Если сырой HTML содержит данные, придерживайтесь простого пути. Если страница возвращает пустую оболочку, задержанный контент или другой конечный DOM после выполнения кода на стороне клиента, используйте API рендеринга JavaScript и выберите наименьший полезный вывод после рендеринга.
Где должна находиться логика парсинга?
ScraperFly не следует рассматривать как черный ящик, который волшебным образом знает бизнес-смысл каждой цели. Ваш продукт знает, какая цена имеет значение, какой раздел статьи важен, какие поля отзыва приемлемы, какие варианты страниц действительны и как извлеченный контент должен храниться. Эта логика принадлежит вашему приложению.
ScraperFly упрощает создание этого приложения, обрабатывая уровень запросов: получение публичных страниц, рендеринг при необходимости, сохранение заголовков или сессий, когда цель требует контекста, маршрутизация через страну, когда публичный контент различается по местоположению, и возвращение форматов, которые уменьшают работу по очистке. Ваш парсер может затем сосредоточиться на специфических для цели правилах, которые создают ценность.
Для базового захвата разметки смотрите HTML scraping API. Для читаемых входных данных на нижнем уровне сравните страницы HTML to text parser API и HTML to Markdown parser API.
Как ScraperFly сохраняет практичность рабочих процессов парсинга?
Проекты парсинга часто начинаются с неизвестных целей. Некоторые страницы просты. Некоторые требуют рендеринга. Некоторые нуждаются в заголовках, куках, таргетировании по странам или премиум маршрутизации. Некоторые не должны масштабироваться, пока форма ответа не будет доказана. ScraperFly поддерживает этот инкрементальный путь, а не заставляет использовать самый тяжелый профиль запроса с первого дня.
Начните бесплатно, протестируйте репрезентативные целевые страницы и держите каждый источник на самом легком профиле запроса, который возвращает полный используемый контент. Используйте кредиты по мере необходимости, пока поведение и объем цели все еще неопределенны, затем переместите повторяющиеся нагрузки парсера на месячные кредиты, как только спрос станет предсказуемым. Это связывает усилия инженеров и стоимость запросов с доказательствами, а не с догадками.
Практическое резюме: лучший парсер контента веб-сайта начинается с доказанной формы захвата, небольшого набора форматов ответа и четкого пути обновления для более сложных целей.










