






Transferencia de contenido limpio
Convierte páginas capturadas en Markdown que tu equipo realmente puede usar
El HTML en bruto es poderoso, pero a menudo es ruidoso para la revisión de contenido, la ingesta de IA, la documentación, la indexación de búsqueda y los pipelines de RAG. La navegación, el diseño repetido, los scripts, los atributos y el boilerplate pueden enterrar el contenido útil de la página antes de que llegue a las personas o sistemas que lo necesitan.
ScraperFly ayuda a los equipos a obtener páginas públicas, renderizarlas cuando se requiere JavaScript y devolver Markdown como un formato de trabajo más limpio. El resultado es más fácil de leer, más fácil de comparar y más fácil de pasar a herramientas posteriores sin construir un convertidor personalizado para cada objetivo.
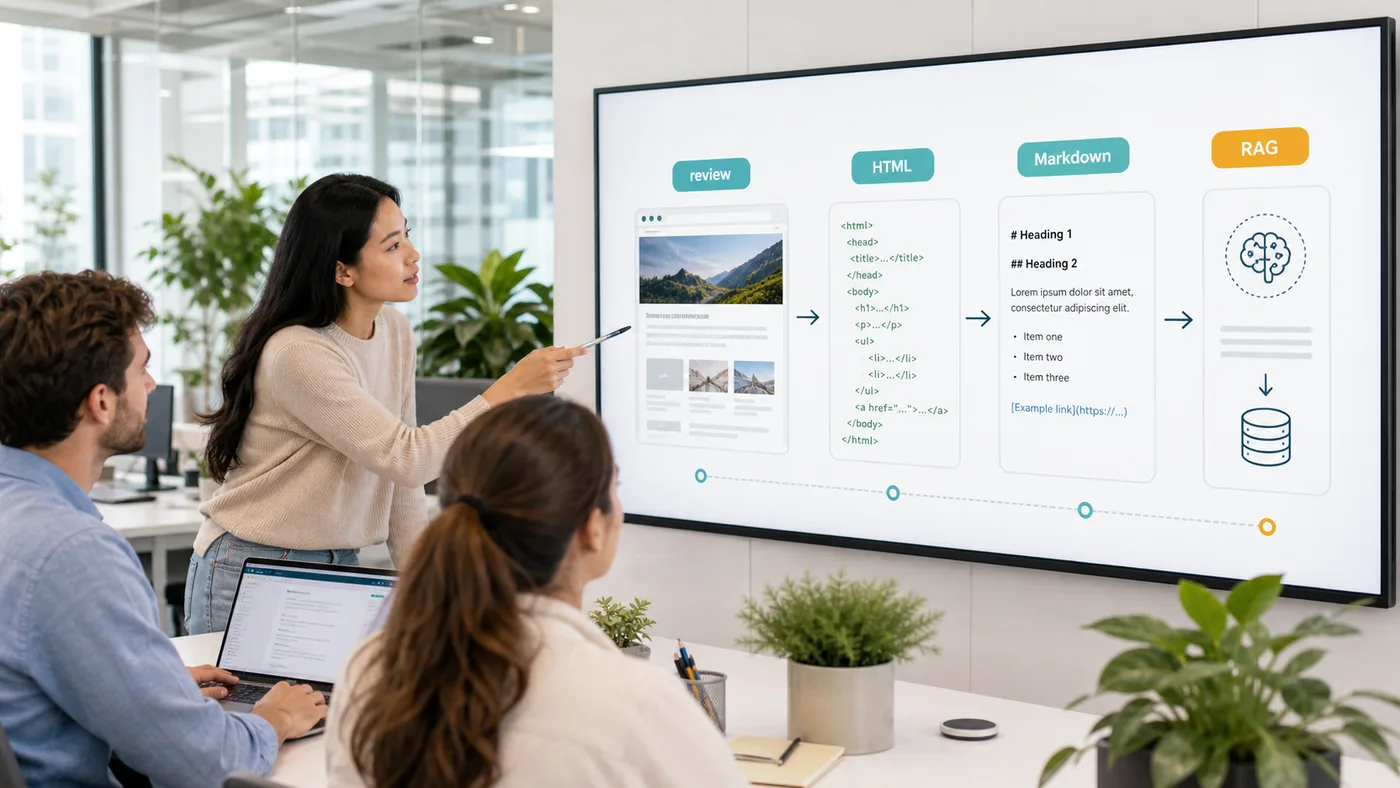
¿Qué es una API de parser de HTML a Markdown?
Una API de parser de HTML a Markdown obtiene una página web pública y devuelve Markdown legible en lugar de marcado en bruto. El Markdown puede preservar una estructura útil como encabezados, párrafos, listas, enlaces y flujo de secciones, mientras elimina gran parte del ruido de diseño que hace que el HTML en bruto sea difícil de consumir para editores, agentes, sistemas de búsqueda y pipelines de contenido.
El paso de captura sigue siendo importante. Si el contenido útil de la página está presente en el HTML fuente, la solicitud puede mantenerse ligera. Si un sitio construye el contenido en el navegador, el flujo de trabajo puede necesitar HTML renderizado antes de la conversión a Markdown. ScraperFly mantiene esos controles en un solo camino de solicitud para que los equipos puedan elegir el perfil más simple que devuelva contenido completo.
¿Cuándo es mejor Markdown que HTML en bruto?
Markdown es una buena opción cuando los humanos o los flujos de trabajo de modelos de lenguaje necesitan leer la página. Es más fácil de inspeccionar que el marcado en bruto, menos desordenado que el HTML del navegador y más estructurado que el texto plano. Eso lo hace útil para la revisión editorial, la ingesta de bases de conocimiento, resúmenes de IA, indexación de búsqueda, monitoreo ligero y flujos de trabajo de documentación.
No es el mejor formato para cada trabajo. Si el parser necesita atributos exactos, relaciones DOM anidadas, selección de objetivos o geometría de tablas, el HTML en bruto o renderizado puede ser más seguro. Si el flujo de trabajo solo necesita prosa legible compacta, un texto limpio puede ser suficiente. El punto es elegir el formato de salida en función del consumidor en lugar de convertir cada raspado en la misma forma.
| Formato de salida | Mejor adaptado a | Principal ventaja | Compensación |
|---|---|---|---|
| Markdown | Ingesta de IA, RAG, docs, revisión editorial, archivos legibles. | Preserva encabezados, listas, enlaces y flujo de secciones legibles. | Menos preciso que HTML para análisis específicos del DOM. |
| HTML en bruto | Selectores, atributos, descubrimiento de enlaces, extracción estructurada. | Preserva el marcado fuente y las relaciones de página. | Requiere más limpieza antes de la revisión humana o de IA. |
| HTML renderizado | Páginas donde JavaScript crea el DOM útil. | Captura el marcado construido por el navegador antes de la conversión. | Más pesado que la captura fuente y debe usarse deliberadamente. |
| Texto | Búsqueda compacta, indexación y análisis de contenido simple. | Pequeño y fácil de procesar. | Elimina gran parte de la estructura que Markdown puede preservar. |
¿Cómo afecta la renderización a la calidad de Markdown?
La conversión a Markdown solo puede usar el contenido que fue capturado. Si una página pública envía contenido completo de artículo o producto en la respuesta HTML inicial, la renderización puede no mejorar el Markdown. Si la página envía un shell de JavaScript y llena el contenido útil después de la hidratación, la conversión a Markdown debe ocurrir después de la ejecución del navegador.
El mejor flujo de trabajo compara muestras antes de escalar. Comienza con la captura fuente, inspecciona el Markdown, luego prueba la salida renderizada cuando faltan secciones importantes. Si el contenido que se carga tarde es importante, puede ser necesario un ajuste de espera. Si el resultado cambia por sesión, encabezado o país, esos controles deben añadirse porque el comportamiento objetivo demuestra que importan, no porque cada solicitud de Markdown deba ser pesada por defecto.
Para páginas construidas por el navegador, la API de renderización de JavaScript explica cuándo vale la pena habilitar la renderización. Para elegir entre HTML, texto, Markdown, JSON, capturas de pantalla y PDFs, utiliza la guía de formatos de respuesta.
¿Qué deben validar los equipos antes de usar Markdown en IA o RAG?
Markdown es útil para flujos de trabajo de IA porque puede preservar una estructura legible sin exponer un modelo o pipeline de ingesta a un marcado ruidoso. Aún así, los equipos deben validar la salida antes de confiar en ella. Verifica si el contenido principal sobrevivió a la conversión, si los encabezados son significativos, si los enlaces siguen siendo útiles, si la navegación repetida se reduce y si las tablas o listas importantes no se aplastan en texto confuso.
Para RAG y búsqueda, la consistencia importa tanto como la legibilidad. Almacena suficiente evidencia de respuesta para explicar cada documento: URL objetivo, URL final, estado, tipo de contenido, tamaño de respuesta, configuración de renderizado y formato de salida seleccionado. Ese contexto ayuda a los equipos a depurar secciones faltantes, páginas obsoletas, variantes regionales y casos donde el mismo objetivo necesita HTML en lugar de Markdown.
| Chequeo de validación | Por qué importa | Acción práctica |
|---|---|---|
| Contenido principal | Los flujos de trabajo de IA y revisión necesitan el cuerpo real de la página, no solo la navegación. | Compara Markdown con muestras de página fuente o renderizada. |
| Estructura de encabezados | Encabezados útiles mejoran la segmentación, resúmenes y revisión humana. | Verifica que H1, H2 y el flujo de secciones sobrevivan a la conversión. |
| Enlaces | Los enlaces pueden preservar la cita, el descubrimiento y el contexto de seguimiento. | Confirma que los anclajes y URLs importantes sigan siendo visibles. |
| Tablas y listas | Estructuras complejas pueden volverse menos claras al ser convertidas. | Utiliza flujos de trabajo de HTML o JSON cuando la estructura exacta importa. |
| Metadatos de evidencia | Los equipos necesitan saber cómo se capturó la página. | Almacena estado, URL final, tamaño, configuración de renderizado y formato con el contenido. |
¿Dónde reduce ScraperFly el trabajo del convertidor?
Sin un flujo de trabajo alojado, los equipos a menudo obtienen HTML, operan trabajadores de navegador, limpian boilerplate, escriben lógica de conversión, manejan objetivos fallidos y luego construyen verificaciones separadas para la ingesta de IA o revisión editorial. Eso crea mucho código de pegamento alrededor de lo que debería ser una transferencia de contenido sencilla.
ScraperFly acorta ese camino. La misma solicitud de API puede capturar el objetivo, renderizar páginas de JavaScript cuando sea necesario, devolver Markdown y mantener salidas alternativas disponibles para casos donde Markdown no es suficiente. Los desarrolladores pueden probar un objetivo en el API Builder, comparar formas de respuesta y mover el perfil de solicitud a producción una vez que la salida esté probada.
¿Cómo se mantiene la conversión a Markdown consciente de los costos?
Markdown en sí no es la parte costosa. El peso de la solicitud crece cuando el flujo de trabajo agrega renderización de navegador, esperas más largas, sesiones, enrutamiento premium, capturas de pantalla, PDFs o reintentos repetidos. El patrón consciente de los costos es comenzar con la solicitud más ligera que pueda producir Markdown completo, luego agregar controles solo cuando el objetivo demuestre que mejoran el resultado.
Esto se adapta tanto a proyectos pequeños como a sistemas de producción. Los equipos pueden validar objetivos con créditos gratuitos, usar créditos de pago por uso para trabajos de conversión desiguales y mover cargas de trabajo recurrentes a créditos mensuales cuando el perfil de solicitud sea predecible. La página de precios explica cómo ese camino de compra mantiene las pruebas asequibles mientras deja espacio para escalar.










