






Flujo de trabajo de renderizado de Angular
Renderiza páginas de Angular cuando el DOM útil aparece después de que la aplicación se inicia
Los sitios web de Angular a menudo envían primero un pequeño contenedor de aplicación, luego construyen contenido de ruta, listados, filtros, tarjetas de productos, secciones de artículos o datos públicos independientes de la cuenta después de que se ejecuta JavaScript. Un parser que solo lee la primera respuesta HTML puede ver contenedores, marcadores de posición y scripts en lugar del contenido que tu flujo de trabajo necesita.
ScraperFly ofrece a los equipos una forma controlada de raspar páginas públicas de Angular: inspeccionar la respuesta en bruto, renderizar solo cuando el objetivo demuestra que necesita ejecución en el navegador, y luego devolver HTML renderizado, texto, Markdown, metadatos, capturas de pantalla o PDFs en una única ruta de solicitud.
¿Qué hace que las páginas de Angular sean diferentes para raspar?
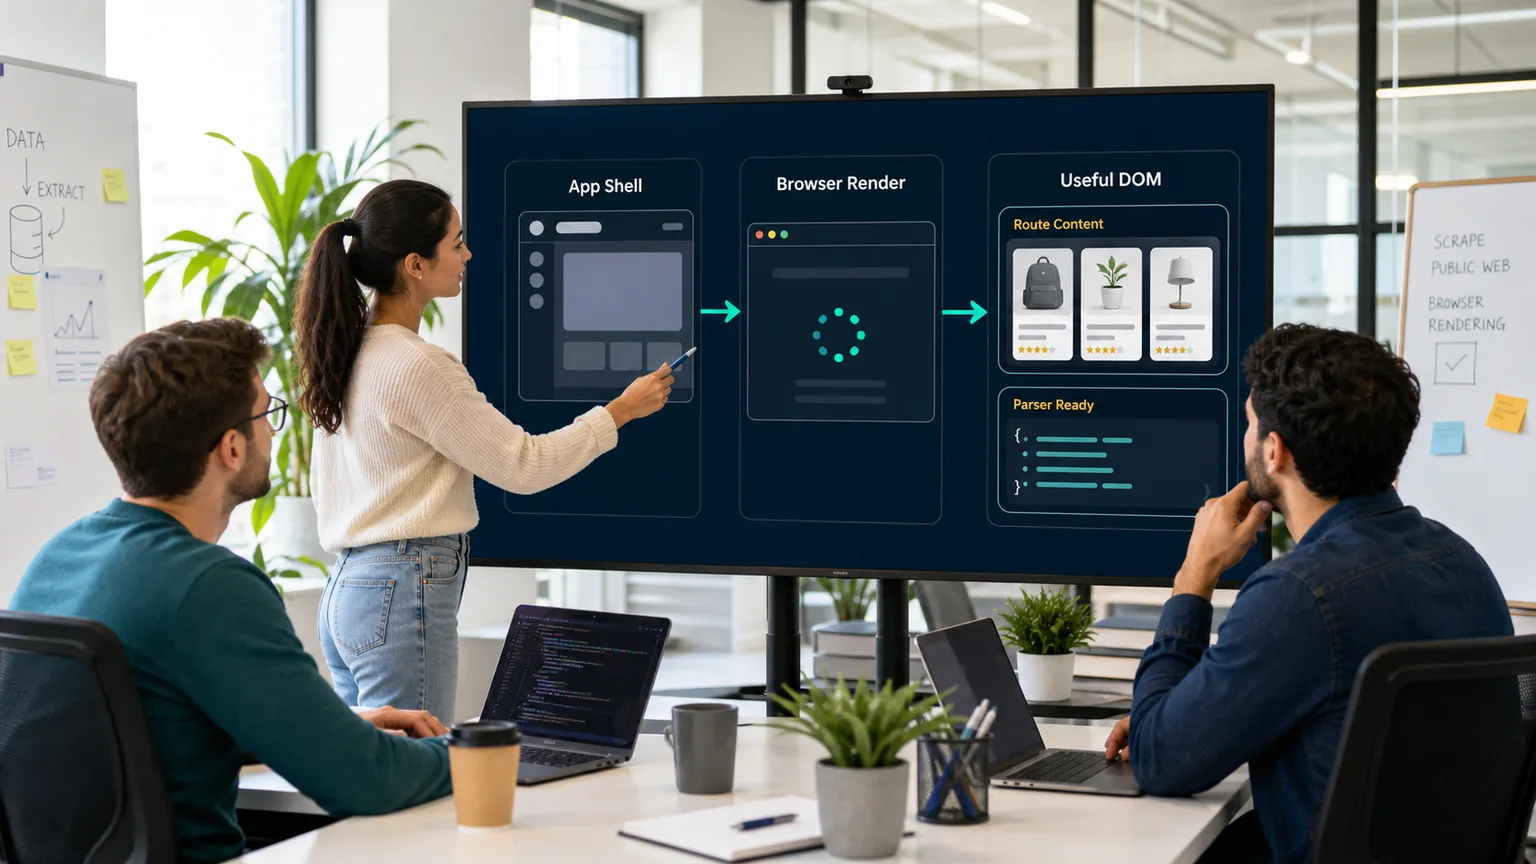
Una página de Angular puede no comportarse como un documento tradicional. La primera respuesta puede contener el contenedor raíz de la aplicación, paquetes de scripts, estilos y una cantidad limitada de marcado renderizado en el servidor. El contenido que un usuario ve puede aparecer solo después de que la aplicación de Angular se inicie, resuelva rutas, obtenga datos de API públicos, renderice componentes y actualice el DOM.
Eso no significa que cada página de Angular necesite un navegador. Algunos sitios de Angular utilizan renderizado del lado del servidor, contenido pre-renderizado, estado embebido o metadatos que ya le dan al parser lo que necesita. El flujo de trabajo correcto es probar el objetivo, comparar HTML en bruto con HTML renderizado y elegir la solicitud más ligera que devuelva contenido completo y utilizable.
Conclusión práctica: raspa páginas de Angular demostrando dónde aparece el contenido útil, no asumiendo que cada página de framework necesita la solicitud más pesada.
¿Cuándo debería el raspado de Angular usar renderizado en el navegador?
El renderizado en el navegador es útil cuando Angular cambia el resultado capturado. Eso generalmente significa que el HTML fuente es solo un contenedor de aplicación, el contenido de ruta aparece después de la navegación del lado del cliente, las tarjetas importantes se cargan después de llamadas a la API pública, o la página necesita una breve espera antes de que el DOM final esté listo. Renderizar le da a tu parser el marcado después de que esos pasos del lado del navegador se completen.
| Comportamiento de Angular | Lo que puedes ver en HTML en bruto | Mejor siguiente paso |
|---|---|---|
| Ruta renderizada por el cliente | Un elemento raíz de la aplicación, scripts y contenedores de ruta vacíos. | Usa HTML renderizado e inspecciona el DOM completado. |
| SSR o contenido pre-renderizado | Encabezados, enlaces, texto, tarjetas o estado embebido útiles ya presentes. | Mantén la solicitud ligera con HTML en bruto, texto o Markdown. |
| Datos de API pública retrasados | Marcadores de posición o estados de carga sin la lista final o detalles. | Usa renderizado con una espera medida en lugar de reintentos ciegos repetidos. |
| El estado de ruta o filtro importa | La URL se carga, pero la página visible cambia después de que la aplicación resuelve el estado. | Captura HTML renderizado y compara la URL final, el estado y el tamaño de la respuesta. |
| Se necesita prueba visual | El marcado solo no es suficiente para QA o revisión de archivo. | Usa HTML renderizado para el parsing y capturas de pantalla o PDFs solo para registros de prueba seleccionados. |
¿Qué formato de salida funciona mejor después de renderizar Angular?
HTML renderizado es la salida natural cuando un parser necesita selectores, atributos, enlaces, salida de componentes, tablas, tarjetas o estructura de DOM repetida. Pero el raspado de Angular no siempre tiene que terminar con HTML. Si el sistema de downstream necesita contenido legible, texto o Markdown pueden eliminar el ruido de diseño y reducir la limpieza. Si el trabajo es operativo, los metadatos JSON ayudan a explicar el estado, redirecciones, tipo de contenido, tiempo y tamaño de respuesta. Si el trabajo necesita revisión visual, capturas de pantalla y PDFs pueden preservar cómo se veía la página renderizada.
| Salida | Úsalo para | Valor específico de Angular |
|---|---|---|
| HTML renderizado | Parsers, selectores, tarjetas, tablas, enlaces, contenido de ruta y relaciones de DOM. | Captura el marcado después de que Angular construye la página. |
| Texto | Búsqueda, coincidencia, resumen y procesamiento de contenido compacto. | Ayuda cuando el diseño del componente crea demasiado ruido de marcado. |
| Markdown | IA, RAG, revisión de analistas, documentación y flujos de trabajo de contenido legible. | Mantiene encabezados y enlaces útiles después de renderizar sin exponer cada detalle del DOM. |
| Metadatos JSON | Depuración, registros, monitoreo y diagnóstico de captura. | Muestra si la solicitud renderizada alcanzó el estado final esperado. |
| Captura de pantalla o PDF | QA, archivo, aprobaciones y prueba visual. | Confirma lo que la página de Angular mostró en el momento de la captura. |
Para las compensaciones de salida más amplias, compara los formatos de respuesta de la API de raspado web. Para orientación de renderizado neutral al framework, utiliza la página de API de renderizado de JavaScript.
¿Cómo deberían los equipos probar una solicitud de raspado de Angular?
Usa URLs públicas representativas, no solo la página de inicio. Prueba una página de listado, página de detalles, ruta filtrada, estado de paginación y cualquier tipo de página pública que alimente el flujo de trabajo real. En el API Builder, compara HTML en bruto, HTML renderizado, texto, Markdown, tamaño de respuesta, URL final, estado y tipo de contenido. Esto muestra qué rutas necesitan ejecución en el navegador y cuáles pueden permanecer simples.
Cuando falta contenido, inspecciona la captura antes de cambiar la lógica del parser. La página puede necesitar una espera de renderizado, una URL de ruta pública diferente, contexto de idioma aceptado, enrutamiento por país, continuidad de sesión, o simplemente un alcance más pequeño. Trata esas como preguntas de perfil de solicitud primero, luego actualiza las reglas de extracción una vez que se haya probado la respuesta de la página.
Conclusión práctica: una configuración de raspado de Angular debe ser probada por tipo de ruta, porque una aplicación puede mezclar páginas estáticas, renderizadas en el servidor, retrasadas y completamente renderizadas por el cliente.
¿Cómo mantiene ScraperFly el raspado de Angular práctico?
El raspado de Angular puede volverse costoso cuando cada solicitud se trata como un trabajo completo del navegador con esperas adicionales, archivos visuales y enrutamiento más fuerte. ScraperFly apoya un camino más disciplinado. Comienza con la respuesta fuente, habilita el renderizado solo donde mejora la completitud, y luego elige el formato de salida más pequeño que tu flujo de trabajo de downstream pueda usar.
Esto mantiene las páginas de Angular simples asequibles mientras aún se les da a rutas más difíciles un camino de actualización limpio. Usa créditos de pago por uso mientras el comportamiento y volumen del objetivo aún se están probando, luego mueve el trabajo recurrente predecible a créditos mensuales cuando el patrón esté claro. La página de precios y el calculador de costos de crédito ayudan a mapear el peso de la solicitud a elecciones de captura reales.
¿Dónde encaja el raspado de Angular con otras páginas de framework?
La misma lógica basada en evidencia se aplica a través de frameworks frontend modernos, pero los detalles difieren según el enrutamiento, la estrategia de renderizado, la hidratación y el comportamiento de carga de datos. Si el proyecto incluye múltiples objetivos frontend, compara Angular con la API de raspado de React, API de raspado de Vue, y las guías de API de raspado de SPA.
ScraperFly mantiene la capa de captura consistente a través de esos objetivos. Tu aplicación puede probar cada página pública, elegir los controles necesarios y mantener la lógica de parsing específica del framework fuera de la infraestructura de solicitud.







