






ScraperFlyAPI веб-данных для AI

developer api

API парсера ссылок на веб-страницах для доказательства публичных страниц

ScraperFly помогает командам захватывать исходный код публичных страниц, рендеренные состояния, метаданные финальных URL и визуальные доказательства, чтобы последующий код мог проверять ссылки, навигацию, канонические ссылки, ссылки, пагинацию и контекст страницы с лучшими доказательствами.

Сначала доказательства ссылок

Запечатлите состояние публичной страницы, прежде чем ваш парсер ссылок решит, что следовать

Парсинг ссылок звучит просто, пока целевая страница не изменяет доказательства. Навигация может быть отрендерена на сервере или построена в браузере, канонические URL могут отличаться от запрашиваемого URL, пагинация может скрываться за JavaScript, а публичные страницы могут смешивать внутренние ссылки, внешние ссылки, медиа-ссылки, hreflang, подсказки для роботов и редиректы в одном ответе.

ScraperFly предоставляет командам надежный слой захвата для этих доказательств страницы. Получайте публичные страницы в виде сырого или отрендеренного HTML, сохраняйте метаданные ответа, сохраняйте визуальные доказательства, когда это необходимо для QA, и позволяйте вашему собственному парсеру решать, какие ссылки извлекать, нормализовать, обходить, оценивать или игнорировать.
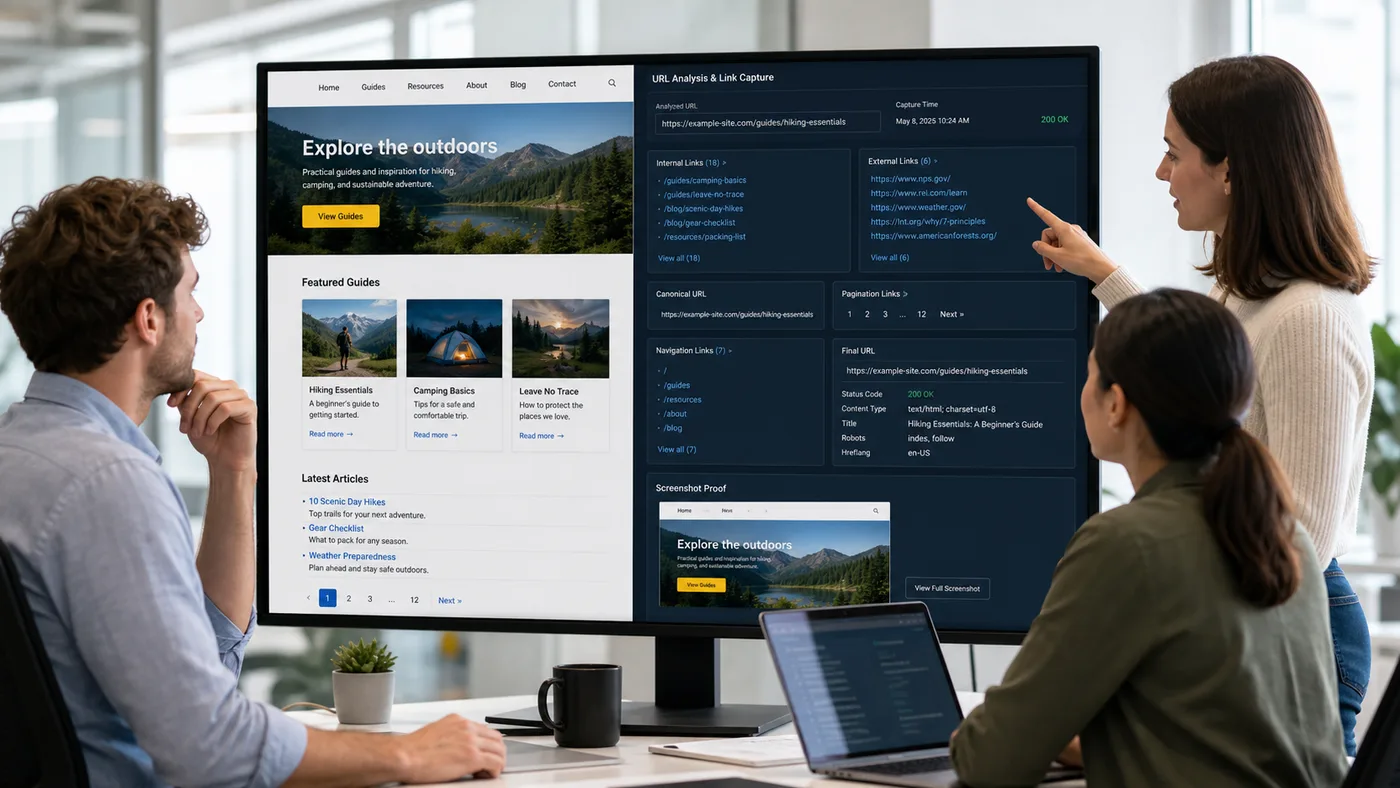
внутренние ссылки канонические пагинация финальный URL
Команда проверяет доказательства ссылок публичной веб-страницы и выводы парсера

Что такое API парсера ссылок веб-страницы?

API парсера ссылок веб-страницы — это рабочий процесс, который захватывает публичную страницу и возвращает достаточно исходных доказательств для последующего кода, чтобы проверить ссылки. Это может включать сырой HTML, отрендеренный HTML, метаданные финального URL, статус, тип контента, размер ответа, скриншоты, PDF и другой контекст, который помогает парсеру решить, что присутствует на странице.

Сам парсер остается вашей логикой продукта. ScraperFly не заменяет планирование обхода, оценку ссылок, SEO-аудит, нормализацию URL, дедупликацию, решения по картам сайта или бизнес-правила. Он предоставляет парсеру более чистый входной слой, чтобы эти решения основывались на том, что на самом деле вернула публичная страница.

Это намерение уже уже, чем общий API парсера веб-контента. Основное внимание уделяется доказательствам ссылок: якорям, навигации, каноническим ссылкам, пагинации, hreflang, внешним ссылкам и поведению финального URL, которые могут повлиять на обнаружение, QA, мониторинг или внутренние инструменты.

Практическое резюме: используйте ScraperFly для захвата страницы и контекста ответа, затем оставьте решения по извлечению и обходу в вашем собственном парсере ссылок.

Какие ссылки и сигналы URL должны проверять команды?

Полезный парсер ссылок не должен рассматривать каждую href как одинаково значимую. Навигационные ссылки, пагинация, канонические URL, альтернативы hreflang, внутренние контентные ссылки, внешние ссылки, медиа-ссылки, ссылки, созданные скриптами, и редиректированные финальные URL все несут разные сигналы. Захват их из правильного состояния страницы имеет значение.

Перед масштабированием определите, какие классы ссылок нужны вашему рабочему процессу. Инструмент SEO QA может заботиться о канонических ссылках, hreflang, редиректах и обходной навигации. Конвейер обнаружения контента может заботиться о ссылках на статьи и пагинации. Рабочий процесс мониторинга может заботиться о том, исчезла ли ключевая публичная ссылка с отрендеренной страницы.

СигналПочему это важноЛучшие доказательства захватаРешение на downstream
Внутренние ссылкиОткрывают навигацию, пути обнаружения, связанный контент и структуру сайтаHTML или отрендеренный HTMLИзвлечь, нормализовать, дедуплицировать или поставить в очередь
Внешние ссылкиПоказывают ссылки, цитаты, партнеров, встраивания и внешние зависимостиHTML плюс метаданные финального URLКлассифицировать, проверять или мониторить
Канонический URLМожет отличаться от запрашиваемого URL и влиять на обработку дубликатовHTML head и метаданные ответаНормализовать записи и избегать дублирующихся страниц
Пагинационные ссылкиКонтролируют, может ли рабочий процесс обнаружить следующие страницы результатовHTML, отрендеренный HTML, доказательства скриншотовТщательно строить область обхода
Hreflang и региональные ссылкиВыявляют языковые или региональные альтернативыHTML head, финальный URL, образцы с учетом страныКартировать охват локали или региональные варианты
Редирект и финальный URLПоказывают реальное назначение после применения целевого поведенияJSON метаданные и доказательства статусаОтладка маршрутизации, канонизации и качества ссылок

Самые сильные рабочие процессы ссылок хранят как список ссылок, так и контекст захвата. Когда парсер выдает неожиданный результат, статус, финальный URL, тип контента, размер ответа, исходный HTML и отрендеренное состояние помогают объяснить, есть ли проблема на странице, в профиле запроса или в правиле извлечения.

Когда парсинг ссылок должен использовать отрендеренный HTML?

Многие публичные страницы все еще показывают полезные ссылки в исходном HTML. В таких случаях сырой HTML является самым быстрым и практичным форматом захвата. Но некоторые сайты строят навигацию, продуктовые сетки, бесконечный скроллинг, связанные ссылки или пагинацию только после выполнения JavaScript на стороне браузера. Парсер, который видит только исходный HTML, может пропустить эти ссылки или ошибочно принять заполнители за реальные доказательства страницы.

Используйте JavaScript рендеринг, когда полезный набор ссылок появляется только в состоянии страницы, построенной браузером. Сравните сырые и отрендеренные ответы, прежде чем переходить к более тяжелому профилю запроса. Если рендеринг не изменяет ссылки, которые нужны вашему парсеру, оставьте запрос легким.

Визуальный вывод также может помочь. Скриншоты или PDF не являются лучшим источником для машинного извлечения, но они полезны, когда QA нужно доказать, что область навигации, контроль пагинации, модуль ссылок или состояние страницы появились в момент захвата.

Практическое резюме: рендерите только тогда, когда выполнение в браузере изменяет доказательства ссылок, от которых зависит ваш парсер.

Как ScraperFly поддерживает SEO QA и планирование обхода?

ScraperFly может поддерживать SEO QA, захватывая публичные исходные страницы, которые проверяют инструменты downstream. API может предоставить HTML для извлечения ссылок, метаданные для проверки статуса и финального URL, отрендеренный вывод для навигации, построенной на JavaScript, и скриншоты для обзора. Ваш собственный рабочий процесс по-прежнему отвечает за правила обхода, оценку, отчетность, приоритизацию проблем и логику исправления.

Эта граница сохраняет страницу честной и полезной. Парсер ссылок может использовать ScraperFly для сбора надежных образцов, а затем классифицировать ссылки по типу, глубине, назначению, шаблону, языку или источнику. Рабочий процесс мониторинга может сравнивать, остаются ли важные ссылки присутствующими. Инструмент QA может сохранить доказательства скриншотов, когда публичная страница изменяется.

Используйте API Builder, чтобы протестировать представительный URL, сравнить сырой и отрендеренный HTML, проверить метаданные и решить, нужны ли парсеру ссылок простой HTML, рендеринг, заголовки, сессии, маршрутизация по странам или визуальные файлы перед масштабированием цели.

Как парсинг ссылок может оставаться предсказуемым и доступным?

Извлечение ссылок может стать дорогим, когда каждая страница рассматривается как сложное отрендеренное приложение. Большинство команд должны начинать с простого захвата HTML, доказать, какие ссылки присутствуют, а затем добавлять более тяжелые контролы только тогда, когда доказательства ответа показывают, что они улучшают набор ссылок или отладочную ценность.

РешениеХороший стандартЭскалировать, когда
Формат захватаСырой HTML для извлечения якорейОтрендеренный HTML изменяет навигацию, пагинацию или модули ссылок
МетаданныеСохраняйте статус, финальный URL, тип контента и размерОтладка редиректов, канонических ссылок или непоследовательных образцов
Визуальные доказательстваПропустите для машинного извлечения ссылокQA нужны доказательства того, что область ссылки появилась визуально
Контроль маршрутизацииСначала используйте стандартный путьМестоположение, язык, доступ или редиректы изменяют публичные ссылки страницы
Модель стоимостиИспользуйте бесплатные кредиты и оплату по мере использования во время тестированияПереместите регулярный мониторинг ссылок на ежемесячные кредиты, когда объем известен

Гибкая модель выставления счетов ScraperFly полезна здесь, потому что парсинг ссылок часто начинается как исследовательский проект. Протестируйте несколько шаблонов, оставьте простые страницы легкими, добавьте рендеринг или визуальные доказательства только там, где это имеет значение, и используйте страницу Цены, чтобы оценить вес запроса перед началом регулярного мониторинга.


Практическое резюме: парсинг ссылок лучше всего масштабируется, когда каждый контроль запроса связан с сигналом ссылки, который парсер действительно нуждается.

Рабочий процесс парсера ссылок

Постройте запрос захвата, прежде чем доверять списку ссылок

Используйте API Builder для тестирования представительных публичных страниц, сравнения сырого и отрендеренного HTML, проверки метаданных финального URL и выбора формы ответа, которую ваш парсер ссылок, инструмент SEO QA или рабочий процесс мониторинга могут использовать немедленно.

01
01

Захватите якоря и структуру страницы

Используйте HTML, когда вашему парсеру нужны href, навигация, канонические ссылки, пагинация, hreflang или контекст DOM.

02
02

Рендерьте ссылки, созданные браузером

Включите рендеринг, когда публичные ссылки, карточки или навигация появляются только после выполнения JavaScript на фронтенде.

03
03

Отладка поведения финального URL

Используйте метаданные ответа для сравнения запрашиваемого URL, финального URL, статуса, типа контента, редиректов и размера ответа.

Полезные управляющие элементы запроса парсера ссылок

url

Целевая страница для получения, рендеринга, очистки или захвата.

format

Выберите ответ, который нужен вашему продукту: html, text, markdown, json, скриншот или pdf.

premium

Эскалируйте на более сильные маршруты для блокировок, нестабильных целей или контента, чувствительного к геолокации.

render

Запустите Chromium для SPA, JS-вставленного разметки, скриншотов, PDF и страниц только для браузера.

country

Запросите маршрут, специфичный для страны, когда контент меняется в зависимости от местоположения.

keep_headers

Перенаправьте выбранный контекст запроса, такой как user-agent, cookie, язык и referer.

render_wait

Дайте динамическому контенту контролируемую дополнительную задержку перед извлечением или захватом.

download

Возвращайте визуальные артефакты в виде загружаемых файлов, когда вывод - это скриншот или PDF.

пример cURL

Генерируйте Markdown с той же формой запроса, которую вы можете использовать в производстве

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Планирование целевых ссылок

Картируйте шаблон страницы перед масштабированием извлечения ссылок

Домашняя страница, страница категории, страница поиска, статья, страница документации и пагинированный индекс могут раскрывать очень разные сигналы ссылок. Проверьте, присутствуют ли ссылки в исходном HTML, изменяет ли рендеринг набор, важны ли канонические ссылки или hreflang, и нужны ли визуальные доказательства для QA.

Сырой HTML-ответ, сопоставленный с видимыми данными страницы
01

Доступность сырого HTML

Проверьте, присутствуют ли необходимые вам поля уже в первом HTML-ответе.

Лучший первый тест для простых страниц, статей, документов, списков и деталей продуктов.

Сравнение до и после рендеринга JavaScript
02

Зависимость от JavaScript

Сравните сырой HTML с отрендеренным DOM или скриншотом перед включением рендеринга браузера.

Используйте рендеринг, когда сырой HTML является лишь оболочкой, а скрипты создают полезный контент.

Cookies, согласие, контекст сессии и доступа для скрапинга
03

Состояние и контекст доступа

Определите, влияют ли cookies, согласие, границы входа, пагинация или состояние одного и того же посетителя на ответ.

Используйте сессии и заголовки, когда непрерывность изменяет данные, которые вы получаете.

Региональные вариации контента по странам и маршрутам
04

Гео/вариация контента

Проверьте, изменяет ли страна, язык, валюта, запасы, SERP, реклама или репутация маршрута результат.

Используйте гео- или премиум-маршрутизацию только тогда, когда цель подтверждает, что ответ варьируется в зависимости от маршрута.

Вопросы перед извлечением ссылок в масштабе

Где находится целевое поле?

Узнайте, существует ли поле в сыром HTML, отрендеренном DOM, вызове API, структурированных данных, файле или состоянии взаимодействия позже.

Что изменяет ответ?

Выберите несколько URL-адресов и сравните статус, конечный URL, длину контента, перенаправления, пустые состояния и различия в видимых результатах.

Какой контекст необходим?

Отметьте любую зависимость от согласия, локали, файлов cookie, заголовков, границ аутентификации, пагинации, фильтров или предыдущих запросов.

Как выглядит неудача?

Определите сигналы для заблокированных, частичных, устаревших, перенаправленных, пустых, истекших или несоответствующих регионам ответов перед масштабированием.

Настройка парсера ссылок

Режим получения

Доступность сырого HTML определяет, может ли первый запрос оставаться простым или требует рендеринга, ожиданий, скриншотов или извлечения.

Контекст запроса

Требования состояния определяют, нужно ли добавлять заголовки, файлы cookie, сессии, обработку согласия или стабильный профиль посетителя.

Выбор маршрута

Гео и репутационные данные определяют, достаточно ли стандартного маршрута или оправдан ли маршрут по стране/премиум.

Правила валидации

Известные состояния неудачи становятся проверками для повторных попыток, эскалации, проверки качества и решения о том, когда более легкий профиль все еще полный.

Лучшие доказательства ссылок.

Выбирайте ScraperFly, когда извлечение ссылок требует доказательства источника, а не догадок краулера.

ScraperFly помогает командам сначала протестировать реальную публичную страницу, сознательно выбрать необработанный или отрендеренный HTML, сохранить метаданные для отладки и связать стоимость запросов с контролями, которые действительно улучшают доказательства ссылок.

Счастливая команда, проверяющая проект на ноутбуке
01 / Начните легко

Легкий, бесплатный старт перед любым давлением по оплате

ScraperFly дает вам возможность сначала протестировать реальную цель. Используйте бесплатные кредиты, чтобы проверить, работает ли страница, присутствуют ли данные и какие элементы управления действительно нужны, прежде чем вы потратите деньги на план. Это делает первый эксперимент легким: никаких закупочных циклов, никакой принудительной подписки, никаких предположений о вашем месячном объеме в первый день.

Бесплатные кредитыНет карты для первых тестовПроверяйте перед масштабированием
Улыбающийся профессионал, успешно работающий с ноутбуком
02 / Тратьте разумно

Доступная, гибкая оплата за реальный объем скрапинга

Не каждая нагрузка для скрапинга представляет собой аккуратную месячную кривую. Некоторые проекты резко возрастают, некоторые приостанавливаются, а некоторые становятся регулярными только после того, как данные докажут свою ценность. ScraperFly поддерживает эту реальность с помощью модели оплаты по мере использования и ежемесячных кредитных планов, когда стабильный объем имеет смысл. Вы можете купить то, что вам нужно, держать расходы под контролем и избежать превращения небольшого теста в чрезмерную подписку.

Оплата по мере использованияЕжемесячно, когда это полезноКонтроль затрат
Разработчик, подготавливающий структурированный вывод с ноутбука
03 / Доставка быстрее

Предварительная обработка ответа, которая убирает работу по очистке

Дешевый запрос недостаточен, если вашей команде все еще нужно создавать конвертеры, очистители, скриншоты, захват PDF и форматирование, готовое для LLM. ScraperFly может вернуть ответ в формате HTML, чистого текста, Markdown, структурированного JSON, PDF или изображения, так что ваш конвейер приближается к конечному активу за один запрос. Меньше кода склеивания, меньше движущихся частей, более быстрая доставка.

HTMLТекстMarkdownJSONPDFИзображение

Где ScraperFly помогает командам парсинга ссылок.

Сравните варианты запросов по необработанному HTML, отрендеренной навигации, доказательствам конечного URL, визуальному QA и контролю затрат перед масштабированием регулярного мониторинга ссылок.

Точка принятия решенияПреимущество ScraperFlyТипичный компромисс конкурента
Первый экспериментНачните с бесплатных кредитов и проверьте реальную цель перед расходами. Вы можете доказать, нужны ли на самом деле сырой HTML, рендеринг, премиум маршрутизация или таргетинг по странам.Тестовые версии часто быстро подталкивают вас к подписке или скрывают истинную стоимость, пока дополнительные функции не войдут в запрос.
Модель биллингаИспользуйте кредиты по мере необходимости для нерегулярной работы, затем переходите на ежемесячные кредиты только тогда, когда объем работы станет предсказуемым. Это делает небольшие тесты и проектный скрапинг доступными.Многие инструменты оптимизированы под ежемесячные подписки, фиксированные лимиты или уровни, которые могут казаться тяжелыми, прежде чем объем будет доказан.
Вес запросаДержите простые страницы простыми. Включайте рендеринг JavaScript, премиум маршрутизацию, сессии, заголовки, ожидания или маршрутизацию по странам только тогда, когда доказательства ответа говорят, что это важно.Сравнимые элементы управления могут существовать, но они часто объединены в более высокие уровни, по умолчанию или более сложные ценовые профили.
Форматы выводаВозвращайте ответ в формате, который нужен вашему продукту: HTML для парсеров, текст или Markdown для контентных потоков, JSON для структурированных метаданных и PDF/изображение для визуального доказательства.Некоторые провайдеры сосредотачиваются в основном на доступе и оставляют форматирование, захват, очистку и подготовку на вашем собственном коде.
Рабочий процесс разработчикаОдна API поверхность может охватывать тестирование целей, эскалацию, рендеринг, маршрутизацию, сессии, заголовки, форматирование ответов и проверки статуса. Путь от прототипа до производства остается компактным.Инструменты с приоритетом прокси, рынки актеров и платформы для краулеров могут быть мощными, но часто требуют больше связующего кода или более тяжелой операционной модели.
Лучшее соответствиеКоманды, которые хотят практической доставки веб-данных: начните с малого, измеряйте стоимость за полезный результат и масштабируйте только те элементы управления, которые улучшают результат.Команды с фиксированными контрактами на большой объем, кастомной прокси-инфраструктурой или широкими потребностями в краулинге рынка могут предпочесть более специализированную платформу.

Контроль затрат

Сохраняйте парсинг ссылок доступным, сохраняя простые страницы простыми.

Многие рабочие процессы парсинга ссылок могут начинаться с необработанного HTML и метаданных. ScraperFly позволяет командам тестировать публичные страницы с бесплатными кредитами, использовать оплату по мере использования, пока поведение источника нестабильно, и добавлять рендеринг, визуальные файлы или более сильную маршрутизацию только тогда, когда эти контролы улучшают захваченные доказательства ссылок.

Легкий HTML-запрос, возвращающий простой ответ
01

Базовый запрос

Используйте базовый запрос, когда публичный HTML уже содержит необходимые вам поля.

Самый легкий профиль запроса; сохраняйте его, когда ответ завершен.

Рендеринг JavaScript, создающий полный DOM
02

Рендеринг

Используйте рендеринг, когда сырой HTML является оболочкой, а JavaScript завершает страницу.

Более тяжелый профиль; используйте его только когда вывод браузера изменяет результат.

Несколько запросов с сохранением cookies и состояния посетителя
03

Состояние сессии

Используйте сессии, когда cookies, согласие, локализация или пагинация изменяют ответ.

Более тяжелый профиль состояния; сохраняйте его только когда важна непрерывность.

Маршрутизация запросов через гео и более качественные маршруты
04

Премиум маршрутизация и гео

Используйте премиум маршрутизацию или гео только когда источник, страна, репутация или региональный контент изменяют результат.

Самый тяжелый профиль маршрутизации; применяйте его только к целям, которые доказывают, что они в этом нуждаются.

Факторы стоимости парсинга ссылок.

Больше инфраструктурной работы

Рендеринг в браузере, выбор маршрутов и более длительное ожидание означают, что платформе нужно делать больше, чем просто возвращать простой ответ.

Больше неопределенности цели

Перенаправления, пустые состояния, ограничения по скорости и страницы с вызовами часто требуют более сильных вариантов доставки или повторных попыток.

Больше состояния для сохранения

Cookies, сессии, согласие и многостраничные потоки добавляют движущиеся части, которых нет у простого безстатусного запроса.

Больше доказательств для возврата

Скриншоты, PDF-файлы, отрендеренный вывод и более богатые артефакты ответа полезны, но они тяжелее, чем простой HTML.

Контроль, который должен заслужить свое место

Протестируйте перед масштабированием

Сначала протестируйте небольшой набор URL и группируйте цели по самому легкому профилю, который возвращает полные данные.

Не рендерить по умолчанию

Проверьте сырой HTML перед включением рендеринга. Многие публичные страницы уже содержат необходимые вам данные.

Эскалируйте по фактам

Переходите на более высокий уровень только когда ответ показывает отсутствие контента, зависимость состояния, гео-вариации или проблемы с маршрутизацией.

Измеряйте полезные результаты

Оптимизируйте на основе действительных записей, а не объема сырых запросов. Более легкий профиль лучше всего, только когда он остается полным.

Часто задаваемые вопросы парсера ссылок

Распространенные вопросы о парсинге ссылок веб-страниц с помощью ScraperFly.

Практические ответы для команд, захватывающих доказательства публичной страницы для последующего извлечения ссылок, SEO QA, обнаружения, мониторинга и планирования обхода.

Быстрые ответы

Сравнение захвата и обхода

Где ScraperFly вписывается в рабочий процесс ссылок.

ScraperFly автоматически извлекает каждую ссылку?

ScraperFly захватывает публичную страницу и контекст ответа. Ваш парсер управляет правилами извлечения, нормализацией, дедупликацией, очередями обхода и оценкой.

Может ли он заменить SEO-обходчик?

Нет. ScraperFly может предоставить исходные данные для последующих SEO проверок, в то время как планирование обхода, оценка, отчетность и приоритизация остаются в вашей системе.

Ссылки и контекст URL

Знайте, какие сигналы URL важны.

Какие ссылки мне следует проверить?

Общие сигналы включают внутренние ссылки, внешние ссылки, навигацию, пагинацию, канонический URL, альтернативы hreflang, медиа-ссылки и поведение конечного URL.

Почему стоит сохранять метаданные конечного URL?

Конечный URL, статус, тип контента и размер ответа помогают отладить редиректы, канонизацию, поведение доступа и непоследовательные образцы.

Ссылки JavaScript

Используйте выполнение в браузере, когда ссылки созданы браузером.

Когда мне следует рендерить перед парсингом ссылок?

Рендерите, когда публичные ссылки, навигация, пагинация, карточки или связанные модули появляются только после выполнения фронтенд JavaScript.

Должен ли каждый запрос парсера ссылок рендериться?

Нет. Начните с сырого HTML и выполняйте рендеринг только тогда, когда доказательства ссылки изменяются в состоянии страницы, созданной браузером.

Отладка и доказательства

Сохраняйте доказательства, полезные как для людей, так и для машин.

Полезны ли скриншоты для парсинга ссылок?

Они полезны для QA и доказательства видимой навигации или пагинации, но HTML остается лучшим источником для машинного извлечения.

Как мне сохранить предсказуемость затрат?

Сначала используйте сырой HTML и метаданные, затем добавляйте рендеринг, визуальные файлы или более сильную маршрутизацию только тогда, когда цель докажет, что они улучшают доказательства ссылки.








