






ВИХІД У MARKDOWN
Перетворіть публічні сторінки на Markdown, який ваша система може дійсно прочитати
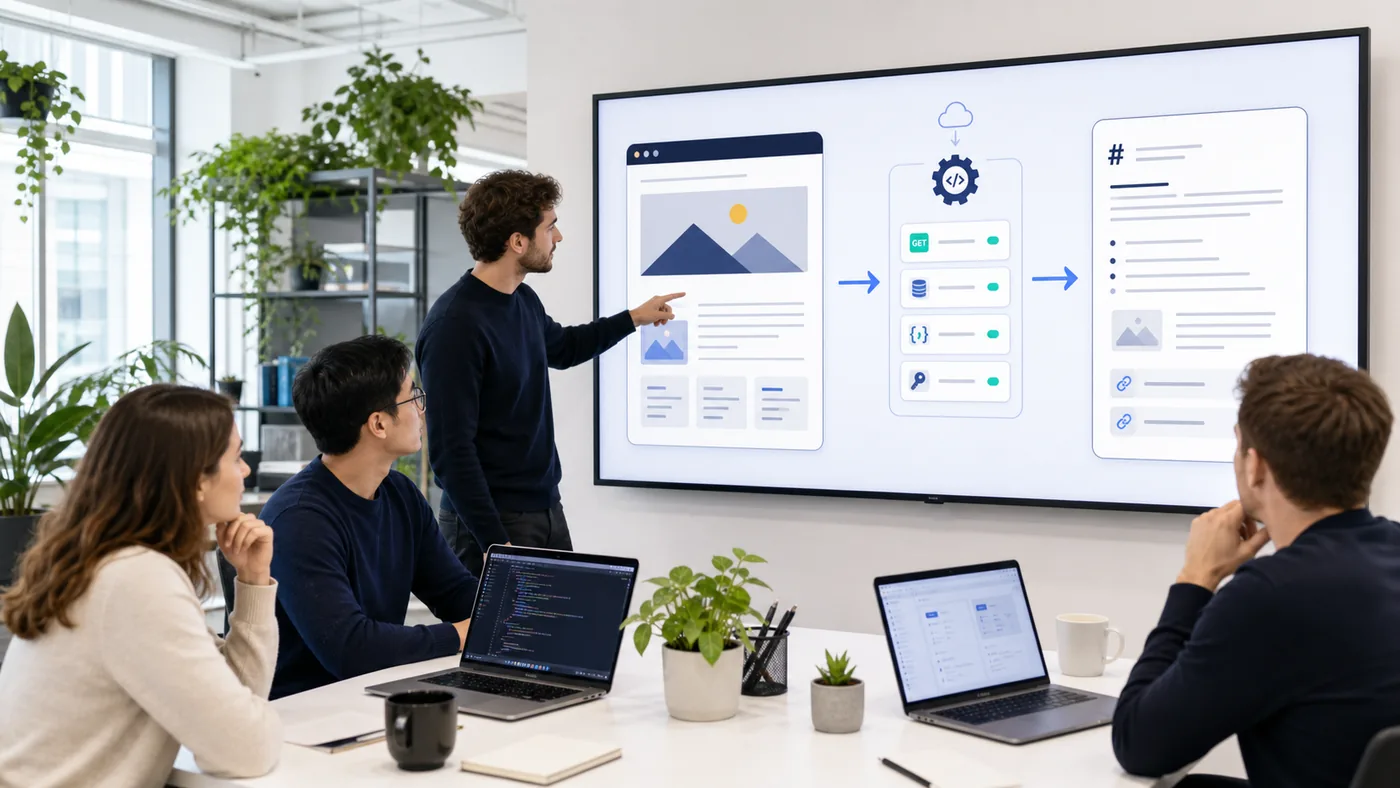
ScraperFly надає командам практичний шлях від публічної URL-адреси до чистого Markdown. Замість того, щоб надсилати сирий HTML-код сторінки в запит AI, інструмент документації, чергу перевірки контенту або пошуковий індекс, ваша програма може запитати відповідь, яка зберігає корисні заголовки, абзаци, списки та посилання у читабельному вигляді.
Важлива частина - це контроль. Почніть з легкого запиту, перевірте, що повертає ціль, а потім увімкніть рендеринг браузера, затримки, сесії, заголовки, націлювання на країну або більш сильну маршрутизацію лише тоді, коли ці контролі покращують Markdown, який отримує ваш робочий процес.
Що таке API для перетворення веб-сторінки на Markdown?
API для перетворення веб-сторінки на Markdown отримує публічну URL-адресу та повертає захоплений вміст сторінки у вигляді Markdown. Відповідь призначена для систем, які потребують читабельного контенту, а не інфраструктури браузера: споживання RAG, AI-агенти, внутрішній пошук, редакційний огляд, імпорт документації, нотатки моніторингу та легкий аналіз контенту.
Markdown корисний, оскільки він знаходиться між сирим HTML та простим текстом. Він може зберігати заголовки, потік абзаців, списки та посилання, не змушуючи кожного споживача розуміти вкладення DOM, повторну навігацію, атрибути, скрипти, стилі або шум шаблону.
Це не те ж саме, що обіцяти ідеальне вилучення статей або вилучення за кастомною схемою. Відповідь у Markdown повинна розглядатися як чистий формат контенту. Якщо ваш продукт потребує точних полів продукту, підписів, дат, цін, рейтингів або структури на рівні селектора, перевірте ці поля окремо або зберігайте HTML та метадані доступними для парсера.
Практичний висновок: використовуйте перетворення з веб-сторінки на Markdown, коли споживачеві потрібен читабельний вміст сторінки, а не точні докази DOM.
Коли команди повинні використовувати Markdown замість HTML або тексту?
Markdown найсильніший, коли вміст сторінки буде прочитано, розділено на частини, підсумовано, переглянуто, проіндексовано або передано в робочий процес мовної моделі. Він надає приймаючій системі більше структури, ніж простий текст, але менше шуму, ніж сирий HTML.
HTML все ще краще підходить, коли важливі селектори, атрибути, вкладені таблиці, точні посилання або відносини DOM. Простий текст краще, коли робочий процес потребує лише компактного читабельного тексту. JSON-метадані допомагають з діагностикою запитів. Знімки екрана та PDF-документи допомагають, коли візуальний стан є доказом.
| Робочий процес | Чому Markdown допомагає | Коли інший формат кращий |
|---|---|---|
| Споживання RAG та AI | Зберігає заголовки, списки, посилання та читабельні секції для чистішого розділення. | Використовуйте HTML, коли вилучення залежить від селекторів або прихованих атрибутів. |
| Редакційний огляд | Полегшує людям перегляд та анотування вмісту публічної сторінки. | Використовуйте знімок екрана або PDF, коли важливі макет та візуальне підтвердження. |
| Імпорт документації | Переміщує секції сторінки в формат, який інструменти документації можуть обробляти природно. | Використовуйте текст, коли потрібен лише простий текст. |
| Індексація пошуку | Зберігає корисну структуру без додавання HTML-шуму до індексу. | Використовуйте JSON-метадані для відстеження фінальної URL-адреси, статусу, типу контенту та контексту запиту. |
| Нотатки моніторингу | Фіксує читабельні зміни на сторінці без зберігання повного рендереного артефакту щоразу. | Використовуйте знімки екрана для візуальних регресій, зламаних макетів або доказів затвердження. |
Практичний висновок: вибирайте Markdown, коли структура допомагає читачеві або моделі, і зберігайте HTML або візуальні формати, коли доказ має бути точним.
Як рендеринг змінює вихід Markdown?
Конвертер Markdown може працювати лише з вмістом, який захоплює запит. Багато публічних сторінок надсилають корисний вміст у першій HTML-відповіді. Ці сторінки повинні залишатися простими: отримайте URL, запитайте Markdown і уникайте виконання браузера, якщо вихід не доводить, що чогось не вистачає.
Інші сторінки надсилають тонку HTML-оболонку та створюють корисний вміст після виконання JavaScript. У цьому випадку рендеринг JavaScript може захопити стан рендереної сторінки перед перетворенням відповіді на Markdown. Це робить Markdown більш повним, але також робить запит важчим, тому рендеринг повинен бути рішенням на основі доказів.
Корисні докази включають вихідний HTML, рендерений HTML, фінальну URL-адресу, розмір відповіді, код статусу, стан знімка екрана та кілька репрезентативних зразків цільової сторінки. Якщо Markdown вже повний з вихідного захоплення, зберігайте профіль легким. Якщо важливі секції з'являються лише після виконання браузера, рендерте цей шаблон URL навмисно.
Практичний висновок: рендерте для повноти Markdown, а не тому, що рендеринг доступний.
Чим перетворення з веб-сторінки на Markdown відрізняється від парсера HTML на Markdown?
Фраза API парсера HTML на Markdown зазвичай починається з захопленого HTML і зосереджується на перетворенні. API для перетворення веб-сторінки на Markdown починає раніше в робочому процесі: він приймає публічну URL-адресу, отримує сторінку, обробляє контролі запиту, а потім повертає Markdown як обраний формат відповіді.
Ця різниця важлива в продуктивності. Захоплення сторінки може включати перенаправлення, заголовки, куки, сесії, націлювання на країну, час очікування, маршрутизацію через проксі, рендеринг JavaScript, перевірки типу контенту та обмеження розміру відповіді. Конвертер сам по собі не вирішує ці питання доставки. ScraperFly дозволяє тій же моделі запиту переходити від простого захоплення джерела до більш повного стану сторінки, коли ціль доводить, що це потрібно.
Якщо ваша команда вже має надійний HTML і потребує лише перетворення, робочий процес, зосереджений на парсері, може бути достатнім. Якщо проблема починається з доставки публічної URL-адреси і продовжується в читабельний контент, перетворення з веб-сторінки на Markdown є більш повною ментальною моделлю.
Що команди повинні перевірити перед масштабуванням захоплення Markdown?
Добре вихідне Markdown - це не лише питання форматування. Це залежить від цільової сторінки, стану відповіді, вмісту, який ваша система нижнього рівня очікує, та кількості шуму, який сторінка додає навколо корисних секцій.
- Фінальна URL-адреса та статус. Перенаправлення, м'які помилки, сторінки згоди або сторінки викликів можуть створити читабельний Markdown, який все ще є неправильним вмістом.
- Вихідний проти рендереного вмісту. Порівняйте сире захоплення з рендереним захопленням перед тим, як зробити виконання браузера за замовчуванням.
- Структура заголовків. Перевірте, чи заголовки відображають корисний вміст або в основному повторюють навігацію та секції шаблону.
- Посилання та списки. Переконайтеся, що важливі посилання, елементи списку та межі секцій зберігаються під час перетворення в формі, яку ваша програма може використовувати.
- Повторюваний шаблон. Навігація, нижні колонтитули, банери згоди, рекомендації та реклама все ще можуть з'являтися в Markdown і повинні бути оброблені перед індексацією.
- Таблиці та складні макети. Markdown може спростити складні структури. Зберігайте HTML доступним, коли форма таблиці або точні відносини DOM мають значення.
Ці перевірки зберігають вихід чесним. Вони також запобігають тому, щоб команда сприймала Markdown як магічний шар очищення, коли справжня проблема полягає в доставці, рендерингу, виборі цілі або вимогах до вилучення нижнього рівня.
Як команди повинні вибирати між Markdown та іншими форматами ScraperFly?
Найбезпечніший підхід - це протестувати ту ж ціль через кілька форматів відповіді в API Builder. Використовуйте Markdown для читабельної структури, текст для компактного копіювання, HTML для контролю парсера, JSON-метадані для діагностики, знімки екрана для візуального QA та PDF для портативних записів.
| Формат | Найкраще підходить | Правило прийняття рішення |
|---|---|---|
| Markdown | AI, RAG, документи, огляд та робочі процеси читабельного контенту. | Використовуйте його, коли заголовки, посилання та потік секцій покращують досвід споживача. |
| HTML | Селектори, парсинг DOM, атрибути, таблиці та точні відносини джерела. | Використовуйте його, коли парсеру потрібна структурна точність. |
| Текст | Легкий пошук, підсумки та просте оброблення мови. | Використовуйте його, коли структура не є необхідною. |
| JSON-метадані | Логування, перевірки статусу, фінальна URL-адреса, тип контенту та діагностика запитів. | Використовуйте його поряд з форматами контенту, щоб спростити діагностику запиту. |
| Знімок екрана або PDF | Візуальне підтвердження, QA, архів, відповідність або людський огляд. | Використовуйте візуальні файли, коли зовнішній вигляд важливіший за текст, зручний для машин. |
Для більш широкого порівняння форматів перегляньте посібник з форматів відповіді API для веб-скрапінгу. Для робочих процесів, специфічних для AI, пов'яжіть рішення Markdown з сторінкою Scraping API для RAG та перевірте, чи потребує ваш контентний конвеєр Markdown, текст, HTML, метадані або їх комбінацію.
Практичний висновок: не стандартизуйте один формат занадто рано; протестуйте ціль і виберіть відповідь, яку ваш продукт може використовувати негайно.
Як ScraperFly може зберегти передбачуваність робочих процесів Markdown?
ScraperFly корисний, коли перетворення Markdown є частиною більшого робочого процесу з публічними веб-даними. API може зберігати прості сторінки легкими, додавати рендеринг, коли JavaScript створює корисний вміст, зберігати контекст запиту з заголовками та сесіями, маршрутизувати через специфічні для країни або більш сильні доставки, коли це необхідно, і повертати альтернативні формати, коли Markdown недостатньо.
Ця гнучкість важлива для витрат так само, як і для якості. Сторінка, яка чисто перетворюється з вихідного HTML, не повинна мати той же профіль запиту, що й рендерена сторінка, яка потребує затримок, безперервності сесії або візуального підтвердження. Пов'яжіть рішення виходу з вагою запиту та використовуйте цінову політику лише після того, як поведінка цілі стане зрозумілою.
Якщо мета полягає у вилученні контенту, а не у форматуванні Markdown, порівняйте цю сторінку з API парсера веб-контенту. Якщо мета полягає у створенні портативного артефакту, використовуйте сторінки PDF або знімків екрана. Найкращий робочий процес з веб-сторінки на Markdown є достатньо специфічним, щоб бути корисним, і достатньо гнучким, щоб уникнути непотрібної інфраструктури.



