






Готовий до парсингу захоплення
Перетворіть публічні сторінки на чисті дані, яким ваш парсер може довіряти
Парсинг вмісту веб-сайту починається ще до написання правил витягування. Вашій команді потрібно знати, що насправді повертає публічна сторінка, чи корисний вміст знаходиться в вихідному HTML або в рендереному виході, і який формат відповіді полегшить подальший парсинг замість того, щоб ускладнити його.
ScraperFly надає розробникам практичний шар захоплення для публічного вмісту веб-сайтів. Отримайте сторінку, перевірте відповідь, виберіть HTML, текст, Markdown, метадані, скріншоти або PDF-файли, і зберігайте логіку парсингу, класифікацію, збагачення та зберігання всередині вашого продукту, де належать бізнес-правила.
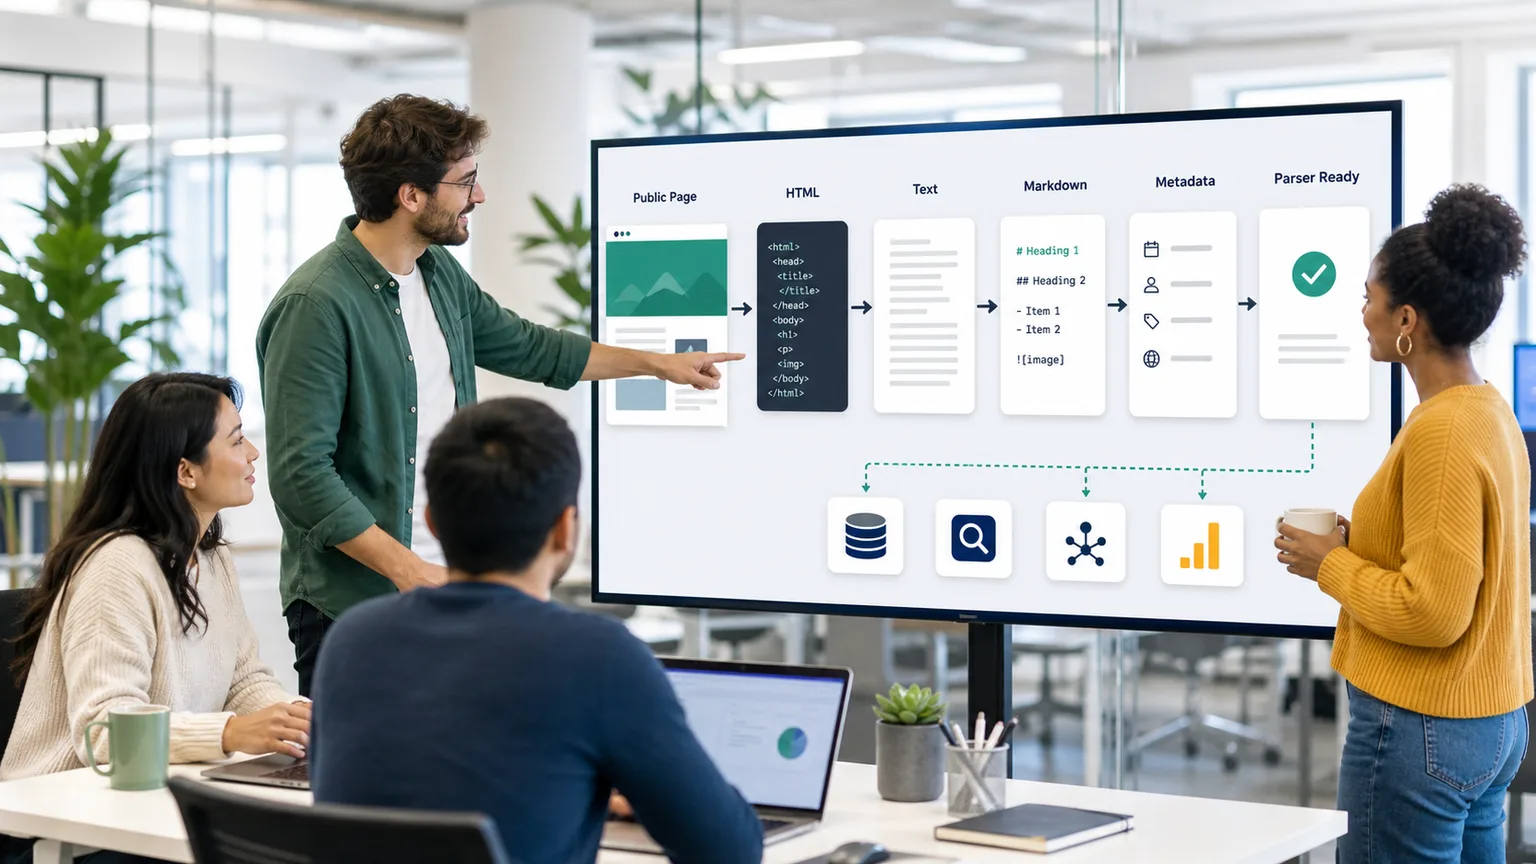
Що таке API для парсингу вмісту веб-сайту?
API для парсингу вмісту веб-сайту корисний, коли він надає вашому додатку надійний вхід для парсера, конвеєра вмісту, пошукового індексу, AI-робочого процесу, архіву або системи контролю якості. API повинен надійно захоплювати публічну сторінку та повертати достатню структуру, щоб ваш код міг вирішити, що важливо.
ScraperFly зосереджується на шарі захоплення та відповіді. Він може повертати сирий або рендерений HTML, коли структура DOM має значення, текст, коли парсеру потрібен лише читабельний вміст, Markdown, коли заголовки та посилання допомагають перегляду або AI-інгестії, JSON-метадані, коли журнали потребують операційного контексту, і візуальні файли, коли людині потрібен доказ того, як виглядала сторінка.
Практичний висновок: використовуйте ScraperFly для чистого захоплення публічного вмісту веб-сайту, а потім зберігайте специфічні для цілей правила парсингу в системі, яка розуміє вашу модель даних.
Що має статися перед створенням правил парсингу?
Дорога помилка - це написання парсерів на основі уявної форми сторінки. Публічний веб-сайт може показувати корисний вміст у першій відповіді HTML, приховувати його за рендерингом на стороні клієнта, повторювати його в навігації, переміщати в метадані або повертати маленьку оболонку, яка говорить вам дуже мало, поки браузер не запуститься. Перше завдання - довести форму захоплення.
Почніть з простого запиту, перевірте статус, фінальну URL-адресу, тип вмісту, розмір відповіді та вміст тіла, а потім виріште, що повинен споживати парсер. Якщо вихідний HTML вже містить цільовий вміст, зберігайте запит легким. Якщо JavaScript змінює результат, протестуйте рендерений вихід. Якщо конвеєр орієнтований на AI, порівняйте чистий текст і Markdown перед створенням конвертерів.
| Запитання | Що перевірити | Краще рішення |
|---|---|---|
| Чи вже присутній корисний вміст? | Вихідний HTML, розмір відповіді, заголовки, посилання, таблиці, картки продуктів, текст статті або вбудовані метадані. | Використовуйте легкий HTML або текстовий запит, коли перша відповідь достатня. |
| Чи створює JavaScript фінальну сторінку? | Порівняйте вихідний HTML з рендереним HTML та видимим станом сторінки. | Увімкніть рендеринг лише тоді, коли виконання браузера змінює захоплений вміст. |
| Чи потрібна парсеру структура DOM? | Селектори, атрибути, списки, посилання, пагінація, структуровані таблиці та повторювані блоки. | Використовуйте HTML, коли структурні зв'язки мають значення. |
| Чи є споживачем AI або робочий процес перевірки? | Читабельні заголовки, посилання, секції статті, шаблони та повторюваний шум макета. | Спробуйте текст або Markdown перед створенням власного шару очищення. |
| Чи потрібен результату доказ? | Статус, фінальна URL-адреса, тип вмісту, скріншот, PDF або артефакт архіву. | Додайте метадані або візуальний вихід, коли налагодження, QA, відповідність або перевірка потребують доказів. |
Який формат виходу найкращий для парсингу вмісту веб-сайту?
Не існує єдиного формату, який би підходив для кожного парсера. HTML потужний, коли логіка витягування потребує структури DOM, але він також приносить навігацію, макет, скрипти та повторюваний шум шаблону. Текст компактний і легкий для пошуку, але він видаляє більшість структурного контексту. Markdown корисний для робочих процесів читабельного вмісту, оскільки заголовки, посилання та списки залишаються легшими для розуміння. Метадані допомагають налагоджувати запит, не змушуючи парсер виводити все з тіла.
Практичний шлях - протестувати два або три виходи на реальних цільових сторінках перед виробництвом. Парсер для вмісту статті може віддати перевагу Markdown. Завдання з виявлення посилань може потребувати HTML. Завдання моніторингу може поєднувати текст з JSON-метаданими. Робочий процес QA може прикріплювати скріншоти або PDF лише для записів, які потребують візуальної перевірки.
| Вихід | Використовуйте його, коли | Слідкуйте за компромісом |
|---|---|---|
| HTML | Парсеру потрібні селектори, атрибути, посилання, таблиці, вбудовані дані або повторювані шаблони DOM. | Потребує очищення та специфічної для цілей логіки парсингу. |
| Рендерений HTML | Вихідна відповідь неповна, поки JavaScript не побудує сторінку. | Важчий, ніж базовий запит, тому увімкніть його для перевірених цілей. |
| Текст | Робочий процес потребує компактного читабельного вмісту для зіставлення, пошуку, резюме або класифікації. | Структурний контекст зменшено. |
| Markdown | Заголовки, посилання, списки та читабельні секції допомагають AI, RAG, документації або перегляду аналітиків. | Не є заміною для точного витягування DOM. |
| JSON-метадані | Журнали потребують фінальної URL-адреси, статусу, типу вмісту, часу або контексту відповіді. | Метадані пояснюють запит; вони не вигадують власні цільові поля. |
| Скріншот або PDF | Переглядач або архів потребує візуального доказу стану публічної сторінки. | Менш зручний для машинного парсингу та важчий за текстовий вихід. |
Порівняйте повний набір форматів на сторінці форматів відповіді API для веб-скрапінгу, а потім протестуйте реальну URL-адресу в API Builder.
Коли рендеринг допомагає парсеру вмісту?
Рендеринг допомагає, коли виконання браузера змінює корисний вміст. Це поширено на сторінках, які гідратують тіла статей, картки продуктів, списки, відгуки, коментарі, результати пошуку або вміст, специфічний для маршруту, після першої відповіді HTML. Це не є знаком якості саме по собі. Рендеринг кожної сторінки може уповільнити парсер, зробити його важчим і важчим для розуміння.
Добрий робочий процес парсера порівнює сире захоплення з рендереним захопленням перед вибором за замовчуванням. Якщо сирий HTML містить дані, зберігайте простий шлях. Якщо сторінка повертає порожню оболонку, затриманий вміст або інший фінальний DOM після виконання коду на стороні клієнта, використовуйте JavaScript rendering API і виберіть найменший корисний вихід після рендерингу.
Де повинна жити логіка парсингу?
ScraperFly не слід розглядати як чорну скриньку, яка магічно знає значення бізнесу кожної цілі. Ваш продукт знає, яка ціна важлива, яка секція статті є важливою, які поля відгуків прийнятні, які варіанти сторінок є дійсними і як витягнутий вміст повинен зберігатися. Ця логіка належить у вашому додатку.
ScraperFly полегшує створення цього додатку, обробляючи шар запитів: отримуючи публічні сторінки, рендерячи за потреби, зберігаючи заголовки або сесії, коли ціль потребує контексту, маршрутизуючи через країну, коли публічний вміст відрізняється за місцем розташування, і повертаючи формати, які зменшують роботу з очищення. Ваш парсер може тоді зосередитися на специфічних для цілей правилах, які створюють цінність.
Для базового захоплення розмітки дивіться HTML scraping API. Для читабельних вхідних даних нижче, порівняйте сторінки HTML to text parser API та HTML to Markdown parser API.
Як ScraperFly зберігає практичність робочих процесів парсингу?
Проекти парсингу часто починаються з невідомих цілей. Деякі сторінки прості. Деякі потребують рендерингу. Деякі потребують заголовків, куків, цільового країни або преміум-маршрутизації. Деякі не повинні масштабуватися, поки форма відповіді не буде доведена. ScraperFly підтримує цей поступовий шлях, а не змушує найважчий профіль запиту з першого дня.
Почніть безкоштовно, протестуйте репрезентативні цільові сторінки та зберігайте кожне джерело на найменшому профілі запиту, який повертає повний корисний вміст. Використовуйте кредити за принципом "плати за те, що використовуєш", поки поведінка та обсяг цілей ще не визначені, а потім перемістіть повторювані навантаження парсера на місячні кредити, як тільки попит стане передбачуваним. Це дозволяє пов'язати зусилля інженерії та вартість запиту з доказами, а не з припущеннями.
Практичний висновок: найкращий парсер вмісту веб-сайту починається з доведеної форми захоплення, невеликого набору форматів відповіді та чіткого шляху оновлення для складніших цілей.










