






ScraperFlyAPI веб-даних для AI

developer api

API для парсингу посилань на веб-сторінках для публічних сторінок

ScraperFly допомагає командам захоплювати вихідний код публічних сторінок, відрендерені стани, метадані фінальних URL та візуальні докази, щоб подальший код міг перевіряти посилання, навігацію, канонічні URL, посилання, пагінацію та контекст сторінки з кращими доказами.

Спочатку зберігайте посилання

Захопіть стан публічної сторінки, перш ніж ваш парсер посилань вирішить, що слід відстежувати

Парсинг посилань звучить просто, поки цільова сторінка не змінює дані. Навігація може бути серверно-рендереною або побудованою в браузері, канонічні URL можуть відрізнятися від запитуваного URL, пагінація може ховатися за JavaScript, а публічні сторінки можуть змішувати внутрішні посилання, зовнішні посилання, медіа-посилання, hreflang, підказки для роботів і редиректи в одному відповіді.

ScraperFly надає командам надійний шар захоплення для цих даних сторінки. Отримуйте публічні сторінки у вигляді сирого або рендереного HTML, зберігайте метадані відповіді, зберігайте візуальні докази, коли це потрібно для QA, і дайте вашому власному парсеру вирішити, які посилання витягувати, нормалізувати, обходити, оцінювати або ігнорувати.
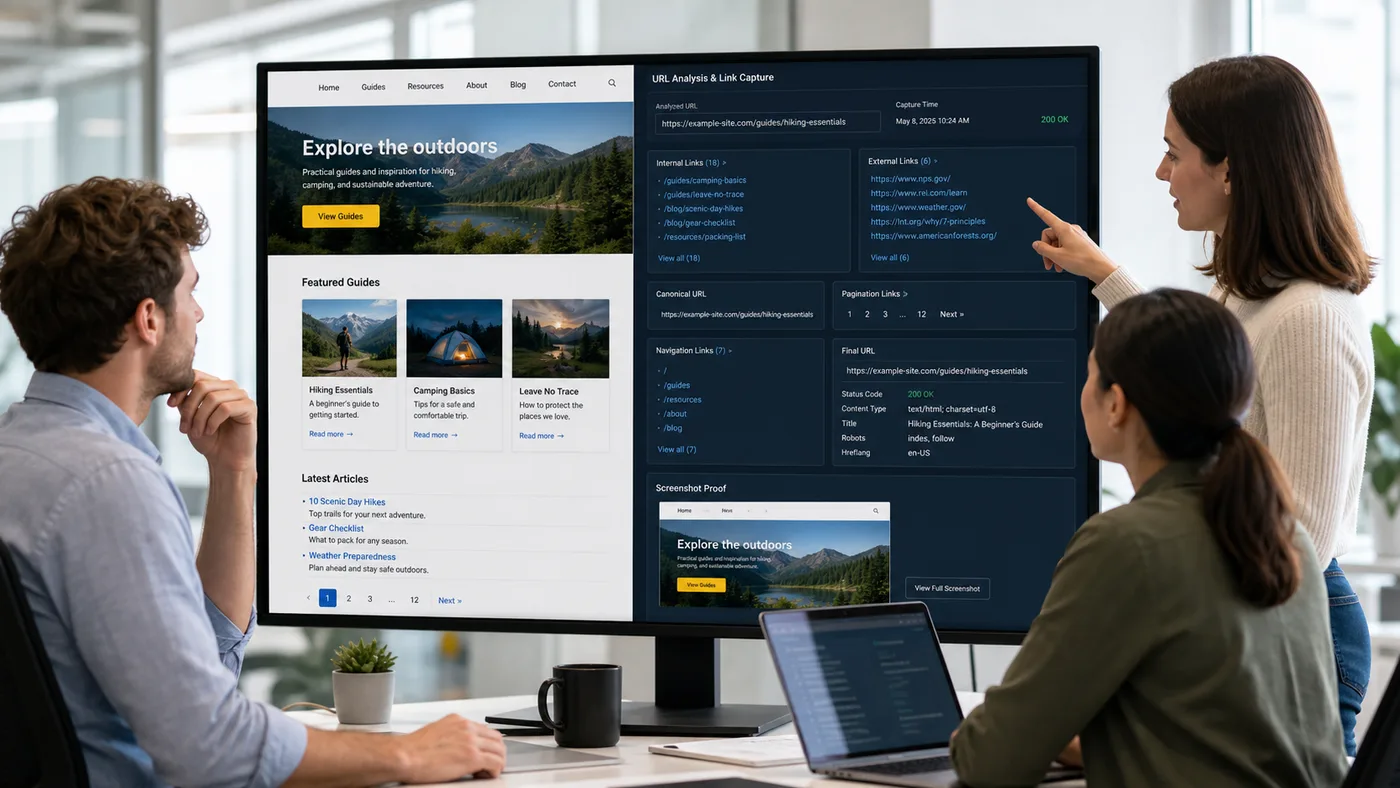
внутрішні посилання канонічні пагінація кінцевий URL
Команда переглядає докази публічної веб-сторінки та виходи парсера

Що таке API парсера веб-сторінок?

API парсера веб-сторінок - це робочий процес, який захоплює публічну сторінку та повертає достатньо вихідних даних для подальшого коду, щоб перевірити посилання. Це може включати сирий HTML, рендерений HTML, метадані кінцевого URL, статус, тип контенту, розмір відповіді, скріншоти, PDF-файли та інший контекст, який допомагає парсеру вирішити, що присутнє на сторінці.

Сам парсер залишається вашою логікою продукту. ScraperFly не замінює планування обходу, оцінювання посилань, SEO-аудит, нормалізацію URL, видалення дублікатів, рішення по карті сайту або бізнес-правила. Він надає парсеру чистіший вхідний шар, щоб ці рішення базувалися на тому, що насправді повернула публічна сторінка.

Цей намір є вужчим, ніж загальний API парсера веб-контенту. Основна увага приділяється доказам посилань: якорям, навігації, канонічним, пагінації, hreflang, зовнішнім посиланням та поведінці кінцевого URL, які можуть вплинути на виявлення, QA, моніторинг або внутрішні інструменти.

Практичний висновок: використовуйте ScraperFly для захоплення сторінки та контексту відповіді, а потім зберігайте рішення про витягування та обходження у вашому власному парсері посилань.

Які посилання та сигнали URL повинні перевіряти команди?

Корисний парсер посилань не повинен вважати кожен href однаково значущим. Навігаційні посилання, пагінація, канонічні URL, альтернативи hreflang, внутрішні контентні посилання, зовнішні посилання, медіа-посилання, посилання, створені скриптом, та редиректовані кінцеві URL несуть різні сигнали. Важливо захоплювати їх з правильного стану сторінки.

Перед масштабуванням визначте, які класи посилань потрібні вашому робочому процесу. Інструмент SEO QA може цікавитися канонічними, hreflang, редиректами та навігацією, що підлягає обходу. Конвеєр виявлення контенту може цікавитися посиланнями на статті та пагінацією. Робочий процес моніторингу може цікавитися, чи зникло важливе публічне посилання з рендереної сторінки.

СигналЧому це важливоНайкращі докази захопленняРішення для подальшого використання
Внутрішні посиланняВідкривають навігацію, шляхи виявлення, пов'язаний контент та структуру сайтуHTML або рендерений HTMLВитягувати, нормалізувати, видаляти дублікат або ставити в чергу
Зовнішні посиланняПоказують посилання, цитати, партнерів, вбудовування та зовнішні залежностіHTML плюс метадані кінцевого URLКласифікувати, перевіряти або моніторити
Канонічний URLМоже відрізнятися від запитуваного URL і впливати на обробку дублікатівHTML head та метадані відповідіНормалізувати записи та уникати дублікатів сторінок
Пагінаційні посиланняКонтролюють, чи може робочий процес виявити наступні результати сторінокHTML, рендерений HTML, доказ у вигляді скріншотаОбережно будувати обсяг обходу
Hreflang та регіональні посиланняВідкривають мовні або регіональні альтернативиHTML head, кінцевий URL, зразки з урахуванням країниКартографувати покриття локалей або регіональні варіанти
Редирект та кінцевий URLПоказують реальне призначення після застосування поведінки ціліJSON метадані та докази статусуВиправляти маршрутизацію, канонізацію та якість посилань

Найсильніші робочі процеси з посиланнями зберігають як список посилань, так і контекст захоплення. Коли парсер виробляє несподіваний результат, статус, кінцевий URL, тип контенту, розмір відповіді, вихідний HTML та рендерений стан допомагають пояснити, чи проблема в сторінці, профілі запиту чи правилі витягування.

Коли парсинг посилань повинен використовувати рендерений HTML?

Багато публічних сторінок все ще відкривають корисні посилання в сирому HTML. У таких випадках сирий HTML є найшвидшим і найпрактичнішим форматом захоплення. Але деякі сайти створюють навігацію, продуктові сітки, нескінченний прокрут, пов'язані посилання або пагінацію після виконання JavaScript на стороні браузера. Парсер, який бачить лише сирий HTML, може пропустити ці посилання або сплутати заповнювачі з реальними доказами сторінки.

Використовуйте JavaScript рендеринг, коли корисний набір посилань з'являється лише в стані сторінки, побудованій браузером. Порівняйте сирі та рендерені відповіді, перш ніж переходити до важчого профілю запиту. Якщо рендеринг не змінює посилання, які потрібні вашому парсеру, зберігайте запит легким.

Візуальний вихід також може допомогти. Скріншоти або PDF-файли не є найкращим джерелом для машинного витягування, але вони корисні, коли QA потрібно довести, що область навігації, контроль пагінації, модуль посилань або стан сторінки з'явилися під час захоплення.

Практичний висновок: рендерити лише тоді, коли виконання в браузері змінює докази посилань, на яких залежить ваш парсер.

Як ScraperFly підтримує SEO QA та планування обходу?

ScraperFly може підтримувати SEO QA, захоплюючи публічні вихідні сторінки, які перевіряють подальші інструменти. API може надати HTML для витягування посилань, метадані для перевірки статусу та кінцевого URL, рендерений вихід для навігації, побудованої на JavaScript, та скріншоти для перегляду. Ваш власний робочий процес все ще володіє правилами обходу, оцінюванням, звітністю, пріоритизацією проблем та логікою виправлення.

Ця межа зберігає сторінку чесною та корисною. Парсер посилань може використовувати ScraperFly для збору надійних зразків, а потім класифікувати посилання за типом, глибиною, призначенням, шаблоном, мовою або вихідним розділом. Робочий процес моніторингу може порівнювати, чи залишаються важливі посилання присутніми. Інструмент QA може зберігати докази скріншота, коли публічна сторінка змінюється.

Використовуйте API Builder, щоб протестувати репрезентативний URL, порівняти сирий та рендерений HTML, перевірити метадані та вирішити, чи потрібен парсеру посилань простий HTML, рендеринг, заголовки, сесії, маршрутизація по країні або візуальні файли перед масштабуванням цілі.

Як парсинг посилань може залишатися передбачуваним та доступним?

Витягування посилань може стати дорогим, коли кожна сторінка розглядається як складний рендерений додаток. Більшість команд повинні почати з простого захоплення HTML, довести, які посилання присутні, а потім додати важчі контролі лише тоді, коли докази відповіді показують, що вони покращують набір посилань або цінність налагодження.

РішенняДобре за замовчуваннямЕскалувати, коли
Формат захопленняСирий HTML для витягування якорівРендерений HTML змінює навігацію, пагінацію або модулі посилань
МетаданіЗберігайте статус, кінцевий URL, тип контенту та розмірНалагоджуйте редиректи, канонічні або непослідовні зразки
Візуальне підтвердженняПропустіть для машинного витягування посиланьQA потребує доказів того, що область посилань з'явилася візуально
Контролі маршрутизаціїСпочатку використовуйте стандартний шляхЛокація, мова, доступ або редиректи змінюють публічні посилання на сторінках
Модель витратВикористовуйте безкоштовні кредити та платіть за фактом під час тестуванняПеремістіть регулярний моніторинг посилань на щомісячні кредити, коли обсяг відомий

Гнучка модель білінгу ScraperFly корисна тут, оскільки парсинг посилань часто починається як дослідницький проект. Протестуйте кілька шаблонів, зберігайте прості сторінки легкими, додавайте рендеринг або візуальні докази лише там, де це важливо, і використовуйте сторінку Ціни, щоб оцінити вагу запиту перед початком регулярного моніторингу.


Практичний висновок: парсинг посилань найкраще масштабується, коли кожен контроль запиту пов'язаний з сигналом посилання, який насправді потрібен парсеру.

Робочий процес парсера посилань

Сформуйте запит на захоплення, перш ніж довіряти списку посилань

Використовуйте API Builder, щоб протестувати репрезентативні публічні сторінки, порівняти сирий та рендерений HTML, перевірити метадані кінцевого URL та вибрати форму відповіді, яку ваш парсер посилань, інструмент SEO QA або робочий процес моніторингу можуть використовувати негайно.

01
01

Захоплюйте якорі та структуру сторінки

Використовуйте HTML, коли вашому парсеру потрібні href, навігація, канонічні, пагінація, hreflang або контекст DOM.

02
02

Рендерити посилання, створені браузером

Увімкніть рендеринг, коли публічні посилання, картки або навігація з'являються лише після виконання JavaScript на фронтенді.

03
03

Налагоджуйте поведінку кінцевого URL

Використовуйте метадані відповіді, щоб порівняти запитуваний URL, кінцевий URL, статус, тип контенту, редиректи та розмір відповіді.

Корисні контролі запиту парсера посилань

url

Цільова сторінка для отримання, рендерингу, очищення або захоплення.

format

Виберіть відповідь, яка потрібна вашому продукту: html, text, markdown, json, screenshot або pdf.

premium

Ескалюйте до сильнішого маршруту для блокувань, нестабільних цілей або контенту, чутливого до геолокації.

render

Запустіть Chromium для SPA, JS-інжектованого розмітки, скриншотів, PDF та сторінок тільки для браузера.

country

Запросіть маршрут, специфічний для країни, коли контент змінюється в залежності від місця.

keep_headers

Пересилайте вибраний контекст запиту, такий як user-agent, cookie, мова та referer.

render_wait

Надайте динамічному контенту контрольовану додаткову затримку перед витягуванням або захопленням.

download

Поверніть візуальні артефакти як завантажувані файли, коли вихід - це скриншот або PDF.

приклад cURL

Генеруйте Markdown з тією ж формою запиту, яку ви можете перенести в продукцію

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Планування цілей посилань

Картографуйте шаблон сторінки перед масштабуванням витягування посилань

Головна сторінка, категорійна сторінка, сторінка пошуку, стаття, сторінка документації та пагінований індекс можуть відкривати дуже різні сигнали посилань. Перевірте, чи присутні посилання в сирому HTML, чи змінює рендеринг набір, чи важливі канонічні або hreflang, і чи потрібні візуальні докази для QA.

Сирова HTML-відповідь, відображена на видимих даних сторінки
01

Доступність сирого HTML

Перевірте, чи поля, які вам потрібні, вже присутні в першій HTML-відповіді.

Найкращий перший тест для простих сторінок, статей, документів, списків та деталей продуктів.

Порівняння до і після рендерингу JavaScript
02

Залежність від JavaScript

Порівняйте сирий HTML з відрендереним DOM або скріншотом перед увімкненням рендерингу браузера.

Використовуйте рендеринг, коли сирий HTML є лише оболонкою, а скрипти створюють корисний контент.

Куки, згода, контекст сесії та доступу для скрапінгу
03

Стан і контекст доступу

Визначте, чи впливають куки, згода, межі входу, пагінація або той самий стан відвідувача на відповідь.

Використовуйте сесії та заголовки, коли безперервність змінює дані, які ви отримуєте.

Регіональні варіації контенту в різних країнах і маршрутах
04

Гео/варіація контенту

Перевірте, чи змінюють країна, мова, валюта, інвентар, SERP, реклама або репутація маршруту результат.

Використовуйте гео- або преміум-маршрути лише тоді, коли ціль підтверджує, що відповідь змінюється залежно від маршруту.

Запитання перед витягуванням посилань у масштабах

Де знаходиться цільове поле?

Знайдіть, чи існує поле в сирому HTML, відрендереному DOM, виклику API, структурованих даних, файлі або пізнішому стані взаємодії.

Що змінює відповідь?

Виберіть кілька URL-адрес і порівняйте статус, фінальну URL-адресу, довжину вмісту, перенаправлення, порожні стани та видимі відмінності результатів.

Який контекст потрібен?

Позначте будь-яку залежність від згоди, локалі, куків, заголовків, межі аутентифікації, пагінації, фільтрів або попередніх запитів.

Як виглядає невдача?

Визначте сигнали для заблокованих, часткових, застарілих, перенаправлених, порожніх, з тайм-аутом або регіонально невідповідних відповідей перед масштабуванням.

Налаштування парсера посилань

Режим отримання

Доступність сирого HTML визначає, чи може перший запит залишатися простим або потребує рендерингу, очікувань, скріншотів або витягування.

Контекст запиту

Вимоги до стану визначають, чи потрібно додавати заголовки, куки, сесії, обробку згоди або стабільний профіль відвідувача.

Вибір маршруту

Гео та репутаційні дані визначають, чи достатньо стандартного маршруту або виправданий маршрут країни/преміум.

Правила валідації

Відомі стани невдачі стають перевірками для повторних спроб, ескалації, перевірки якості та визначення, коли легший профіль все ще є повним.

Краща доказовість посилань.

Виберіть ScraperFly, коли витягування посилань потребує доказів з джерела, а не здогадок краулера.

ScraperFly допомагає командам спочатку протестувати реальну публічну сторінку, свідомо вибрати сирий або відрендерений HTML, зберегти метадані для налагодження та зберегти вартість запиту, пов'язану з контролем, який дійсно покращує доказовість посилань.

Щаслива команда, що перевіряє проект на ноутбуці
01 / Почніть легко

Легкий, безкоштовний старт перед будь-яким тиском з боку рахунків

ScraperFly дає вам можливість спочатку протестувати реальну ціль. Використовуйте безкоштовні кредити, щоб перевірити, чи працює сторінка, чи є дані, і які контролі насправді потрібні, перш ніж вкладати гроші в план. Це робить перший експеримент легким: без циклу закупівлі, без примусової підписки, без здогадок про ваш місячний обсяг з першого дня.

Безкоштовні кредитиБез картки для перших тестівПеревірте перед масштабуванням
Посміхаючий професіонал, який успішно працює з ноутбуком
02 / Витрачайте розумно

Доступне, гнучке виставлення рахунків для реального обсягу скрапінгу

Не кожне навантаження для скрапінгу є акуратною місячною кривою. Деякі проекти зростають, деякі призупиняються, а деякі стають регулярними лише після того, як дані доводять свою цінність. ScraperFly підтримує цю реальність з моделлю оплати за фактом використання плюс місячні кредитні плани, коли стабільний обсяг має сенс. Ви можете купити те, що вам потрібно, тримати витрати під контролем і уникнути перетворення маленького тесту на надмірну підписку.

Платіть за фактом використанняЩомісячно, коли це корисноКонтроль витрат
Розробник, що готує структурований вихід з ноутбука
03 / Доставляйте швидше

Попередня обробка відповіді, яка усуває роботу з очищення

Дешевий запит недостатній, якщо ваша команда все ще повинна створювати конвертери, очищувачі, скріншоти, захоплення PDF та форматування, готове для LLM. ScraperFly може повернути відповідь у форматі HTML, чистого тексту, Markdown, структурованого JSON, PDF або зображення, тому ваш конвеєр наближається до фінального активу в одному запиті. Менше коду для з'єднання, менше рухомих частин, швидша доставка.

HTMLТекстMarkdownJSONPDFЗображення

Де ScraperFly допомагає командам парсингу посилань.

Порівняйте вибір запитів щодо сирого HTML, відрендерованої навігації, доказів фінального URL, візуального QA та контролю витрат перед масштабуванням повторюваного моніторингу посилань.

Точка прийняття рішенняПеревага ScraperFlyТиповий компроміс конкурентів
Перше експериментуванняПочніть з безкоштовних кредитів і перевірте реальну ціль перед витратами. Ви можете довести, чи потрібні насправді сирий HTML, рендеринг, преміум маршрутизація або цільова країна.Тести часто швидко підштовхують вас до підписки на регулярний план або приховують справжню вартість, поки додаткові послуги не потраплять у запит.
Модель білінгуВикористовуйте кредити за принципом "плати за те, що використовуєш" для нерівномірної роботи, а потім переходьте на місячні кредити лише тоді, коли обсяг роботи стане передбачуваним. Це робить невеликі тести та проектне скрапінг доступними.Багато інструментів оптимізовані під місячні підписки, фіксовані дозволи або рівневі обмеження, які можуть здаватися важкими, поки обсяг не буде доведено.
Вага запитуЗалишайте прості сторінки простими. Увімкніть рендеринг JavaScript, преміум маршрутизацію, сесії, заголовки, затримки або маршрутизацію за країною лише тоді, коли докази відповіді вказують на їх важливість.Порівнянні контролі можуть існувати, але їх часто об'єднують у вищі рівні, за замовчуванням або більш складні цінові профілі.
Формати виходуПоверніть відповідь у формі, яка потрібна вашому продукту: HTML для парсерів, текст або Markdown для контентних конвеєрів, JSON для структурованих метаданих та PDF/зображення для візуального підтвердження.Деякі постачальники зосереджуються переважно на доступі та залишають форматування, захоплення, очищення та підготовку до подальшої обробки на вашому власному коді.
Робочий процес розробникаОдна API поверхня може охоплювати тестування цілей, ескалацію, рендеринг, маршрутизацію, сесії, заголовки, форматування відповідей та перевірки статусу. Шлях від прототипу до виробництва залишається компактним.Інструменти з пріоритетом проксі, ринкові платформи акторів та платформи краулінгу можуть бути потужними, але часто вимагають більше коду "клею" або важчої моделі експлуатації.
Найкраще підходитьКоманди, які хочуть практичної доставки веб-даних: починайте з малого, вимірюйте вартість за корисний результат і масштабуйте лише ті контролі, які покращують результат.Команди з фіксованими контрактами на великий обсяг, спеціальною проксі-інфраструктурою або широкими потребами в краулінгу ринку можуть віддати перевагу більш спеціалізованій платформі.

Контроль витрат

Зберігайте парсинг посилань доступним, зберігаючи прості сторінки простими.

Багато робочих процесів парсингу посилань можуть починатися з сирого HTML та метаданих. ScraperFly дозволяє командам тестувати публічні сторінки з безкоштовними кредитами, використовувати оплату за фактом, поки поведінка джерела нерівномірна, і додавати рендеринг, візуальні файли або більш потужну маршрутизацію лише тоді, коли ці контролі покращують захоплену доказовість посилань.

Легкий HTML-запит, що повертає просту відповідь
01

Базовий запит

Використовуйте базовий запит, коли публічний HTML вже містить необхідні вам поля.

Найлегший профіль запиту; зберігайте його, коли відповідь завершена.

Рендеринг JavaScript, що створює повний DOM
02

Рендеринг

Використовуйте рендеринг, коли сирий HTML є оболонкою, а JavaScript завершує сторінку.

Важчий профіль; використовуйте його лише тоді, коли вихід браузера змінює результат.

Кілька запитів з збереженням куків та стану відвідувача
03

Станова сесія

Використовуйте сесії, коли куки, згода, локалізація або пагінація змінюють відповідь.

Важчий профіль стану; зберігайте його лише тоді, коли важлива безперервність.

Маршрутизація запитів через гео та маршрути вищої якості
04

Преміум маршрутизація та гео

Використовуйте преміум маршрутизацію або гео лише тоді, коли походження, країна, репутація або регіональний контент змінюють результат.

Найважчий профіль маршрутизації; застосовуйте його лише до цілей, які доводять, що вони його потребують.

Фактори витрат парсера посилань.

Більше роботи з інфраструктурою

Рендеринг браузера, вибір маршрутизації та довші очікування означають, що платформа повинна виконувати більше, ніж просто повертати просту відповідь.

Більша невизначеність цілі

Редиректи, порожні стани, обмеження швидкості та сторінки викликів часто вимагають більш потужних варіантів доставки або повторних спроб.

Більше стану для збереження

Cookies, сесії, згода та багатосторінкові потоки додають рухомі частини, яких немає у простому безстатевому запиті.

Більше доказів для повернення

Скріншоти, PDF, рендерений вихід та багатші артефакти відповіді корисні, але вони важчі за простий HTML.

Контролі, які повинні заробити своє місце

Вибірка перед масштабуванням

Спочатку протестуйте невелику вибірку URL та групуйте цілі за найменшим профілем, який повертає повні дані.

Не рендерити за замовчуванням

Перевірте сирий HTML перед увімкненням рендерингу. Багато публічних сторінок вже містять необхідні вам дані.

Ескалація за доказами

Підвищуйте лише тоді, коли відповідь показує відсутній контент, залежність стану, гео варіацію або проблеми з маршрутизацією.

Вимірюйте корисні результати

Оптимізуйте навколо дійсних записів, що доставляються, а не сирого обсягу запитів. Легший профіль найкращий лише тоді, коли він залишається повним.

Часті запитання про парсер посилань

Загальні питання про парсинг посилань веб-сторінок за допомогою ScraperFly.

Практичні відповіді для команд, які захоплюють доказовість публічних сторінок для подальшого витягування посилань, SEO QA, виявлення, моніторингу та планування краулінгу.

Швидкі відповіді

Захоплення проти обходу

Де ScraperFly вписується в робочий процес посилань.

Чи витягує ScraperFly кожне посилання автоматично?

ScraperFly захоплює публічну сторінку та контекст відповіді. Ваш парсер володіє правилами витягування, нормалізації, видалення дублікатів, чергами обходу та оцінюванням.

Чи може він замінити SEO-обхідник?

Ні. ScraperFly може надати джерельні докази для подальших SEO перевірок, тоді як планування обходу, оцінювання, звітність та пріоритизація залишаються у вашій системі.

Посилання та контекст URL

Знайте, які сигнали URL мають значення.

Які посилання я повинен перевірити?

Загальні сигнали включають внутрішні посилання, зовнішні посилання, навігацію, пагінацію, канонічний URL, альтернативи hreflang, медіа-посилання та поведінку фінального URL.

Чому варто зберігати метадані фінального URL?

Фінальний URL, статус, тип контенту та розмір відповіді допомагають налагоджувати перенаправлення, канонізацію, поведінку доступу та непослідовні зразки.

Посилання JavaScript

Використовуйте виконання браузера, коли посилання створюються браузером.

Коли я повинен рендерити перед парсингом посилань?

Рендеринг, коли публічні посилання, навігація, пагінація, картки або пов'язані модулі з'являються лише після виконання фронтенд JavaScript.

Чи повинна кожна запит на парсер посилань рендерити?

Ні. Почніть з сирого HTML і рендерте лише тоді, коли доказ посилання змінюється в стані сторінки, створеній браузером.

Налагодження та докази

Зберігайте докази корисними для людей і машин.

Чи корисні скріншоти для парсингу посилань?

Вони корисні для QA та доказів видимої навігації або пагінації, але HTML залишається кращим джерелом для машинного вилучення.

Як мені зберегти витрати передбачуваними?

Спочатку використовуйте сирий HTML та метадані, потім додавайте рендеринг, візуальні файли або більш потужну маршрутизацію лише тоді, коли ціль доведе, що вони покращують докази посилання.








