






React-Rendering
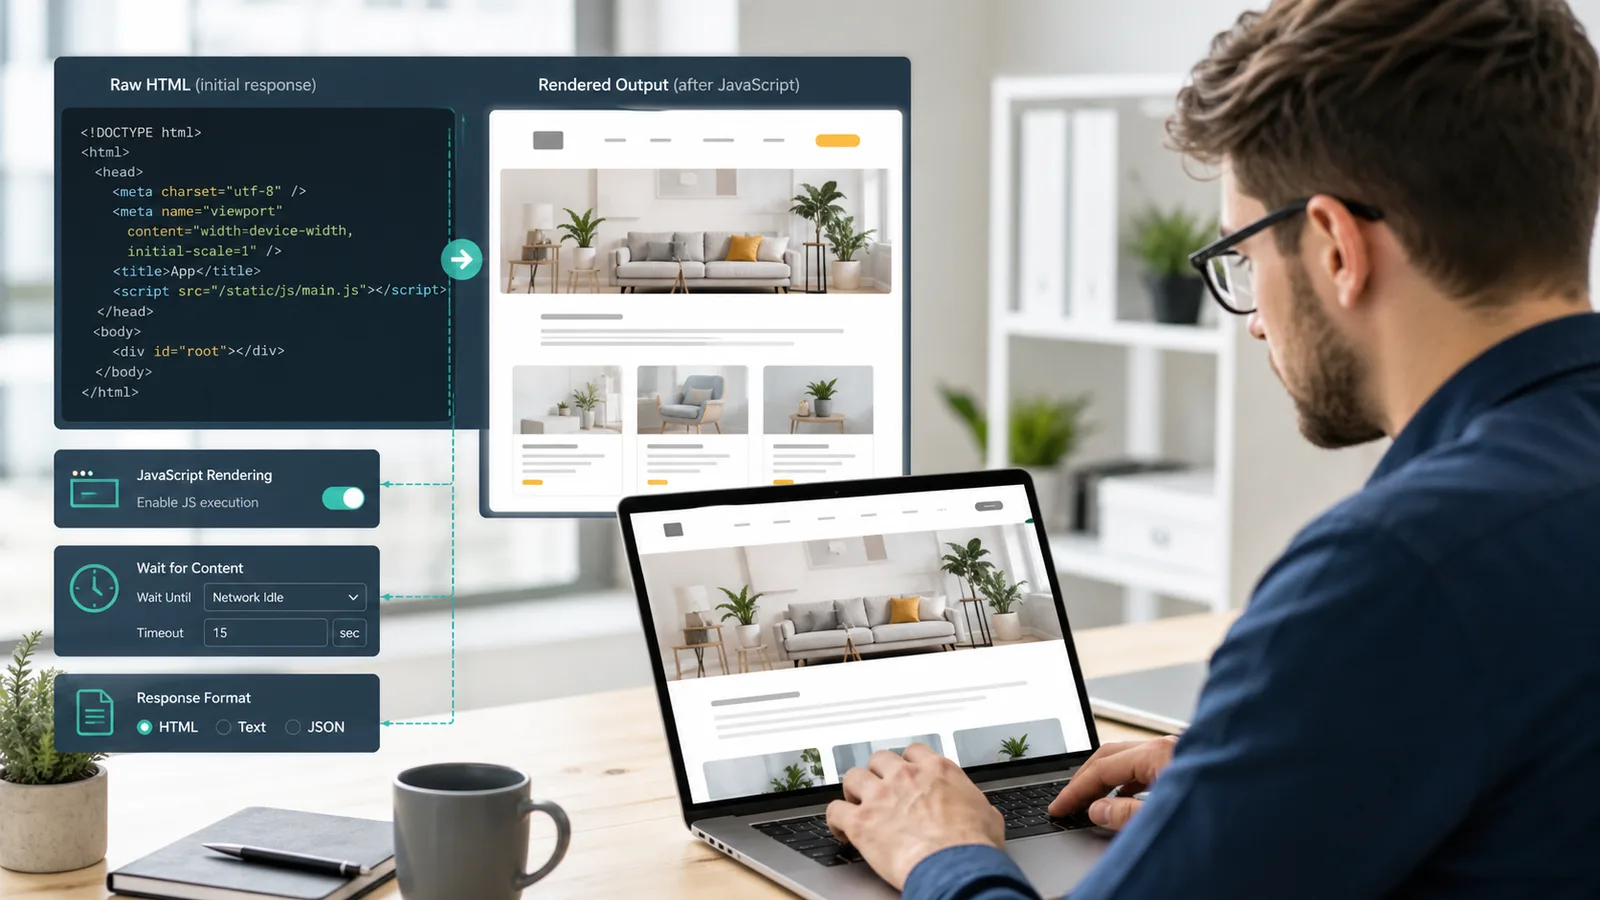
Vergleichen Sie den Quell-HTML mit dem gerenderten Output, bevor Sie die App scrapen
React-Websites können im Browser vollständig aussehen, während die erste HTML-Antwort nur eine kleine App-Hülle enthält. ScraperFly hilft Teams, diesen Unterschied nachzuweisen, bevor sie Parser-Logik, Warteschlangenarbeiter oder Browser-Infrastruktur um die falsche Antwort herum aufbauen.
Beginnen Sie mit dem Quell-HTML, überprüfen Sie, was das Ziel tatsächlich zurückgibt, und aktivieren Sie dann das Browser-Rendering, Wartezeiten, Sitzungen, Header, Länderrouting oder visuelle Ausgaben nur, wenn die gerenderte React-Seite Ihrem Workflow bessere Beweise liefert.
Warum sind React-Websites anders zu scrapen?
React-Websites trennen oft die erste Serverantwort von der Seite, die ein Benutzer schließlich sieht. Das Quell-HTML kann ein Wurzelelement, Skript-Tags, Routen-Metadaten, Hydrationsdaten oder einen kleinen Platzhalter enthalten. Die nützlichen Produktkarten, Artikelabschnitte, Suchergebnisse, Preise, Tabellen, Bewertungen, Filter oder Profilinhalte erscheinen möglicherweise erst, nachdem JavaScript im Browser ausgeführt wurde.
Das bedeutet nicht, dass jede React-Seite das schwerste Scraping-Profil benötigt. Einige React-Anwendungen geben immer noch nützliche Metadaten, eingebetteten Zustand, servergerenderte Inhalte oder strukturierte Payloads in der ursprünglichen Antwort preis. Andere benötigen gerendertes HTML, da der Inhalt clientseitig erstellt wird. Der praktische Workflow besteht darin, beide Zustände zu vergleichen, bevor entschieden wird, wie die Seite erfasst werden soll.
Praktische Erkenntnis: React-Scraping sollte mit Beweisen beginnen, nicht mit Annahmen darüber, ob die Seite einen Browser benötigt.
Was sollten Sie überprüfen, bevor Sie eine React-Seite rendern?
Die erste Überprüfung ist die Quellantwort. Suchen Sie nach nützlichen Inhalten, nicht nur nach einem erfolgreichen Statuscode. Eine 200-Antwort kann immer noch eine leere Hülle sein, wenn die Seite erwartet, dass der Browser Daten abruft, Komponenten hydratisiert und das endgültige DOM aufbaut. Überprüfen Sie den Body, die Antwortgröße, Skript-Payloads, Metadaten, die endgültige URL und ob die Ziel-Felder im HTML erscheinen, das Ihr Parser erhält.
Wenn das Quell-HTML bereits die benötigten Felder enthält, halten Sie die Anfrage einfach. Wenn das Quell-HTML die nützlichen Inhalte vermisst, vergleichen Sie den gerenderten Output. Wenn der gerenderte Output das DOM auf bedeutende Weise ändert, ist das Rendering gerechtfertigt. Wenn der gerenderte Output immer noch leer ist, kann das Problem an der Zeit, dem Routing, blockierten Ressourcen, einer schlechten Route, nicht verfügbaren öffentlichen Inhalten oder einer Seite liegen, die einen anderen Workflow erfordert.
| React-Signal | Was es bedeutet | Bester nächster Schritt |
|---|---|---|
| Quell-HTML enthält Zielinhalt | Die Seite kann wahrscheinlich ohne Browser-Rendering erfasst werden | Verwenden Sie eine leichte HTML-Anfrage und erstellen Sie den Parser aus Quellbeweisen. |
| Quell-HTML besteht hauptsächlich aus einem Wurzelelement und Skripten | Die Seite erstellt wahrscheinlich nützliche Inhalte im Browser | Testen Sie das gerenderte HTML, bevor Sie die Extraktionslogik schreiben. |
| Gerendertes DOM enthält die Ziel-Felder | Die Ausführung von JavaScript ändert das Scraping-Ergebnis | Verwenden Sie das Rendering für diesen Seitentyp und protokollieren Sie, warum es benötigt wird. |
| Gerenderte Seite ist immer noch unvollständig | Das Problem kann an der Zeit, dem Anfragekontext, dem Routing oder dem Zielverhalten liegen | Überprüfen Sie die Wartezeiten, den Status, die endgültige URL, die Antwortgröße und den visuellen Beweis. |
| Visuelle Seite unterscheidet sich je nach Region oder Zustand | Die Route kann von Standort, Cookies, Headern oder Sitzungs-Kontinuität abhängen | Fügen Sie absichtlich Kontext hinzu, anstatt jede Anfrage schwerer zu machen. |
Wann sollte ScraperFly eine React-Website rendern?
Aktivieren Sie das Rendering, wenn der nützliche öffentliche Inhalt erscheint, nachdem clientseitiges JavaScript ausgeführt wurde. Häufige Beispiele sind React-Produktgitter, Suchergebnisse, Dashboards mit öffentlichen Daten, routenbasierte Artikelseiten, Lazy-Abschnitte, Bewertungs-Widgets, Preisblöcke, Filter und Seiten, bei denen die erste HTML-Antwort Platzhalter anstelle des endgültigen Inhalts enthält.
Das Rendering sollte präzise sein. Aktivieren Sie es nicht, nur weil die Seite React verwendet; aktivieren Sie es, weil die rohe Antwort nicht das enthält, was der Workflow benötigt, und die gerenderte Antwort dies tut. Dies hält einfache Seiten schnell und erschwinglich, während sie den von Browsern erstellten Seiten die Umgebung geben, die sie benötigen.
Für umfassendere Entscheidungen zur Browsererfassung verwenden Sie den JavaScript-Rendering-API-Leitfaden und die Headless-Browser-Scraping-API-Seite. Für Quell-first-Ziele vergleichen Sie den Ansatz der HTML-Scraping-API, bevor Sie das Rendering zum Standard machen.
Welches Ausgabeformat funktioniert am besten nach dem React-Rendering?
Gerendertes HTML ist die beste Wahl, wenn Ihr Parser das endgültige DOM, Selektoren, Attribute, Links, Tabellen, Produktkarten oder Routeninhalte benötigt. Text und Markdown sind besser, wenn die React-Seite Suchanfragen, Zusammenfassungen, KI-Kontext, Dokumentationsüberprüfungen oder RAG-Aufnahmen ohne Layoutgeräusche speisen soll. JSON-Metadaten sind nützlich für das Protokollieren von Anfragebeweisen. Screenshots und PDFs sind nützlich, wenn ein Mensch überprüfen muss, wie die gerenderte Seite aussah.
Diese Wahl sollte getroffen werden, bevor Konverter erstellt werden. Ein React-Scraping, das einen Parser speist, benötigt möglicherweise gerendertes HTML. Ein React-Scraping, das ein LLM speist, ist möglicherweise besser als Markdown. Ein Überwachungs-Workflow benötigt möglicherweise Metadaten plus einen Screenshot. Ein Compliance- oder QA-Workflow benötigt möglicherweise ein PDF. ScraperFly ermöglicht es, dass die Anfrage die Form zurückgibt, die das nachgelagerte System sofort verwenden kann.
| React-Workflow | Ausgabe zum Testen | Warum es hilft | Wann man es vermeiden sollte |
|---|---|---|---|
| DOM-Parsing | Gerendertes HTML | Gibt die Seite zurück, nachdem React nützliche Markup erstellt hat | Wenn das Quell-HTML bereits die Ziel-Felder enthält. |
| Inhaltsaufnahme | Text oder Markdown | Entfernt viel von dem Layoutgeräusch vor der Suche oder KI-Verarbeitung | Wenn genaue Selektoren oder DOM-Beziehungen wichtig sind. |
| Diagnose | JSON-Metadaten | Zeigt Status, endgültige URL, Inhaltstyp, Antwortgröße und Anfragekontext an | Wenn der Workflow erwartet, dass extrahierte Ziel-Felder von selbst vorhanden sind. |
| Visuelle QA | Screenshot | Bestätigt, wie die gerenderte öffentliche Seite aussah | Wenn der Workflow nur maschinenlesbaren Text benötigt. |
| Archiv oder Genehmigung | Erstellt einen tragbaren Nachweis zur Überprüfung | Wenn der Inhalt häufig automatisiert geparst werden muss. |
Wie sollten Wartezeiten, Sitzungen, Header und Routing behandelt werden?
React-Seiten können aus Gründen fehlschlagen, die von außen ähnlich aussehen. Eine Seite benötigt möglicherweise zusätzliche Wartezeit, weil Daten nach dem ersten Rendering geladen werden. Sie benötigt möglicherweise Header, weil die öffentliche Route Sprache oder Inhaltskontext erwartet. Sie benötigt möglicherweise Sitzungen, weil verwandte Anfragen auf gemeinsamen Cookies oder Zustand basieren. Sie benötigt möglicherweise Länderrouting, weil sich der Inhalt je nach Region, Währung oder Verfügbarkeit ändert. Sie benötigt möglicherweise eine stärkere Lieferung, wenn der einfache Pfad wiederholt unbrauchbare Ausgaben zurückgibt.
Die richtige Antwort besteht nicht darin, alles zu aktivieren. Fügen Sie eine Steuerung nach der anderen hinzu und vergleichen Sie das Ergebnis. Wenn eine Wartezeit fehlende Inhalte behebt, protokollieren Sie den Zeitgrund. Wenn Sitzungen die Antwort ändern, behalten Sie sie nur für diesen verwandten Flow. Wenn die Region die Seite ändert, halten Sie das Länderrouting an das Ziel gebunden. Ein React-Scraping-Workflow ist am einfachsten zu bedienen, wenn jede aktivierte Steuerung einen sichtbaren Grund hat.
Verwenden Sie Sitzungen für zustandsabhängige öffentliche Flows, benutzerdefinierte Header für legitimen Anfragekontext und Routing-Kontrollen, wenn der Lieferpfad das Ergebnis ändert.
Welche Fehler sind häufig beim Scrapen von React-Websites?
Der häufigste Fehler besteht darin, eine leere Quellantwort als Zielblock zu behandeln, wenn es sich in Wirklichkeit nur um eine normale React-Hülle handelt. Ein weiterer häufiger Fehler ist das zu schnelle Rendern und das Erfassen der Seite, bevor clientseitige Daten vollständig geladen sind. Teams stoßen auch auf Routen-Weiterleitungen, Inhalte, die sich je nach Region ändern, übergroße Antworten, fehlende öffentliche Daten, nicht unterstützte Ausgabeoptionen und Workflows, die erwarten, dass die API den Anwendungszustand automatisch extrahiert.
Gute Fehlerbehandlung hält diese Fälle getrennt. Vergleichen Sie Quell-HTML, gerendertes HTML, Screenshot-Zustand, endgültige URL, Status, Antwortgröße und Wartezeiten. Beheben Sie fehlerhafte Eingaben und nicht unterstützte Optionen, anstatt sie erneut zu versuchen. Wiederholen Sie vorübergehende Fehler mit begrenztem Backoff. Eskalieren Sie das Routing nur, wenn wiederholte Beweise zeigen, dass der einfache Pfad nicht ausreicht.
Der Fehlerbehandlungsblock unten bietet einen breiteren Fehlerrahmen. Für React-Seiten ist der Schlüssel, "der Browser hat die Seite noch nicht erstellt" von "das Ziel hat eine schlechte Seite zurückgegeben" und "das Anfrageprofil ist falsch" zu unterscheiden.
Wie kann React-Scraping erschwinglich bleiben?
Rendering ist leistungsstark, aber die Arbeit im Browser ist schwerer als eine einfache HTML-Anfrage. Die Kosten bleiben vorhersehbar, wenn Teams Ziele klassifizieren, bevor sie skalieren: rohe HTML-Seiten, gerenderte React-Seiten, Seiten, die Wartezeiten benötigen, regionale Routen, sitzungsabhängige Flows, visuelle QA-Erfassungen und PDF-Archive. Jede Klasse sollte ihr eigenes Anfrageprofil haben, anstatt ein teures Standardprofil zu erben.
Hier ist der Weg von ScraperFly praktisch. Beginnen Sie kostenlos, testen Sie echte React-Seiten, halten Sie einfache Erfassungen leicht und verwenden Sie schwerere Kontrollen nur dort, wo sie die Antwort ändern. Ein einmaliges Projekt kann flexibel mit Credits bleiben, während wiederkehrende gerenderte Arbeitslasten auf einen monatlichen Plan umsteigen können, sobald das Profil bewährt ist.
Überprüfen Sie Preise, nachdem Sie echte Ziele getestet haben, nicht vorher. Die nützliche Schätzung basiert darauf, wie viele Seiten tatsächlich Rendering, Wartezeiten, visuelle Ausgaben, Sitzungen oder stärkere Lieferungen benötigen.
Wo sollte ein Team anfangen?
Beginnen Sie im API Builder mit einer öffentlichen React-URL. Fordern Sie zuerst das Quell-HTML an. Wenn der nützliche Inhalt fehlt, aktivieren Sie das Rendering und vergleichen Sie das Ergebnis. Wählen Sie dann das Ausgabeformat, das Ihr Workflow verwenden kann: gerendertes HTML für Parser, Text oder Markdown für lesbare Inhalte, JSON-Metadaten für Diagnosen, Screenshot oder PDF für visuellen Beweis.
Sobald das Anfrageprofil bewährt ist, integrieren Sie es in cURL, Python, Node.js, eine Backend-Warteschlange, einen Überwachungsjob oder einen Agenten-Workflow. Halten Sie das Profil explizit, damit zukünftige Fehler anhand von Beweisen und nicht durch Vermutungen diagnostiziert werden können.












