






Evidencia social pública
Captura páginas sociales públicas sin pretender poseer la capa de la plataforma
El scraping social es valioso cuando los equipos necesitan evidencia pública visible: páginas de perfil, páginas de marca, páginas de publicaciones, menciones públicas, páginas de campañas, actualizaciones de la comunidad o estados de página que necesitan revisión y archivo. Se vuelve arriesgado y poco útil cuando la capa de captura pretende proporcionar acceso privado, enriquecimiento de seguidores, puntuación de sentimientos o un conjunto de datos sociales completo.
ScraperFly mantiene la frontera clara. Captura páginas públicas en formatos útiles, expone el contexto de respuesta, soporta renderizado cuando el contenido visible necesita ejecución en el navegador, y permite que tu propio sistema decida qué analizar, clasificar, comparar, reportar o ignorar.
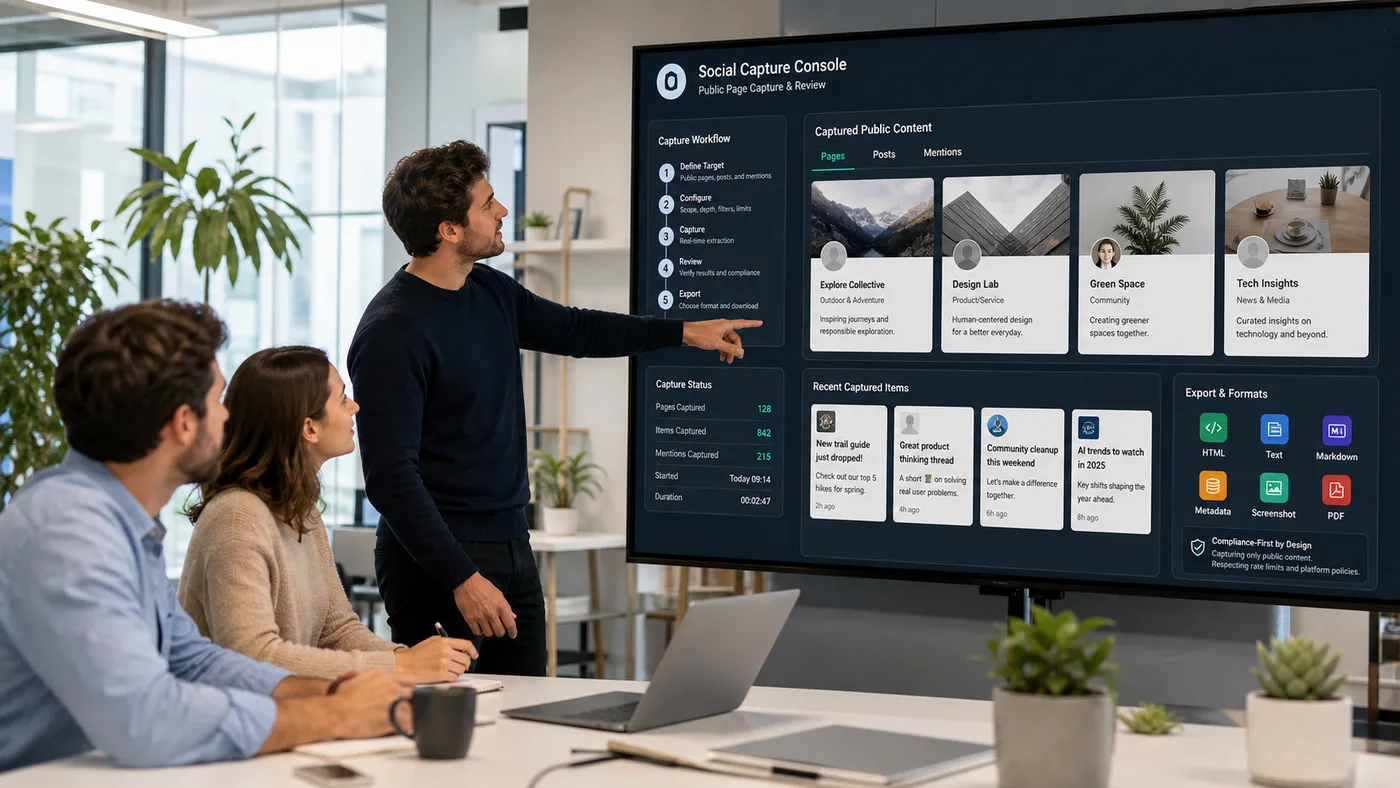
¿Qué es una API de scraping de redes sociales?
Una API de scraping de redes sociales es una capa de solicitud alojada para capturar páginas web sociales públicas y devolver el resultado a tu aplicación. La página podría ser un perfil público, una página de marca pública, una página de publicación, una página de hashtag o mención, una página de destino de campaña, o otra superficie social visible que tu equipo está autorizado a revisar.
La palabra importante es captura. ScraperFly no reemplaza los controles de política de tu producto, el modelo de datos, las reglas de enriquecimiento, la lógica de informes o la capa de clasificación. Ofrece a los desarrolladores una forma controlada de obtener una página pública, inspeccionar lo que regresó, elegir un formato de respuesta y preservar evidencia antes de que los sistemas posteriores transformen esa página en algo útil.
Eso hace que el flujo de trabajo sea más honesto y más útil. En lugar de prometer un conjunto de datos sociales mágico, la capa de captura de páginas responde a una pregunta de ingeniería práctica: ¿podemos recuperar de manera confiable el estado de la página pública que nuestro producto necesita para analizar, comparar, resumir, monitorear o archivar?
¿Qué páginas sociales públicas valen la pena capturar?
Los flujos de trabajo sociales a menudo mezclan varios tipos de páginas. Un perfil público puede mostrar identidad, biografía, enlaces, publicaciones recientes y metadatos visibles. Una página de publicación puede llevar el contenido canónico, medios, marcas de tiempo, vista previa de comentarios, contexto de compartición o un estado de compromiso público. Las páginas de marca y campaña pueden ser importantes para monitoreo, investigación competitiva, revisión de cumplimiento o control de calidad de contenido.
La estrategia de captura debe seguir el trabajo. Un flujo de trabajo de monitoreo necesita marcas de tiempo estables, URLs finales, estado de respuesta y muestras repetibles. Un flujo de trabajo de revisión puede necesitar texto limpio o Markdown. Un flujo de trabajo de cumplimiento o control de calidad puede necesitar capturas de pantalla o PDFs que preserven cómo apareció una página pública en un momento dado.
| Tipo de página pública | Señales a inspeccionar | Salida útil | Uso posterior |
|---|---|---|---|
| Página de perfil o marca | Texto de biografía, enlaces públicos, publicaciones visibles, secciones de página, metadatos | HTML, Markdown, captura de pantalla | Revisar estado de origen y alimentar analizadores personalizados |
| Página de publicación | Subtítulo, contexto de medios, marca de tiempo, diseño de página pública, URL canónica | HTML, texto, captura de pantalla, PDF | Archivar evidencia o comparar cambios en contenido público |
| Página de mención o tema | Tarjetas visibles, paginación, filtros, fragmentos públicos, enlaces de origen | HTML renderizado, metadatos JSON | Construir muestras de monitoreo específicas |
| Página de campaña | Mensaje, estado creativo, contexto de destino, capturas de pantalla, fechas | Markdown, captura de pantalla, PDF | Apoyar control de calidad de marketing y revisión de auditoría |
| Superficie social dinámica | Tarjetas renderizadas por el cliente, medios cargados de forma diferida, estados de consentimiento, estructuras vacías | HTML renderizado y captura de pantalla | Decidir si la ejecución en el navegador cambia la evidencia |
Los equipos obtienen mejores resultados cuando definen las señales públicas visibles antes de escalar. Si el flujo de trabajo solo necesita contenido legible, una salida visual pesada puede ser innecesaria. Si el flujo de trabajo necesita prueba de la apariencia de la página, una captura de pantalla puede ser más valiosa que otro campo de analizador.
¿Cuándo deben los equipos usar renderizado en el navegador para páginas sociales?
Muchas páginas sociales públicas son pesadas en JavaScript, pero eso no significa que cada solicitud deba comenzar con un navegador. El mejor primer paso es comparar la respuesta de origen con el estado renderizado. Si el HTML en bruto ya contiene el contenido que tu analizador necesita, una solicitud simple es más rápida, más fácil de depurar y generalmente más asequible.
Habilita renderizado de JavaScript cuando la ejecución en el navegador cambie el resultado capturado: las publicaciones visibles aparecen solo después de que se ejecute el código del lado del cliente, las tarjetas de medios se cargan de forma diferida, el estado de consentimiento o región cambia la respuesta, o la captura de pantalla debe mostrar el mismo estado de página pública que un revisor vería en un navegador.
El renderizado debe ser tratado como una opción de captura precisa. Está disponible cuando el contenido público necesita ejecución en el navegador, no como un impuesto predeterminado en cada URL social. Esto mantiene los experimentos pequeños y da a los flujos de trabajo de producción una razón más clara para cada perfil de solicitud más pesado.
¿Qué formato de respuesta se ajusta a la captura de páginas sociales?
La elección del formato afecta la calidad del flujo de trabajo posterior. HTML preserva la estructura para analizadores personalizados. Texto y Markdown son más fáciles para revisión, búsqueda, resumir y flujos de trabajo de conocimiento interno. Los metadatos JSON ayudan a los equipos a registrar estado, URL final, tipo de contenido, tiempo y contexto de solicitud. Capturas de pantalla y PDFs preservan prueba visual cuando la presentación del contenido es importante.
Para revisión de IA y editorial, Markdown puede ser más fácil de inspeccionar que el marcado en bruto. Para monitoreo, HTML más metadatos puede ser más útil porque el sistema puede comparar la estructura DOM, URLs canónicas, códigos de estado y tamaño de respuesta. Para cumplimiento o control de calidad de campaña, capturas de pantalla o PDFs crean un artefacto revisable que el texto solo no puede reemplazar.
El patrón más seguro es probar algunas URLs públicas representativas en el API Builder, comparar formatos y elegir la salida más pequeña que el producto pueda usar de inmediato. La página de formatos de respuesta es útil cuando el equipo necesita un marco de decisión de formato más amplio.
¿Cómo puede el scraping social mantenerse responsable y predecible?
El scraping social responsable comienza con el alcance. Mantente en páginas públicas, respeta las reglas de destino, evita reclamaciones de cuentas privadas y mantén la capa de captura separada de enriquecimiento sensible o perfilado de usuarios. ScraperFly brinda a los equipos controles de solicitud y formatos de salida; no decide si una fuente debe ser utilizada, cómo debe clasificarse el contenido o qué acción comercial debe seguir.
La predictibilidad también importa. Las páginas sociales pueden volverse costosas si cada solicitud utiliza renderizado, capturas de pantalla, PDFs, enrutamiento premium, sesiones y paginación amplia por defecto. Comienza con un pequeño conjunto de páginas públicas representativas, inspecciona fallos y agrega controles más pesados solo cuando la evidencia de respuesta muestra que mejoran la captura.
| Punto de decisión | Buen predeterminado | Cuándo agregar más |
|---|---|---|
| Alcance de acceso | Páginas públicas y evidencia visible solamente | Revisar permisos y reglas de destino antes de expandir la cobertura de origen |
| Renderizado | Comenzar con HTML de origen | Habilitar cuando el contenido esté construido en el navegador o el estado visual importe |
| Formato de salida | Elegir la respuesta útil más pequeña | Agregar capturas de pantalla o PDFs para revisión, archivo o prueba de apariencia de página |
| Controles de entrega | Mantener el primer perfil ligero | Agregar esperas, encabezados, sesiones, enrutamiento por país o entrega más fuerte cuando la evidencia lo respalde |
| Modelo de costo | Usar créditos gratuitos y pagar por uso para pruebas desiguales | Mover monitoreo recurrente a créditos mensuales cuando el volumen sea predecible |
Ese enfoque escalonado es exactamente donde ScraperFly es más fuerte. Los equipos pueden comenzar gratis, probar el objetivo real, mantener experimentos únicos flexibles y usar precios que mapean el peso de la solicitud a los controles habilitados en lugar de forzar cada flujo de trabajo social a una suscripción antes de que haya demostrado su valor.









































