






Renderizado de React
Compara el HTML fuente con la salida renderizada antes de raspar la aplicación
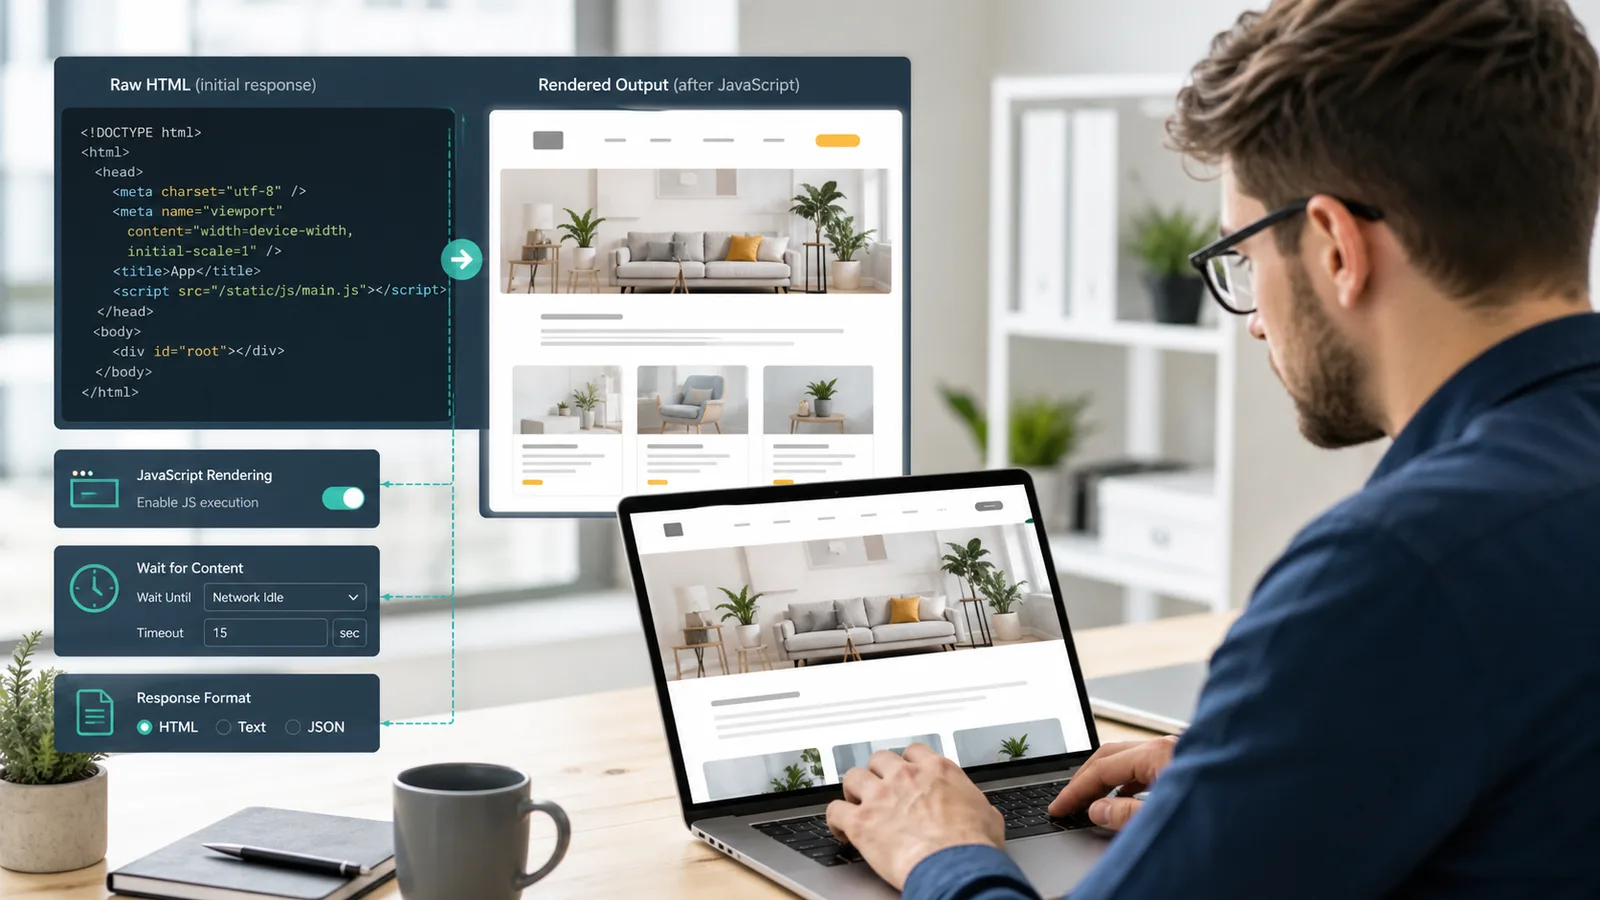
Los sitios web de React pueden parecer completos en un navegador mientras que la primera respuesta HTML contiene solo un pequeño contenedor de la aplicación. ScraperFly ayuda a los equipos a demostrar esa diferencia antes de construir la lógica del analizador, los trabajadores de la cola o la infraestructura del navegador alrededor de la respuesta incorrecta.
Comienza con el HTML fuente, inspecciona lo que realmente devuelve el objetivo, luego habilita el renderizado del navegador, esperas, sesiones, encabezados, enrutamiento por país o salida visual solo cuando la página de React renderizada proporciona mejores evidencias para tu flujo de trabajo.
¿Por qué son diferentes los sitios web de React para raspar?
Los sitios web de React a menudo separan la primera respuesta del servidor de la página que un usuario finalmente ve. El HTML fuente puede contener un elemento raíz, etiquetas de script, metadatos de ruta, datos de hidratación o un pequeño marcador de posición. Las útiles tarjetas de producto, secciones de artículos, resultados de búsqueda, precios, tablas, reseñas, filtros o contenido de perfil pueden aparecer solo después de que JavaScript se ejecute en el navegador.
Eso no significa que cada página de React necesite el perfil de raspado más pesado. Algunas aplicaciones de React aún exponen metadatos útiles, estado incrustado, contenido renderizado en el servidor o cargas útiles estructuradas en la respuesta inicial. Otras necesitan HTML renderizado porque el contenido se construye del lado del cliente. El flujo de trabajo práctico es comparar ambos estados antes de decidir cómo se debe capturar la página.
Conclusión práctica: El raspado de React debe comenzar con evidencia, no con suposiciones sobre si la página necesita un navegador.
¿Qué deberías inspeccionar antes de renderizar una página de React?
La primera verificación es la respuesta fuente. Busca el contenido útil, no solo un código de estado exitoso. Una respuesta 200 aún puede ser un contenedor vacío si la página espera que el navegador obtenga datos, hidrate componentes y construya el DOM final. Inspecciona el cuerpo, el tamaño de la respuesta, las cargas útiles de script, los metadatos, la URL final y si los campos objetivo aparecen en el HTML que recibe tu analizador.
Si el HTML fuente ya contiene los campos que necesitas, mantén la solicitud simple. Si el HTML fuente carece del contenido útil, compara la salida renderizada. Si la salida renderizada cambia el DOM de manera significativa, el renderizado está justificado. Si la salida renderizada sigue estando vacía, el problema puede ser el tiempo, el enrutamiento, los recursos bloqueados, una ruta incorrecta, contenido público no disponible o una página que requiere un flujo de trabajo diferente.
| Señal de React | Qué significa | Mejor siguiente paso |
|---|---|---|
| El HTML fuente contiene contenido objetivo | La página probablemente se puede capturar sin renderizado del navegador | Usa una solicitud HTML ligera y construye el analizador a partir de la evidencia fuente. |
| El HTML fuente es principalmente un elemento raíz y scripts | La página probablemente construye contenido útil en el navegador | Prueba el HTML renderizado antes de escribir la lógica de extracción. |
| El DOM renderizado contiene los campos objetivo | La ejecución de JavaScript cambia el resultado del raspado | Usa renderizado para este tipo de página y registra por qué es necesario. |
| La página renderizada sigue incompleta | El problema puede ser el tiempo, el contexto de la solicitud, el enrutamiento o el comportamiento del objetivo | Inspecciona el tiempo de espera, el estado, la URL final, el tamaño de la respuesta y la prueba visual. |
| La página visual difiere por región o estado | La ruta puede depender de la ubicación, cookies, encabezados o continuidad de sesión | Agrega contexto deliberadamente en lugar de hacer que cada solicitud sea más pesada. |
¿Cuándo debería ScraperFly renderizar un sitio web de React?
Habilita el renderizado cuando el contenido público útil aparece después de que se ejecuta JavaScript del lado del cliente. Ejemplos comunes incluyen cuadrículas de productos de React, resultados de búsqueda, paneles de control con datos públicos, páginas de artículos basadas en rutas, secciones perezosas, widgets de reseñas, bloques de precios, filtros y páginas donde la primera respuesta HTML contiene marcadores de posición en lugar del contenido final.
El renderizado debe ser preciso. No lo actives solo porque el sitio usa React; actívalo porque la respuesta en bruto no contiene lo que el flujo de trabajo necesita y la respuesta renderizada sí. Esto mantiene las páginas simples rápidas y asequibles mientras aún proporciona a las páginas construidas en el navegador el entorno que necesitan.
Para decisiones más amplias sobre la captura del navegador, utiliza la guía de la API de renderizado de JavaScript y la página de la API de raspado de navegador sin cabeza. Para objetivos de fuente primero, compara el enfoque de la API de raspado HTML antes de hacer que el renderizado sea el predeterminado.
¿Qué formato de salida funciona mejor después del renderizado de React?
El HTML renderizado es la mejor opción cuando tu analizador necesita el DOM final, selectores, atributos, enlaces, tablas, tarjetas de producto o contenido de ruta. El texto y Markdown son mejores cuando la página de React debe alimentar búsqueda, resúmenes, contexto de IA, revisión de documentación o ingestión RAG sin ruido de diseño. Los metadatos JSON son útiles para registrar evidencia de solicitudes. Las capturas de pantalla y los PDFs son útiles cuando un humano necesita verificar cómo se veía la página renderizada.
Esta elección debe hacerse antes de construir convertidores. Un raspado de React que alimenta un analizador puede necesitar HTML renderizado. Un raspado de React que alimenta un LLM puede ser mejor como Markdown. Un flujo de trabajo de monitoreo puede necesitar metadatos más una captura de pantalla. Un flujo de trabajo de cumplimiento o QA puede necesitar un PDF. ScraperFly permite que la solicitud devuelva la forma que el sistema posterior puede usar de inmediato.
| Flujo de trabajo de React | Salida a probar | Por qué ayuda | Cuándo evitarlo |
|---|---|---|---|
| Parámetros del DOM | HTML renderizado | Devuelve la página después de que React construye un marcado útil | Cuando el HTML fuente ya contiene los campos objetivo. |
| Ingesta de contenido | Texto o Markdown | Elimina gran parte del ruido de diseño antes de la búsqueda o el procesamiento de IA | Cuando los selectores exactos o las relaciones del DOM importan. |
| Diagnósticos | Metadatos JSON | Muestra estado, URL final, tipo de contenido, tamaño de respuesta y contexto de solicitud | Cuando el flujo de trabajo espera campos objetivo extraídos por sí mismo. |
| QA visual | Captura de pantalla | Confirma cómo se veía la página pública renderizada | Cuando el flujo de trabajo solo necesita texto legible por máquina. |
| Archivo o aprobación | Crea un registro portátil para revisión | Cuando el contenido necesita un análisis automatizado frecuente. |
¿Cómo deben manejarse las esperas, sesiones, encabezados y enrutamiento?
Las páginas de React pueden fallar por razones que parecen similares desde el exterior. Una página puede necesitar tiempo de espera adicional porque los datos se cargan después del renderizado inicial. Puede necesitar encabezados porque la ruta pública espera contexto de idioma o contenido. Puede necesitar sesiones porque las solicitudes relacionadas dependen de cookies o estado compartido. Puede necesitar enrutamiento por país porque el contenido cambia según la región, la moneda o la disponibilidad. Puede necesitar una entrega más fuerte cuando el camino simple devuelve repetidamente una salida inutilizable.
La respuesta correcta no es habilitar todo. Agrega un control a la vez y compara el resultado. Si una espera soluciona el contenido faltante, registra la razón del tiempo. Si las sesiones cambian la respuesta, mantenlas solo para ese flujo relacionado. Si la región cambia la página, mantén el enrutamiento por país vinculado al objetivo. Un flujo de trabajo de raspado de React es más fácil de operar cuando cada control habilitado tiene una razón visible.
Usa sesiones para flujos públicos con estado, encabezados personalizados para contexto de solicitud legítimo, y controles de enrutamiento cuando el camino de entrega cambia el resultado.
¿Qué fallos son comunes al raspar sitios web de React?
El fallo más común es tratar una respuesta fuente vacía como un bloque objetivo cuando en realidad es solo un contenedor normal de React. Otro fallo común es renderizar demasiado rápido y capturar la página antes de que los datos del lado del cliente terminen de cargarse. Los equipos también se encuentran con redireccionamientos de ruta, contenido que cambia por región, respuestas sobredimensionadas, datos públicos faltantes, opciones de salida no soportadas y flujos de trabajo que esperan que la API extraiga automáticamente el estado de la aplicación.
Un buen manejo de errores mantiene esos casos separados. Compara HTML fuente, HTML renderizado, estado de captura de pantalla, URL final, estado, tamaño de respuesta y tiempo de espera. Corrige entradas mal formadas y opciones no soportadas en lugar de volver a intentarlas. Reintenta fallos temporales con retroceso limitado. Escala el enrutamiento solo cuando la evidencia repetida muestra que el camino simple no es suficiente.
El bloque de manejo de errores a continuación proporciona un marco de fallo más amplio. Para las páginas de React, la clave es distinguir "el navegador aún no ha construido la página" de "el objetivo devolvió una mala página" y de "el perfil de solicitud es incorrecto."
¿Cómo puede el raspado de React mantenerse asequible?
El renderizado es poderoso, pero el trabajo del navegador es más pesado que una simple solicitud HTML. El costo se mantiene predecible cuando los equipos clasifican los objetivos antes de escalar: páginas HTML en bruto, páginas de React renderizadas, páginas que necesitan esperas, rutas regionales, flujos dependientes de sesiones, capturas de QA visual y archivos PDF. Cada clase debe tener su propio perfil de solicitud en lugar de heredar un costoso predeterminado.
Este es el camino práctico de ScraperFly. Comienza gratis, prueba páginas de React reales, mantén las capturas simples ligeras y usa controles más pesados solo donde cambien la respuesta. Un proyecto único puede mantenerse flexible con créditos, mientras que las cargas de trabajo renderizadas recurrentes pueden pasar a un plan mensual una vez que el perfil esté probado.
Revisa los precios después de muestrear objetivos reales, no antes. La estimación útil se basa en cuántas páginas realmente necesitan renderizado, esperas, salida visual, sesiones o entrega más fuerte.
¿Dónde debería comenzar un equipo?
Comienza en el API Builder con una URL pública de React. Solicita primero el HTML fuente. Si falta el contenido útil, habilita el renderizado y compara el resultado. Luego elige el formato de respuesta que tu flujo de trabajo puede usar: HTML renderizado para analizadores, texto o Markdown para contenido legible, metadatos JSON para diagnósticos, captura de pantalla o PDF para prueba visual.
Una vez que el perfil de solicitud esté probado, muévelo a cURL, Python, Node.js, una cola de backend, un trabajo de monitoreo o un flujo de trabajo de agente. Mantén el perfil explícito para que los futuros fallos puedan diagnosticarse a partir de evidencia en lugar de suposiciones.












