






Captura pronta para parser
Transforme páginas da web públicas em entradas utilizáveis para parser antes de construir a camada de extração
Um parser de conteúdo da web é tão bom quanto as evidências da página que recebe. Se a etapa de captura retornar uma estrutura vazia, a região errada, um redirecionamento, marcação barulhenta ou um formato que o próximo sistema não pode usar, o parser terá que adivinhar. Isso cria regras frágeis, falhas confusas e trabalho de limpeza que deveria ter sido evitado anteriormente.
ScraperFly oferece às equipes uma camada de captura prática antes que a análise comece. Busque páginas públicas, renderize JavaScript quando o conteúdo útil for construído pelo navegador, escolha HTML, texto, Markdown, metadados, captura de tela ou saída em PDF, e passe as evidências mais claras para seu próprio parser, fluxo de trabalho de IA, monitor, ferramenta de QA ou arquivo.
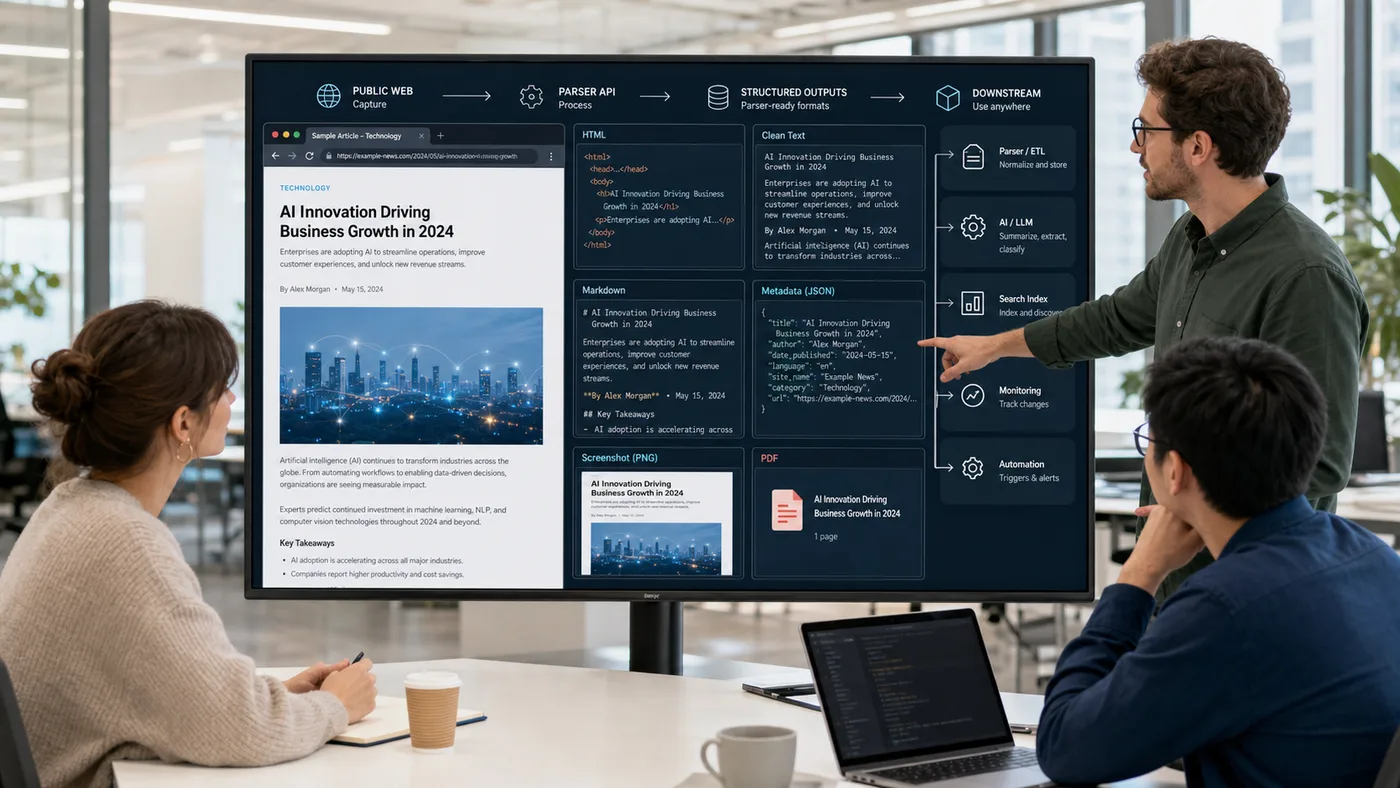
O que é uma API de parser de conteúdo da web?
Uma API de parser de conteúdo da web é um fluxo de trabalho de solicitação que captura uma página da web pública e retorna conteúdo em uma forma que outro sistema pode inspecionar, analisar, classificar, resumir, monitorar ou arquivar. A resposta pode ser HTML bruto, HTML renderizado, texto limpo, Markdown, metadados JSON, uma captura de tela, um PDF ou uma combinação de saídas que se encaixam no trabalho a ser realizado.
ScraperFly foca na camada de captura e formato de resposta. Sua aplicação continua responsável pela extração de campos, validação, modelos de conteúdo, classificação, armazenamento, deduplicação, alertas e lógica de negócios. Essa separação é útil porque as regras de análise são mais fáceis de construir quando a equipe vê primeiro evidências confiáveis da página.
Esta página é mais ampla do que uma simples API de URL para texto e menos restrita do que uma API de scraping de HTML. O ponto é a escolha do formato: dê ao parser, agente, índice de busca, monitor ou revisor a forma de resposta que reduz o trabalho de limpeza e evita suposições prematuras.
Qual formato de resposta deve alimentar um parser de conteúdo?
O melhor formato de resposta depende do que o parser precisa saber. HTML preserva seletores, atributos, links, tabelas e relacionamentos DOM. Texto limpo remove a marcação quando a legibilidade é mais importante do que a estrutura. Markdown mantém cabeçalhos, listas e links em um formato compacto que funciona bem para revisão, documentação e ingestão de IA. Metadados JSON fornecem contexto operacional em torno da solicitação. Capturas de tela e PDFs preservam a prova visual.
Escolher o formato errado cria fricção a montante. Enviar marcação bruta para um resumidor pode adicionar ruído. Enviar texto simples para um parser que precisa de seletores pode remover contexto crucial. Gerar capturas de tela para fluxos de trabalho apenas para máquinas adiciona peso sem melhorar a extração. Um bom fluxo de captura testa formatos antes que a lógica do parser se torne código de produção.
| Saída | Use quando | Valor principal | Compensação |
|---|---|---|---|
| HTML bruto | O parser precisa de seletores, atributos, links, tabelas ou estrutura | Preserva relacionamentos da página | Requer limpeza e parsing específico para o alvo |
| HTML renderizado | Conteúdo útil aparece apenas após a execução do JavaScript do lado do navegador | Captura o estado da página construída pelo navegador | Mais pesado do que a captura de HTML fonte |
| Texto | A próxima etapa precisa de conteúdo legível sem marcação de layout | Compacto e fácil de pesquisar ou classificar | Remove a maior parte do contexto estrutural |
| Markdown | Fluxos de trabalho de IA, RAG, revisão ou documentação se beneficiam de cabeçalhos e links | Preserva a estrutura de leitura útil | Não é ideal para extração específica de DOM |
| Metadados JSON | Logs, monitores e parsers precisam de contexto da solicitação | Mostra status, URL final, tipo de conteúdo, tempo e tamanho | Não substitui extração personalizada |
| Captura de tela ou PDF | Fluxos de trabalho de revisão, QA, conformidade ou arquivamento precisam de evidência visual | Preserva a aparência da página | Menos conveniente para parsing de máquina |
Use o guia de formatos de resposta quando a equipe precisar de uma comparação mais profunda antes de escolher uma saída de produção.
Quando a renderização de JavaScript pertence a um fluxo de trabalho de parser?
A renderização é útil quando o HTML fonte não é suficiente. Muitas páginas públicas enviam uma estrutura fina e, em seguida, constroem corpos de artigo, cartões de produto, comentários, tabelas ou estados de navegação após a execução do código do lado do navegador. Um parser que vê apenas a resposta inicial pode perder completamente o conteúdo ou construir regras em torno de espaços reservados em vez do estado real da página.
A renderização ainda deve ser deliberada. Comece com HTML fonte, inspecione a resposta e ative a API de renderização de JavaScript apenas quando a execução do navegador mudar o conteúdo útil. Isso mantém alvos simples leves e reserva trabalhos mais pesados do navegador para páginas que provam que precisam disso.
Para equipes de parser, a comparação mais valiosa é entre evidências brutas e renderizadas. Se ambas as respostas contêm o mesmo conteúdo útil, mantenha o perfil mais barato. Se o HTML renderizado incluir os campos, cartões ou conteúdo do corpo que o parser precisa, capture o estado renderizado e registre por que esse controle faz parte do perfil de origem.
Como o ScraperFly se encaixa na lógica de extração personalizada?
ScraperFly captura páginas públicas e retorna formatos de resposta. Não substitui seu modelo de extração, design de esquema, correspondência de entidades, classificador, estratégia de crawler, banco de dados ou fluxo de trabalho editorial. Esse limite mantém a plataforma honesta e dá às equipes de engenharia controle sobre o que o conteúdo significa dentro de seu produto.
Um fluxo de trabalho típico começa com URLs públicas representativas no API Builder. A equipe compara HTML fonte, HTML renderizado, texto, Markdown, metadados, capturas de tela ou PDFs. Uma vez que a forma da resposta é comprovada, a aplicação escreve regras de parser, modelos de prompt, verificações de validação ou lógica de monitoramento contra o formato que melhor se adapta ao trabalho.
Isso é especialmente útil para fontes de conteúdo misto. Um artigo de notícias, página de produto, página de documentação, listagem de mercado, tópico de fórum e página de revisão podem exigir diferentes lógicas de parsing. ScraperFly oferece a essas fontes uma superfície de captura consistente enquanto sua aplicação mantém a inteligência específica da fonte.
Como as equipes podem manter a análise de conteúdo da web previsível?
Projetos de parsing se tornam caros quando cada página recebe o perfil de solicitação mais pesado antes que a equipe saiba o que o alvo precisa. Renderização de navegador, roteamento premium, sessões, esperas, capturas de tela e PDFs têm seu lugar, mas devem estar ligados a evidências.
| Decisão | Bom padrão | Escalar quando |
|---|---|---|
| Captura inicial | Comece com HTML fonte | A resposta está vazia, incompleta ou faltando conteúdo útil |
| Formato | Escolha a saída utilizável menor | O parser ou revisor a montante precisa de mais estrutura ou prova |
| Renderização | Mantenha a execução do navegador desligada por padrão | JavaScript cria o conteúdo que o parser precisa |
| Arquivos visuais | Evite para parsing apenas de máquina | QA, auditoria, monitoramento ou revisão humana precisam da aparência da página |
| Controles de roteamento | Use o caminho normal primeiro | Status, redirecionamentos, comportamento regional ou falhas de entrega mostram uma necessidade |
O modelo de preços do ScraperFly suporta essa abordagem em etapas. Comece com créditos gratuitos, teste alvos reais, use pagamento conforme o uso enquanto a mistura de fontes for desigual e mova a captura recorrente para créditos mensais quando o volume e o peso da solicitação forem comprovados. A página de Preços ajuda as equipes a conectar controles de solicitação ao custo antes de escalar.










