






Link-Beweise zuerst
Erfassen Sie den Zustand der öffentlichen Seite, bevor Ihr Link-Parser entscheidet, was verfolgt werden soll
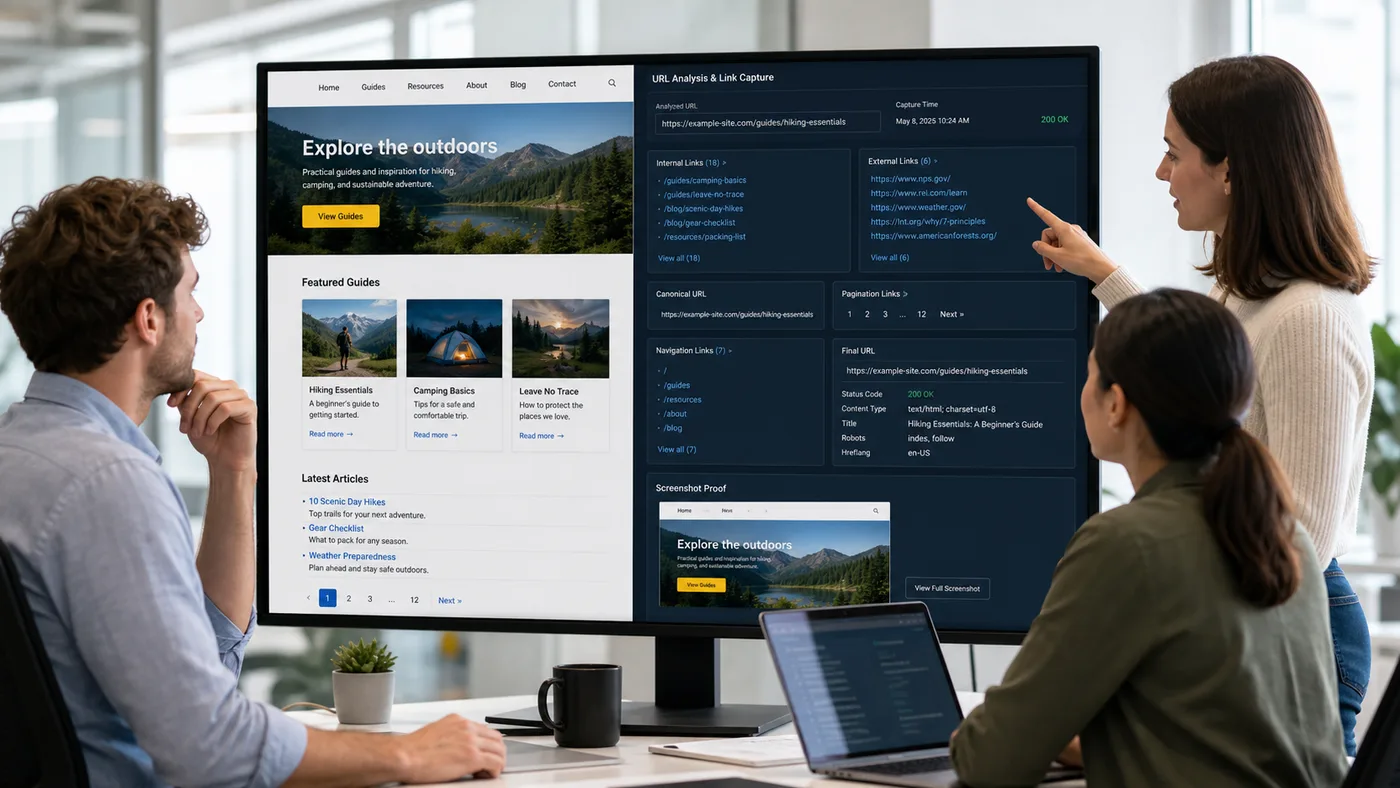
Link-Parsing klingt einfach, bis die Zielseite die Beweise ändert. Die Navigation kann serverseitig gerendert oder im Browser erstellt werden, kanonische URLs können von der angeforderten URL abweichen, die Paginierung kann hinter JavaScript verborgen sein, und öffentliche Seiten können interne Links, externe Referenzen, Medienlinks, hreflang, Robots-Hinweise und Weiterleitungen in einer Antwort mischen.
ScraperFly bietet Teams eine zuverlässige Erfassungsschicht für diese Seitenbeweise. Holen Sie sich öffentliche Seiten als rohes oder gerendertes HTML, behalten Sie die Antwortmetadaten, bewahren Sie visuelle Beweise auf, wenn QA sie benötigt, und lassen Sie Ihren eigenen Parser entscheiden, welche Links extrahiert, normalisiert, gecrawlt, bewertet oder ignoriert werden sollen.
Was ist eine Webseite-Link-Parser-API?
Eine Webseite-Link-Parser-API ist ein Workflow, der eine öffentliche Seite erfasst und genügend Quellbeweise zurückgibt, damit nachgelagerter Code Links inspizieren kann. Das kann rohes HTML, gerendertes HTML, Metadaten zur finalen URL, Status, Inhaltstyp, Antwortgröße, Screenshots, PDFs und andere Kontexte umfassen, die einem Parser helfen, zu entscheiden, was auf der Seite vorhanden ist.
Der Parser selbst bleibt Ihre Produktlogik. ScraperFly ersetzt nicht die Crawl-Planung, Link-Bewertung, SEO-Audits, URL-Normalisierung, Duplikatsvermeidung, Sitemap-Entscheidungen oder Geschäftsregeln. Es gibt dem Parser eine sauberere Eingabeschicht, sodass diese Entscheidungen auf dem basieren, was die öffentliche Seite tatsächlich zurückgegeben hat.
Diese Absicht ist enger gefasst als eine allgemeine Webinhalt-Parser-API. Der Fokus liegt auf Link-Beweisen: Anker, Navigation, kanonische Links, Paginierung, hreflang, externe Referenzen und das Verhalten der finalen URL, das die Entdeckung, QA, Überwachung oder interne Tools beeinflussen kann.
Welche Links und URL-Signale sollten Teams inspizieren?
Ein nützlicher Link-Parser sollte nicht jeden href als gleich bedeutend behandeln. Navigationslinks, Paginierung, kanonische URLs, hreflang-Alternativen, interne Inhaltslinks, ausgehende Referenzen, Medienlinks, script-erstellte Links und umgeleitete finale URLs tragen alle unterschiedliche Signale. Es ist wichtig, sie aus dem richtigen Seitenzustand zu erfassen.
Definieren Sie vor der Skalierung, welche Linkklassen Ihr Workflow benötigt. Ein SEO-QA-Tool könnte sich um kanonische Links, hreflang, Weiterleitungen und crawlbare Navigation kümmern. Eine Inhaltsentdeckungs-Pipeline könnte sich um Artikel-Links und Paginierung kümmern. Ein Überwachungs-Workflow könnte sich darum kümmern, ob ein wichtiger öffentlicher Link von einer gerenderten Seite verschwunden ist.
| Signal | Warum es wichtig ist | Beste Erfassungsbeweise | Nachgelagerte Entscheidung |
|---|---|---|---|
| Interne Links | Offenbaren Navigation, Entdeckungswege, verwandte Inhalte und Seitenstruktur | HTML oder gerendertes HTML | Extrahieren, normalisieren, duplizieren oder in die Warteschlange stellen |
| Externe Links | Zeigen Referenzen, Zitationen, Partner, Einbettungen und ausgehende Abhängigkeiten | HTML plus finale URL-Metadaten | Klassifizieren, verifizieren oder überwachen |
| Kanonische URL | Kann von der angeforderten URL abweichen und die Handhabung von Duplikaten beeinflussen | HTML-Kopf und Antwortmetadaten | Datensätze normalisieren und doppelte Seiten vermeiden |
| Paginierungslinks | Steuern, ob ein Workflow die nächsten Ergebnisseiten entdecken kann | HTML, gerendertes HTML, Screenshot-Beweis | Crawl-Bereich sorgfältig aufbauen |
| Hreflang- und regionale Links | Offenbaren Sprach- oder regionale Alternativen | HTML-Kopf, finale URL, länderbewusste Proben | Locale-Abdeckung oder regionale Varianten abbilden |
| Weiterleitung und finale URL | Zeigt das tatsächliche Ziel, nachdem das Zielverhalten angewendet wurde | JSON-Metadaten und Statusbeweise | Routing, Kanonisierung und Linkqualität debuggen |
Die stärksten Link-Workflows speichern sowohl die Linkliste als auch den Erfassungs-Kontext. Wenn ein Parser ein unerwartetes Ergebnis produziert, helfen Status, finale URL, Inhaltstyp, Antwortgröße, Quell-HTML und gerenderter Zustand zu erklären, ob das Problem auf der Seite, im Anforderungsprofil oder in der Extraktionsregel liegt.
Wann sollte das Link-Parsing gerendertes HTML verwenden?
Viele öffentliche Seiten zeigen immer noch nützliche Links im Quell-HTML. In diesen Fällen ist rohes HTML das schnellste und praktischste Erfassungsformat. Aber einige Seiten erstellen Navigation, Produktgitter, unendliches Scrollen, verwandte Links oder Paginierung, nachdem JavaScript auf der Client-Seite ausgeführt wurde. Ein Parser, der nur das Quell-HTML sieht, könnte diese Links verpassen oder Platzhalter für echte Seitenbeweise halten.
Verwenden Sie JavaScript-Rendering, wenn das nützliche Link-Set nur im browserseitig erstellten Seitenzustand erscheint. Vergleichen Sie rohe und gerenderte Antworten, bevor Sie sich für ein schwereres Anforderungsprofil entscheiden. Wenn das Rendering die Links, die Ihr Parser benötigt, nicht ändert, halten Sie die Anfrage leicht.
Visuelle Ausgaben können ebenfalls hilfreich sein. Screenshots oder PDFs sind nicht die beste Quelle für maschinelle Extraktion, aber sie sind nützlich, wenn QA beweisen muss, dass ein Navigationsbereich, ein Paginierungssteuerungselement, ein Linkmodul oder ein Seitenzustand zum Zeitpunkt der Erfassung vorhanden war.
Wie unterstützt ScraperFly SEO QA und Crawl-Planung?
ScraperFly kann SEO QA unterstützen, indem es die öffentlichen Quellseiten erfasst, die nachgelagerte Tools inspizieren. Die API kann HTML für die Link-Extraktion, Metadaten für Status- und finale URL-Überprüfungen, gerenderte Ausgaben für JavaScript-erstellte Navigation und Screenshots zur Überprüfung bereitstellen. Ihr eigener Workflow besitzt weiterhin Crawl-Regeln, Bewertung, Berichterstattung, Priorisierung von Problemen und Remediation-Logik.
Diese Grenze hält die Seite ehrlich und nützlich. Ein Link-Parser kann ScraperFly verwenden, um zuverlässige Proben zu sammeln, und dann Links nach Typ, Tiefe, Ziel, Vorlage, Sprache oder Quellabschnitt klassifizieren. Ein Überwachungs-Workflow kann vergleichen, ob wichtige Links weiterhin vorhanden sind. Ein QA-Tool kann Screenshot-Beweise bewahren, wenn sich eine öffentliche Seite ändert.
Verwenden Sie den API Builder, um eine repräsentative URL zu testen, rohe und gerenderte HTML zu vergleichen, Metadaten zu inspizieren und zu entscheiden, ob der Link-Parser einfaches HTML, Rendering, Header, Sitzungen, Länder-Routing oder visuelle Dateien benötigt, bevor die Zielgröße skaliert wird.
Wie kann das Link-Parsing vorhersehbar und erschwinglich bleiben?
Die Link-Extraktion kann teuer werden, wenn jede Seite wie eine komplexe gerenderte Anwendung behandelt wird. Die meisten Teams sollten mit einfacher HTML-Erfassung beginnen, nachweisen, welche Links vorhanden sind, und dann schwerere Kontrollen nur hinzufügen, wenn die Antwortbeweise zeigen, dass sie das Link-Set oder den Debug-Wert verbessern.
| Entscheidung | Guter Standard | Escalate when |
|---|---|---|
| Erfassungsformat | Roh-HTML für Anker-Extraktion | Gerendertes HTML ändert Navigation, Paginierung oder Link-Module |
| Metadaten | Behalten Sie Status, finale URL, Inhaltstyp und Größe | Debuggen Sie Weiterleitungen, kanonische Links oder inkonsistente Proben |
| Visueller Beweis | Überspringen für maschinenbasierte Link-Extraktion | QA benötigt Beweise, dass ein Linkbereich visuell erschienen ist |
| Routing-Kontrollen | Verwenden Sie zuerst den Standardpfad | Standort, Sprache, Zugriff oder Weiterleitungen ändern öffentliche Seitenlinks |
| Kostenmodell | Verwenden Sie kostenlose Credits und Pay-as-you-go während des Testens | Verschieben Sie wiederkehrende Link-Überwachung auf monatliche Credits, wenn das Volumen bekannt ist |
ScraperFly's flexibles Abrechnungsmodell ist hier nützlich, da das Link-Parsing oft als exploratives Projekt beginnt. Testen Sie einige Vorlagen, halten Sie einfache Seiten leicht, fügen Sie Rendering oder visuelle Beweise nur dort hinzu, wo es wichtig ist, und verwenden Sie die Preise-Seite, um das Anfragegewicht zu schätzen, bevor die wiederkehrende Überwachung beginnt.










