






ScraperFlyAPI веб-данных для AI

developer api

API парсера веб-контента для захвата публичных страниц

ScraperFly помогает командам захватывать публичные веб-страницы в форматах ответов, готовых к парсингу, прежде чем их собственные процессы извлечения, ИИ, поиска, мониторинга, контроля качества или архивирования определят, что означает контент.

Готовый к парсингу захват

Преобразуйте публичные веб-страницы в удобные для парсера входные данные перед созданием слоя извлечения

Парсер веб-контента хорош настолько, насколько хороши доказательства страницы, которые он получает. Если шаг захвата возвращает пустую оболочку, неправильный регион, перенаправление, шумный разметку или формат, который следующая система не может использовать, парсер должен догадываться. Это создает хрупкие правила, запутанные ошибки и работу по очистке, которую следовало бы избежать ранее.

ScraperFly предоставляет командам практический слой захвата перед началом парсинга. Получайте публичные страницы, рендерите JavaScript, когда полезный контент создается в браузере, выбирайте HTML, текст, Markdown, метаданные, скриншоты или PDF-вывод, и передавайте самые четкие доказательства в ваш собственный парсер, AI-рабочий процесс, монитор, инструмент QA или архив.
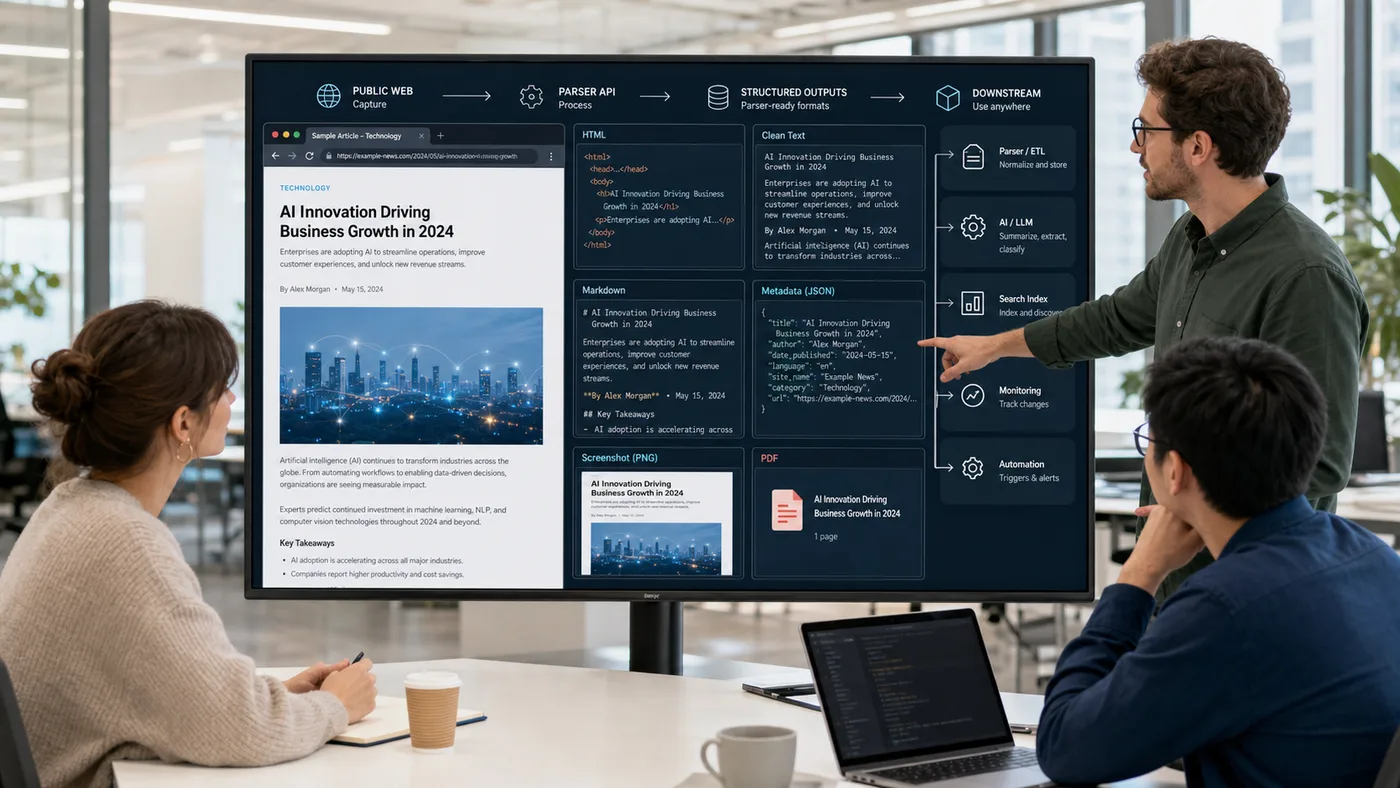
HTML Markdown метаданные визуальное доказательство
Команда рассматривает результаты захвата публичного веб-контента для парсера и AI-рабочих процессов

Что такое API парсера веб-контента?

API парсера веб-контента — это рабочий процесс запроса, который захватывает публичную веб-страницу и возвращает контент в форме, которую другая система может проверять, парсить, классифицировать, обобщать, мониторить или архивировать. Ответ может быть сырым HTML, отрендеренным HTML, чистым текстом, Markdown, JSON-метаданными, скриншотом, PDF или комбинацией выводов, которые подходят для последующей работы.

ScraperFly сосредоточен на слое захвата и формата ответа. Ваше приложение остается ответственным за извлечение полей, валидацию, модели контента, классификацию, хранение, дедупликацию, оповещения и бизнес-логику. Это разделение полезно, потому что правила парсинга легче строить, когда команда сначала видит надежные доказательства страницы.

Эта страница шире, чем простой API URL в текст и уже, чем API HTML-скрапинга. Суть в выборе формата: дайте парсеру, агенту, поисковому индексу, монитору или рецензенту форму ответа, которая уменьшает работу по очистке и избегает преждевременных предположений.

Практическое замечание: рассматривайте ScraperFly как слой захвата публичной страницы, а затем позвольте вашему собственному парсеру решать, как извлекать и моделировать контент.

Какой формат ответа должен подаваться парсеру контента?

Лучший формат ответа зависит от того, что парсеру нужно знать. HTML сохраняет селекторы, атрибуты, ссылки, таблицы и отношения DOM. Чистый текст удаляет разметку, когда читаемость важнее структуры. Markdown сохраняет заголовки, списки и ссылки в компактном формате, который хорошо подходит для обзора, документации и ввода AI. JSON-метаданные предоставляют операционный контекст вокруг запроса. Скриншоты и PDF сохраняют визуальные доказательства.

Выбор неправильного формата создает трение на downstream. Отправка сырой разметки в резюмер может добавить шум. Отправка простого текста в парсер, которому нужны селекторы, может удалить важный контекст. Генерация скриншотов для машинных рабочих процессов добавляет вес без улучшения извлечения. Хороший рабочий процесс захвата тестирует форматы до того, как логика парсинга станет производственным кодом.

ВыводИспользуйте, когдаОсновная ценностьКомпромисс
Сырой HTMLПарсеру нужны селекторы, атрибуты, ссылки, таблицы или структураСохраняет отношения страницыТребует очистки и парсинга, специфичного для цели
Отрендеренный HTMLПолезный контент появляется только после выполнения JavaScript на стороне браузераФиксирует состояние страницы, созданное браузеромТяжелее, чем захват исходного HTML
ТекстСледующий шаг требует читаемого контента без разметки макетаКомпактный и легкий для поиска или классификацииУдаляет большую часть структурного контекста
MarkdownAI, RAG, обзор или рабочие процессы документации выигрывают от заголовков и ссылокСохраняет полезную структуру чтенияНе идеален для извлечения, специфичного для DOM
JSON-метаданныеЖурналы, мониторы и парсеры нуждаются в контексте запросаПоказывает статус, финальный URL, тип контента, время и размерНе заменяет пользовательское извлечение
Скриншот или PDFОбзор, QA, соблюдение или архивные рабочие процессы нуждаются в визуальных доказательствахСохраняет внешний вид страницыМенее удобно для машинного парсинга

Используйте руководство по форматам ответа, когда команде нужно более глубокое сравнение перед выбором производственного вывода.

Когда рендеринг JavaScript должен быть в рабочем процессе парсера?

Рендеринг полезен, когда исходного HTML недостаточно. Многие публичные страницы отправляют тонкую оболочку, а затем создают тела статей, карточки продуктов, комментарии, таблицы или состояния навигации после выполнения кода на стороне браузера. Парсер, который видит только начальный ответ, может полностью пропустить контент или построить правила вокруг заполнителей вместо реального состояния страницы.

Рендеринг все еще должен быть целенаправленным. Начните с исходного HTML, проверьте ответ и включите API рендеринга JavaScript только тогда, когда выполнение браузера изменяет полезный контент. Это сохраняет простые цели легкими и оставляет более тяжелую работу браузера для страниц, которые доказывают, что они в этом нуждаются.

Для команд парсеров наиболее ценное сравнение — это сырые против отрендеренных доказательств. Если оба ответа содержат один и тот же полезный контент, сохраняйте более дешевый профиль. Если отрендеренный HTML включает поля, карточки или содержимое тела, которое нужно парсеру, захватывайте отрендеренное состояние и записывайте, почему этот контроль является частью исходного профиля.

Практическое замечание: делайте рендеринг решением на уровне источника на основе доказательств ответа, а не настройкой по умолчанию для каждого запроса парсера контента.

Как ScraperFly вписывается в пользовательскую логику извлечения?

ScraperFly захватывает публичные страницы и возвращает форматы ответа. Он не заменяет вашу модель извлечения, проектирование схемы, сопоставление сущностей, классификатор, стратегию краулера, базу данных или редакционный рабочий процесс. Эта граница сохраняет честность платформы и дает инженерным командам контроль над тем, что контент означает внутри их продукта.

Типичный рабочий процесс начинается с представительных публичных URL в API Builder. Команда сравнивает исходный HTML, отрендеренный HTML, текст, Markdown, метаданные, скриншоты или PDF. Как только форма ответа доказана, приложение пишет правила парсера, шаблоны подсказок, проверки валидации или логику мониторинга против формата, который лучше всего соответствует задаче.

Это особенно полезно для смешанных источников контента. Новостная статья, страница продукта, страница документации, листинг на рынке, тема форума и страница отзыва могут требовать различной логики парсинга. ScraperFly предоставляет этим источникам единый слой захвата, в то время как ваше приложение сохраняет специфическую для источника информацию.

Как команды могут поддерживать предсказуемость парсинга веб-контента?

Проекты парсинга становятся дорогими, когда каждая страница получает самый тяжелый профиль запроса, прежде чем команда узнает, что нужно цели. Рендеринг браузера, премиум маршрутизация, сессии, ожидания, скриншоты и PDF все имеют свое место, но они должны быть связаны с доказательствами.

РешениеХороший по умолчаниюЭскалировать, когда
Первоначальный захватНачните с исходного HTMLОтвет пустой, неполный или отсутствует полезный контент
ФорматВыберите самый маленький полезный выводПарсер или рецензент на downstream нуждается в большей структуре или доказательствах
РендерингДержите выполнение браузера выключенным по умолчаниюJavaScript создает контент, который нужен парсеру
Визуальные файлыПропустите для машинного парсингаQA, аудит, мониторинг или человеческий обзор нуждаются в внешнем виде страницы
Контроль маршрутизацииСначала используйте нормальный путьСтатус, перенаправления, поведение региона или сбои доставки показывают необходимость

Модель ценообразования ScraperFly поддерживает этот поэтапный подход. Начните с бесплатных кредитов, протестируйте реальные цели, используйте оплату по мере использования, пока смесь источников неравномерна, и переходите к регулярному захвату на месячные кредиты, когда объем и вес запроса доказаны. Страница Цены помогает командам связать контроль запросов с затратами перед масштабированием.


Практическое замечание: предсказуемый парсинг начинается с легкого профиля захвата, четких доказательств ответа и форматов, выбранных вокруг downstream-потребителя.

Рабочий процесс парсера

Создайте запрос захвата перед тем, как писать логику парсера

Используйте API Builder для тестирования представительных публичных URL, сравнения сырого и отрендеренного вывода, выбора HTML, текста, Markdown, JSON-метаданных, скриншота или PDF и копирования проверенной формы запроса в ваш парсер, AI, мониторинг или рабочий процесс QA.

01
01

Сохраняйте структуру страницы

Используйте HTML, когда селекторы, атрибуты, таблицы, ссылки или отношения DOM важны для вашего парсера.

02
02

Снижайте шум контента

Используйте текст или Markdown, когда downstream-система нуждается в читаемом контенте, а не в сырой разметке.

03
03

Сохраняйте визуальные доказательства

Используйте скриншоты или PDF, когда QA, мониторинг, аудит или рабочие процессы обзора нуждаются в внешнем виде страницы.

Полезные управляющие элементы запроса парсера

url

Целевая страница для получения, рендеринга, очистки или захвата.

format

Выберите ответ, который нужен вашему продукту: html, text, markdown, json, скриншот или pdf.

premium

Эскалируйте на более сильные маршруты для блокировок, нестабильных целей или контента, чувствительного к геолокации.

render

Запустите Chromium для SPA, JS-вставленного разметки, скриншотов, PDF и страниц только для браузера.

country

Запросите маршрут, специфичный для страны, когда контент меняется в зависимости от местоположения.

keep_headers

Перенаправьте выбранный контекст запроса, такой как user-agent, cookie, язык и referer.

render_wait

Дайте динамическому контенту контролируемую дополнительную задержку перед извлечением или захватом.

download

Возвращайте визуальные артефакты в виде загружаемых файлов, когда вывод - это скриншот или PDF.

пример cURL

Генерируйте Markdown с той же формой запроса, которую вы можете использовать в производстве

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Планирование парсера

Проверьте целевую страницу перед тем, как привязываться к модели извлечения

Парсер должен строиться вокруг ответа, который фактически возвращает цель. Проверьте, содержит ли исходный HTML полезный контент, изменяет ли рендеринг состояние страницы, какой формат вывода нужен downstream-системе и какие метаданные или визуальные доказательства должны быть сохранены для отладки.

Сырой HTML-ответ, сопоставленный с видимыми данными страницы
01

Доступность сырого HTML

Проверьте, присутствуют ли необходимые вам поля уже в первом HTML-ответе.

Лучший первый тест для простых страниц, статей, документов, списков и деталей продуктов.

Сравнение до и после рендеринга JavaScript
02

Зависимость от JavaScript

Сравните сырой HTML с отрендеренным DOM или скриншотом перед включением рендеринга браузера.

Используйте рендеринг, когда сырой HTML является лишь оболочкой, а скрипты создают полезный контент.

Cookies, согласие, контекст сессии и доступа для скрапинга
03

Состояние и контекст доступа

Определите, влияют ли cookies, согласие, границы входа, пагинация или состояние одного и того же посетителя на ответ.

Используйте сессии и заголовки, когда непрерывность изменяет данные, которые вы получаете.

Региональные вариации контента по странам и маршрутам
04

Гео/вариация контента

Проверьте, изменяет ли страна, язык, валюта, запасы, SERP, реклама или репутация маршрута результат.

Используйте гео- или премиум-маршрутизацию только тогда, когда цель подтверждает, что ответ варьируется в зависимости от маршрута.

Вопросы перед масштабированием парсинга контента

Где находится целевое поле?

Узнайте, существует ли поле в сыром HTML, отрендеренном DOM, вызове API, структурированных данных, файле или состоянии взаимодействия позже.

Что изменяет ответ?

Выберите несколько URL-адресов и сравните статус, конечный URL, длину контента, перенаправления, пустые состояния и различия в видимых результатах.

Какой контекст необходим?

Отметьте любую зависимость от согласия, локали, файлов cookie, заголовков, границ аутентификации, пагинации, фильтров или предыдущих запросов.

Как выглядит неудача?

Определите сигналы для заблокированных, частичных, устаревших, перенаправленных, пустых, истекших или несоответствующих регионам ответов перед масштабированием.

Настройка цели парсера

Режим получения

Доступность сырого HTML определяет, может ли первый запрос оставаться простым или требует рендеринга, ожиданий, скриншотов или извлечения.

Контекст запроса

Требования состояния определяют, нужно ли добавлять заголовки, файлы cookie, сессии, обработку согласия или стабильный профиль посетителя.

Выбор маршрута

Гео и репутационные данные определяют, достаточно ли стандартного маршрута или оправдан ли маршрут по стране/премиум.

Правила валидации

Известные состояния неудачи становятся проверками для повторных попыток, эскалации, проверки качества и решения о том, когда более легкий профиль все еще полный.

Лучшие входные данные для парсера.

Выбирайте ScraperFly, когда вам нужно зафиксировать доказательства перед предположениями парсера.

Многие инструменты для скрапинга упрощают получение URL, но усложняют выбор, какая форма ответа подходит для парсера. ScraperFly предлагает командам практический путь: начните бесплатно, исследуйте реальные цели, держите простые страницы легкими, добавляйте рендеринг или маршрутизацию только когда это полезно, и возвращайте формат, который ваш последующий рабочий процесс может использовать немедленно.

Счастливая команда, проверяющая проект на ноутбуке
01 / Начните легко

Легкий, бесплатный старт перед любым давлением по оплате

ScraperFly дает вам возможность сначала протестировать реальную цель. Используйте бесплатные кредиты, чтобы проверить, работает ли страница, присутствуют ли данные и какие элементы управления действительно нужны, прежде чем вы потратите деньги на план. Это делает первый эксперимент легким: никаких закупочных циклов, никакой принудительной подписки, никаких предположений о вашем месячном объеме в первый день.

Бесплатные кредитыНет карты для первых тестовПроверяйте перед масштабированием
Улыбающийся профессионал, успешно работающий с ноутбуком
02 / Тратьте разумно

Доступная, гибкая оплата за реальный объем скрапинга

Не каждая нагрузка для скрапинга представляет собой аккуратную месячную кривую. Некоторые проекты резко возрастают, некоторые приостанавливаются, а некоторые становятся регулярными только после того, как данные докажут свою ценность. ScraperFly поддерживает эту реальность с помощью модели оплаты по мере использования и ежемесячных кредитных планов, когда стабильный объем имеет смысл. Вы можете купить то, что вам нужно, держать расходы под контролем и избежать превращения небольшого теста в чрезмерную подписку.

Оплата по мере использованияЕжемесячно, когда это полезноКонтроль затрат
Разработчик, подготавливающий структурированный вывод с ноутбука
03 / Доставка быстрее

Предварительная обработка ответа, которая убирает работу по очистке

Дешевый запрос недостаточен, если вашей команде все еще нужно создавать конвертеры, очистители, скриншоты, захват PDF и форматирование, готовое для LLM. ScraperFly может вернуть ответ в формате HTML, чистого текста, Markdown, структурированного JSON, PDF или изображения, так что ваш конвейер приближается к конечному активу за один запрос. Меньше кода склеивания, меньше движущихся частей, более быстрая доставка.

HTMLТекстMarkdownJSONPDFИзображение

Где ScraperFly помогает командам парсинга контента.

Сравните решения по захвату в отношении доказательств, выбора формата, веса запроса и ясности отладки, вместо того чтобы рассматривать каждую страницу как одинаковый вход для парсера.

Точка принятия решенияПреимущество ScraperFlyТипичный компромисс конкурента
Первый экспериментНачните с бесплатных кредитов и проверьте реальную цель перед расходами. Вы можете доказать, нужны ли на самом деле сырой HTML, рендеринг, премиум маршрутизация или таргетинг по странам.Тестовые версии часто быстро подталкивают вас к подписке или скрывают истинную стоимость, пока дополнительные функции не войдут в запрос.
Модель биллингаИспользуйте кредиты по мере необходимости для нерегулярной работы, затем переходите на ежемесячные кредиты только тогда, когда объем работы станет предсказуемым. Это делает небольшие тесты и проектный скрапинг доступными.Многие инструменты оптимизированы под ежемесячные подписки, фиксированные лимиты или уровни, которые могут казаться тяжелыми, прежде чем объем будет доказан.
Вес запросаДержите простые страницы простыми. Включайте рендеринг JavaScript, премиум маршрутизацию, сессии, заголовки, ожидания или маршрутизацию по странам только тогда, когда доказательства ответа говорят, что это важно.Сравнимые элементы управления могут существовать, но они часто объединены в более высокие уровни, по умолчанию или более сложные ценовые профили.
Форматы выводаВозвращайте ответ в формате, который нужен вашему продукту: HTML для парсеров, текст или Markdown для контентных потоков, JSON для структурированных метаданных и PDF/изображение для визуального доказательства.Некоторые провайдеры сосредотачиваются в основном на доступе и оставляют форматирование, захват, очистку и подготовку на вашем собственном коде.
Рабочий процесс разработчикаОдна API поверхность может охватывать тестирование целей, эскалацию, рендеринг, маршрутизацию, сессии, заголовки, форматирование ответов и проверки статуса. Путь от прототипа до производства остается компактным.Инструменты с приоритетом прокси, рынки актеров и платформы для краулеров могут быть мощными, но часто требуют больше связующего кода или более тяжелой операционной модели.
Лучшее соответствиеКоманды, которые хотят практической доставки веб-данных: начните с малого, измеряйте стоимость за полезный результат и масштабируйте только те элементы управления, которые улучшают результат.Команды с фиксированными контрактами на большой объем, кастомной прокси-инфраструктурой или широкими потребностями в краулинге рынка могут предпочесть более специализированную платформу.

Контроль затрат

Сохраняйте доступность парсинга контента, сопоставляя вес запроса с доказательствами.

Не каждый вход для парсера требует рендеринга в браузере, скриншотов, PDF, сессий или премиум-доставки. ScraperFly поддерживает поэтапный путь: начните с бесплатных кредитов, проверьте реальные страницы, используйте оплату по мере использования, пока источники неравномерны, и переходите к регулярному захвату на месячные кредиты, когда смесь целей будет доказана.

Легкий HTML-запрос, возвращающий простой ответ
01

Базовый запрос

Используйте базовый запрос, когда публичный HTML уже содержит необходимые вам поля.

Самый легкий профиль запроса; сохраняйте его, когда ответ завершен.

Рендеринг JavaScript, создающий полный DOM
02

Рендеринг

Используйте рендеринг, когда сырой HTML является оболочкой, а JavaScript завершает страницу.

Более тяжелый профиль; используйте его только когда вывод браузера изменяет результат.

Несколько запросов с сохранением cookies и состояния посетителя
03

Состояние сессии

Используйте сессии, когда cookies, согласие, локализация или пагинация изменяют ответ.

Более тяжелый профиль состояния; сохраняйте его только когда важна непрерывность.

Маршрутизация запросов через гео и более качественные маршруты
04

Премиум маршрутизация и гео

Используйте премиум маршрутизацию или гео только когда источник, страна, репутация или региональный контент изменяют результат.

Самый тяжелый профиль маршрутизации; применяйте его только к целям, которые доказывают, что они в этом нуждаются.

Драйверы стоимости запросов парсера.

Больше инфраструктурной работы

Рендеринг в браузере, выбор маршрутов и более длительное ожидание означают, что платформе нужно делать больше, чем просто возвращать простой ответ.

Больше неопределенности цели

Перенаправления, пустые состояния, ограничения по скорости и страницы с вызовами часто требуют более сильных вариантов доставки или повторных попыток.

Больше состояния для сохранения

Cookies, сессии, согласие и многостраничные потоки добавляют движущиеся части, которых нет у простого безстатусного запроса.

Больше доказательств для возврата

Скриншоты, PDF-файлы, отрендеренный вывод и более богатые артефакты ответа полезны, но они тяжелее, чем простой HTML.

Контроль, который должен заслужить свое место

Протестируйте перед масштабированием

Сначала протестируйте небольшой набор URL и группируйте цели по самому легкому профилю, который возвращает полные данные.

Не рендерить по умолчанию

Проверьте сырой HTML перед включением рендеринга. Многие публичные страницы уже содержат необходимые вам данные.

Эскалируйте по фактам

Переходите на более высокий уровень только когда ответ показывает отсутствие контента, зависимость состояния, гео-вариации или проблемы с маршрутизацией.

Измеряйте полезные результаты

Оптимизируйте на основе действительных записей, а не объема сырых запросов. Более легкий профиль лучше всего, только когда он остается полным.

Часто задаваемые вопросы по парсеру

Распространенные вопросы о парсинге веб-контента с помощью ScraperFly.

Практичные ответы для команд, превращающих публичные страницы в входные данные, готовые для парсера, без чрезмерных заявлений о автоматическом извлечении, нормализации схемы или логике краулера.

Быстрые ответы

Сравнение захвата и извлечения

Где ScraperFly вписывается в стек парсера.

Пишет ли ScraperFly мои правила парсера?

Нет. ScraperFly захватывает публичные страницы и возвращает форматы ответов. Ваше приложение отвечает за правила извлечения, валидацию, нормализацию и хранение.

Может ли он заменить полный краулер?

Нет. ScraperFly обрабатывает захват запросов. Планирование обхода, стратегия обнаружения, дедупликация и оповещения относятся к downstream.

Выбор входных данных парсера

Сопоставьте форму ответа с потребителем.

Должен ли я парсить HTML или Markdown?

Используйте HTML, когда важны селекторы и структура. Используйте Markdown, когда читаемые заголовки, списки и ссылки лучше подходят для обзора или рабочих процессов ИИ.

Для чего полезны метаданные?

Метаданные помогают журналам и мониторингу понимать статус, конечный URL, тип контента, время, размер ответа и контекст запроса.

Страницы JavaScript

Используйте выполнение в браузере только тогда, когда это изменяет результат.

Когда мне следует включить рендеринг?

Включите рендеринг, когда полезный публичный контент отсутствует в исходном HTML и появляется после выполнения JavaScript на стороне браузера.

Должен ли каждый запрос парсера рендериться?

Нет. Начните с исходного HTML и добавляйте рендеринг в зависимости от цели, когда доказательства ответа подтверждают это как необходимое.

Стоимость и надежность

Держите профили запросов практичными.

Как мне контролировать затраты на парсер?

Используйте самый легкий вывод, который работает, добавляйте более тяжелые контролы только тогда, когда они улучшают ответ, и оставляйте скриншоты или PDF для записей, которые требуют доказательства.

Как мне отладить плохой ввод парсера?

Сравните статус, конечный URL, тип контента, размер ответа, исходный HTML, отрендеренный вывод и образец возвращаемого формата перед изменением правил парсера.








