






ScraperFlyAPI веб-даних для AI

developer api

API для парсингу веб-контенту для захоплення публічних сторінок

ScraperFly допомагає командам захоплювати публічні веб-сторінки у форматах, готових до парсингу, перш ніж їх власні процеси екстракції, ШІ, пошуку, моніторингу, контролю якості або архівування вирішать, що означає контент.

Готовий до парсера захоплення

Перетворіть публічні веб-сторінки на придатні для парсера дані перед створенням шару витягування

Парсер веб-контенту є таким же хорошим, як і свідчення сторінки, які він отримує. Якщо етап захоплення повертає порожню оболонку, неправильний регіон, перенаправлення, шумний розмітку або формат, який наступна система не може використовувати, парсер змушений здогадуватися. Це створює крихкі правила, заплутані збої та роботу з очищення, яку слід було уникнути раніше.

ScraperFly надає командам практичний шар захоплення перед початком парсингу. Отримуйте публічні сторінки, рендеріть JavaScript, коли корисний контент створюється браузером, вибирайте HTML, текст, Markdown, метадані, скріншот або PDF-формат, і передавайте найчіткіші свідчення у ваш власний парсер, AI-робочий процес, монітор, QA-інструмент або архів.
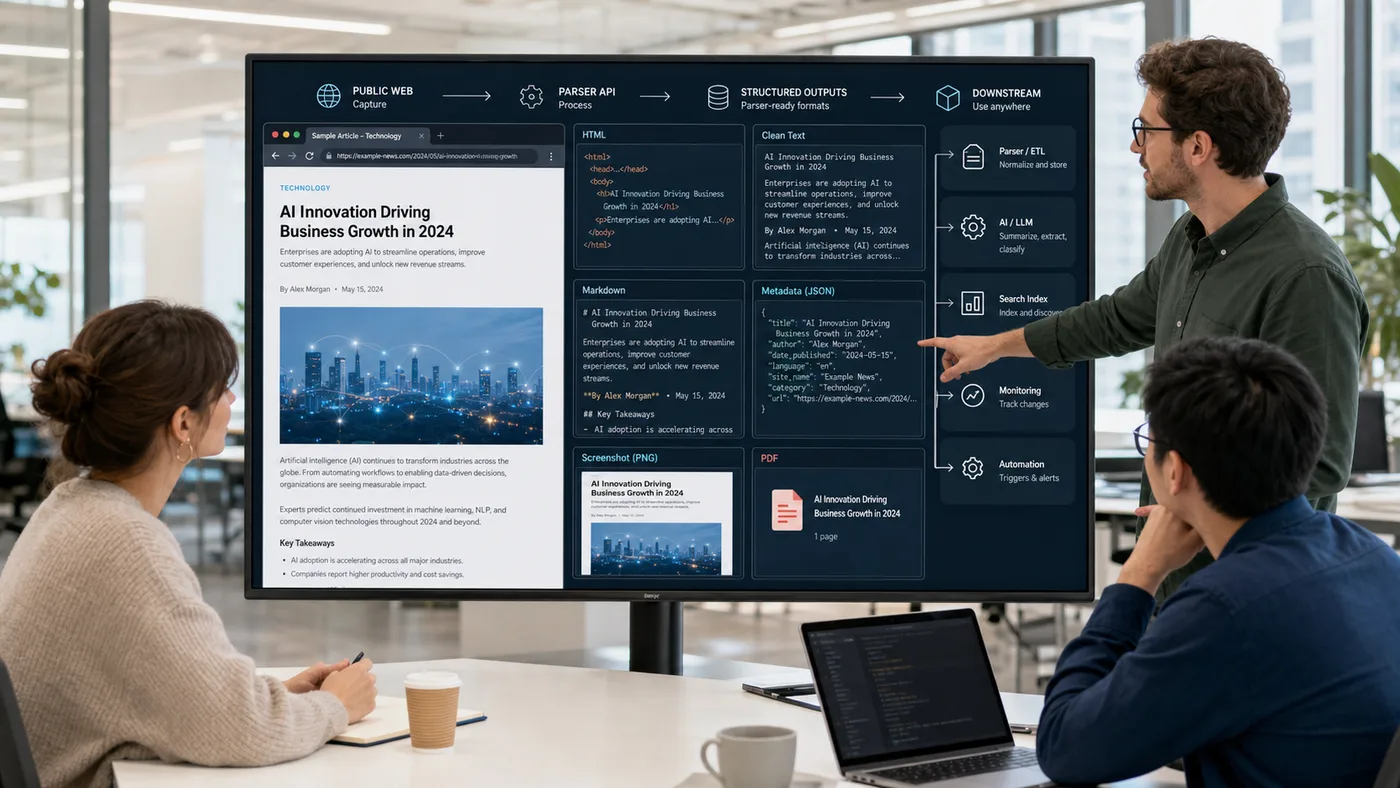
HTML Markdown метадані візуальне підтвердження
Команда переглядає результати захоплення публічного веб-контенту для парсера та AI-робочих процесів

Що таке API парсера веб-контенту?

API парсера веб-контенту - це робочий процес запитів, який захоплює публічну веб-сторінку та повертає контент у формі, яку інша система може перевірити, парсити, класифікувати, узагальнювати, моніторити або архівувати. Відповідь може бути сирим HTML, рендереним HTML, чистим текстом, Markdown, JSON-метаданими, скріншотом, PDF або комбінацією виходів, які підходять для подальшої роботи.

ScraperFly зосереджується на шарі захоплення та формату відповіді. Ваша програма залишається відповідальною за витягування полів, валідацію, моделі контенту, класифікацію, зберігання, дедуплікацію, сповіщення та бізнес-логіку. Це розділення корисне, оскільки правила парсингу легше будувати, коли команда спочатку бачить надійні свідчення сторінки.

Ця сторінка є ширшою, ніж простий URL до текстового API і менш вузькою, ніж HTML scraping API. Суть полягає у виборі формату: надайте парсеру, агенту, пошуковому індексу, монітору або рецензенту форму відповіді, яка зменшує роботу з очищення та уникає передчасних припущень.

Практичний висновок: розглядайте ScraperFly як шар захоплення публічних сторінок, а потім дайте вашому власному парсеру вирішити, як витягувати та моделювати контент.

Який формат відповіді слід використовувати для парсера контенту?

Найкращий формат відповіді залежить від того, що парсеру потрібно знати. HTML зберігає селектори, атрибути, посилання, таблиці та відносини DOM. Чистий текст видаляє розмітку, коли читабельність важливіша за структуру. Markdown зберігає заголовки, списки та посилання в компактному форматі, який добре підходить для перегляду, документації та споживання AI. JSON-метадані надають оперативний контекст навколо запиту. Скріншоти та PDF зберігають візуальне підтвердження.

Вибір неправильного формату створює тертя в подальшій роботі. Відправка сирої розмітки до узагальнювача може додати шуму. Відправка простого тексту до парсера, якому потрібні селектори, може видалити важливий контекст. Генерація скріншотів для машинних робочих процесів додає вагу без покращення витягування. Хороший робочий процес захоплення тестує формати перед тим, як логіка парсингу стане виробничим кодом.

ВихідВикористовуйте, колиОсновна цінністьКомпроміс
Сирий HTMLПарсеру потрібні селектори, атрибути, посилання, таблиці або структураЗберігає відносини сторінкиВимагає очищення та специфічного парсингу
Рендерений HTMLКорисний контент з'являється лише після виконання JavaScript на стороні браузераЗахоплює стан сторінки, створеної браузеромВажчий, ніж захоплення вихідного HTML
ТекстНаступний крок потребує читабельного контенту без розмітки макетаКомпактний і легкий для пошуку або класифікаціїВидаляє більшість структурного контексту
MarkdownAI, RAG, робочі процеси перегляду або документації виграють від заголовків і посиланьЗберігає корисну структуру читанняНе ідеально для специфічного витягування з DOM
JSON-метаданіЖурнали, монітори та парсери потребують контексту запитуПоказує статус, фінальне URL, тип контенту, час та розмірНе замінює спеціальне витягування
Скріншот або PDFРобочі процеси перегляду, QA, аудиту або рецензування потребують візуальних доказівЗберігає зовнішній вигляд сторінкиМенш зручний для машинного парсингу

Використовуйте посібник з форматів відповіді, коли команді потрібне глибше порівняння перед вибором виробничого виходу.

Коли рендеринг JavaScript належить до робочого процесу парсера?

Рендеринг корисний, коли вихідний HTML недостатній. Багато публічних сторінок надсилають тонку оболонку, а потім створюють тіла статей, картки продуктів, коментарі, таблиці або стани навігації після виконання коду на стороні браузера. Парсер, який бачить лише початкову відповідь, може зовсім пропустити контент або створити правила навколо заповнювачів замість реального стану сторінки.

Рендеринг все ще повинен бути свідомим. Почніть з вихідного HTML, перевірте відповідь і активуйте API рендерингу JavaScript лише тоді, коли виконання браузера змінює корисний контент. Це дозволяє зберегти прості цілі легкими і залишити важчу роботу браузера для сторінок, які доводять, що їм це потрібно.

Для команд парсерів найцінніше порівняння - це сирі та рендерені свідчення. Якщо обидві відповіді містять один і той же корисний контент, зберігайте дешевший профіль. Якщо рендерений HTML включає поля, картки або контент тіла, які потрібні парсеру, захоплюйте рендерений стан і зафіксуйте, чому цей контроль є частиною вихідного профілю.

Практичний висновок: зробіть рендеринг рішенням на рівні виходу на основі свідчень відповіді, а не стандартним налаштуванням для кожного запиту парсера контенту.

Як ScraperFly вписується в логіку спеціального витягування?

ScraperFly захоплює публічні сторінки та повертає формати відповіді. Він не замінює вашу модель витягування, проектування схеми, зіставлення сутностей, класифікатор, стратегію краулера, базу даних або редакційний робочий процес. Ця межа зберігає платформу чесною і надає інженерним командам контроль над тим, що означає контент всередині їх продукту.

Типовий робочий процес починається з репрезентативних публічних URL у API Builder. Команда порівнює вихідний HTML, рендерений HTML, текст, Markdown, метадані, скріншоти або PDF. Як тільки форма відповіді доведена, програма пише правила парсера, шаблони запитів, перевірки валідації або логіку моніторингу проти формату, який найкраще відповідає завданню.

Це особливо корисно для змішаних джерел контенту. Новинна стаття, сторінка продукту, сторінка документації, оголошення на ринку, тема форуму та сторінка відгуків можуть вимагати різної логіки парсингу. ScraperFly надає цим джерелам послідовну поверхню захоплення, в той час як ваша програма зберігає специфічний для джерела інтелект.

Як команди можуть зберегти парсинг веб-контенту передбачуваним?

Проекти парсингу стають дорогими, коли кожна сторінка отримує найважчий профіль запиту, перш ніж команда дізнається, що потрібно цілі. Рендеринг браузера, преміум маршрутизація, сесії, затримки, скріншоти та PDF мають своє місце, але вони повинні бути пов'язані зі свідченнями.

РішенняДобре за замовчуваннямЕскалувати, коли
Початкове захопленняПочніть з вихідного HTMLВідповідь порожня, неповна або відсутній корисний контент
ФорматВиберіть найменший придатний вихідПарсер або рецензент потребує більше структури або доказів
РендерингТримайте виконання браузера вимкненим за замовчуваннямJavaScript створює контент, який потрібен парсеру
Візуальні файлиПропустіть для машинного парсингуQA, аудит, моніторинг або людський перегляд потребують зовнішнього вигляду сторінки
Контроль маршрутизаціїСпочатку використовуйте нормальний шляхСтатус, перенаправлення, поведінка регіону або збої доставки показують потребу

Модель ціноутворення ScraperFly підтримує цей поетапний підхід. Почніть з безкоштовних кредитів, протестуйте реальні цілі, використовуйте оплату за фактом, поки змішання джерел нерівномірне, і перемістіть повторюване захоплення на місячні кредити, коли обсяг і вага запиту доведені. Сторінка Ціни допомагає командам пов'язати контроль запитів з витратами перед масштабуванням.


Практичний висновок: передбачуваний парсинг починається з легкого профілю захоплення, чітких свідчень відповіді та форматів, вибраних навколо споживача на наступному етапі.

Робочий процес парсера

Створіть запит на захоплення перед тим, як писати логіку парсера

Використовуйте API Builder для тестування репрезентативних публічних URL, порівняння сирого та рендереного виходу, вибору HTML, тексту, Markdown, JSON-метаданих, скріншота або PDF, і копіюйте перевірену форму запиту у ваш парсер, AI, моніторинг або QA-робочий процес.

01
01

Зберігайте структуру сторінки

Використовуйте HTML, коли селектори, атрибути, таблиці, посилання або відносини DOM важливі для вашого парсера.

02
02

Зменшуйте шум контенту

Використовуйте текст або Markdown, коли наступна система потребує читабельного контенту, а не сирої розмітки.

03
03

Зберігайте візуальне підтвердження

Використовуйте скріншоти або PDF, коли QA, моніторинг, аудит або робочі процеси перегляду потребують зовнішнього вигляду сторінки.

Корисні контролі запиту парсера

url

Цільова сторінка для отримання, рендерингу, очищення або захоплення.

format

Виберіть відповідь, яка потрібна вашому продукту: html, text, markdown, json, screenshot або pdf.

premium

Ескалюйте до сильнішого маршруту для блокувань, нестабільних цілей або контенту, чутливого до геолокації.

render

Запустіть Chromium для SPA, JS-інжектованого розмітки, скриншотів, PDF та сторінок тільки для браузера.

country

Запросіть маршрут, специфічний для країни, коли контент змінюється в залежності від місця.

keep_headers

Пересилайте вибраний контекст запиту, такий як user-agent, cookie, мова та referer.

render_wait

Надайте динамічному контенту контрольовану додаткову затримку перед витягуванням або захопленням.

download

Поверніть візуальні артефакти як завантажувані файли, коли вихід - це скриншот або PDF.

приклад cURL

Генеруйте Markdown з тією ж формою запиту, яку ви можете перенести в продукцію

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Планування парсера

Перевірте цільову сторінку перед тим, як зобов'язатися до моделі витягування

Парсер повинен бути побудований навколо відповіді, яку насправді повертає ціль. Перевірте, чи містить вихідний HTML корисний контент, чи змінює рендеринг стан сторінки, який формат виходу потрібен наступній системі, і які метадані або візуальні докази слід зберегти для налагодження.

Сирова HTML-відповідь, відображена на видимих даних сторінки
01

Доступність сирого HTML

Перевірте, чи поля, які вам потрібні, вже присутні в першій HTML-відповіді.

Найкращий перший тест для простих сторінок, статей, документів, списків та деталей продуктів.

Порівняння до і після рендерингу JavaScript
02

Залежність від JavaScript

Порівняйте сирий HTML з відрендереним DOM або скріншотом перед увімкненням рендерингу браузера.

Використовуйте рендеринг, коли сирий HTML є лише оболонкою, а скрипти створюють корисний контент.

Куки, згода, контекст сесії та доступу для скрапінгу
03

Стан і контекст доступу

Визначте, чи впливають куки, згода, межі входу, пагінація або той самий стан відвідувача на відповідь.

Використовуйте сесії та заголовки, коли безперервність змінює дані, які ви отримуєте.

Регіональні варіації контенту в різних країнах і маршрутах
04

Гео/варіація контенту

Перевірте, чи змінюють країна, мова, валюта, інвентар, SERP, реклама або репутація маршруту результат.

Використовуйте гео- або преміум-маршрути лише тоді, коли ціль підтверджує, що відповідь змінюється залежно від маршруту.

Запитання перед масштабуванням парсингу контенту

Де знаходиться цільове поле?

Знайдіть, чи існує поле в сирому HTML, відрендереному DOM, виклику API, структурованих даних, файлі або пізнішому стані взаємодії.

Що змінює відповідь?

Виберіть кілька URL-адрес і порівняйте статус, фінальну URL-адресу, довжину вмісту, перенаправлення, порожні стани та видимі відмінності результатів.

Який контекст потрібен?

Позначте будь-яку залежність від згоди, локалі, куків, заголовків, межі аутентифікації, пагінації, фільтрів або попередніх запитів.

Як виглядає невдача?

Визначте сигнали для заблокованих, часткових, застарілих, перенаправлених, порожніх, з тайм-аутом або регіонально невідповідних відповідей перед масштабуванням.

Налаштування цілі парсера

Режим отримання

Доступність сирого HTML визначає, чи може перший запит залишатися простим або потребує рендерингу, очікувань, скріншотів або витягування.

Контекст запиту

Вимоги до стану визначають, чи потрібно додавати заголовки, куки, сесії, обробку згоди або стабільний профіль відвідувача.

Вибір маршруту

Гео та репутаційні дані визначають, чи достатньо стандартного маршруту або виправданий маршрут країни/преміум.

Правила валідації

Відомі стани невдачі стають перевірками для повторних спроб, ескалації, перевірки якості та визначення, коли легший профіль все ще є повним.

Кращі вхідні дані для парсера

Виберіть ScraperFly, коли вам потрібно зафіксувати докази перед припущеннями парсера

Багато інструментів для збору даних спрощують отримання URL, але ускладнюють вибір, яка форма відповіді підходить для парсера. ScraperFly надає командам практичний шлях: почніть безкоштовно, перевірте реальні цілі, зберігайте прості сторінки легкими, додавайте рендеринг або маршрутизацію лише коли це корисно, і повертайте формат, який ваш робочий процес може використовувати відразу.

Щаслива команда, що перевіряє проект на ноутбуці
01 / Почніть легко

Легкий, безкоштовний старт перед будь-яким тиском з боку рахунків

ScraperFly дає вам можливість спочатку протестувати реальну ціль. Використовуйте безкоштовні кредити, щоб перевірити, чи працює сторінка, чи є дані, і які контролі насправді потрібні, перш ніж вкладати гроші в план. Це робить перший експеримент легким: без циклу закупівлі, без примусової підписки, без здогадок про ваш місячний обсяг з першого дня.

Безкоштовні кредитиБез картки для перших тестівПеревірте перед масштабуванням
Посміхаючий професіонал, який успішно працює з ноутбуком
02 / Витрачайте розумно

Доступне, гнучке виставлення рахунків для реального обсягу скрапінгу

Не кожне навантаження для скрапінгу є акуратною місячною кривою. Деякі проекти зростають, деякі призупиняються, а деякі стають регулярними лише після того, як дані доводять свою цінність. ScraperFly підтримує цю реальність з моделлю оплати за фактом використання плюс місячні кредитні плани, коли стабільний обсяг має сенс. Ви можете купити те, що вам потрібно, тримати витрати під контролем і уникнути перетворення маленького тесту на надмірну підписку.

Платіть за фактом використанняЩомісячно, коли це корисноКонтроль витрат
Розробник, що готує структурований вихід з ноутбука
03 / Доставляйте швидше

Попередня обробка відповіді, яка усуває роботу з очищення

Дешевий запит недостатній, якщо ваша команда все ще повинна створювати конвертери, очищувачі, скріншоти, захоплення PDF та форматування, готове для LLM. ScraperFly може повернути відповідь у форматі HTML, чистого тексту, Markdown, структурованого JSON, PDF або зображення, тому ваш конвеєр наближається до фінального активу в одному запиті. Менше коду для з'єднання, менше рухомих частин, швидша доставка.

HTMLТекстMarkdownJSONPDFЗображення

Де ScraperFly допомагає командам парсерів контенту

Порівняйте рішення щодо захоплення навколо доказів, вибору формату, ваги запиту та ясності налагодження, а не розглядайте кожну сторінку як однаковий вхід для парсера.

Точка прийняття рішенняПеревага ScraperFlyТиповий компроміс конкурентів
Перше експериментуванняПочніть з безкоштовних кредитів і перевірте реальну ціль перед витратами. Ви можете довести, чи потрібні насправді сирий HTML, рендеринг, преміум маршрутизація або цільова країна.Тести часто швидко підштовхують вас до підписки на регулярний план або приховують справжню вартість, поки додаткові послуги не потраплять у запит.
Модель білінгуВикористовуйте кредити за принципом "плати за те, що використовуєш" для нерівномірної роботи, а потім переходьте на місячні кредити лише тоді, коли обсяг роботи стане передбачуваним. Це робить невеликі тести та проектне скрапінг доступними.Багато інструментів оптимізовані під місячні підписки, фіксовані дозволи або рівневі обмеження, які можуть здаватися важкими, поки обсяг не буде доведено.
Вага запитуЗалишайте прості сторінки простими. Увімкніть рендеринг JavaScript, преміум маршрутизацію, сесії, заголовки, затримки або маршрутизацію за країною лише тоді, коли докази відповіді вказують на їх важливість.Порівнянні контролі можуть існувати, але їх часто об'єднують у вищі рівні, за замовчуванням або більш складні цінові профілі.
Формати виходуПоверніть відповідь у формі, яка потрібна вашому продукту: HTML для парсерів, текст або Markdown для контентних конвеєрів, JSON для структурованих метаданих та PDF/зображення для візуального підтвердження.Деякі постачальники зосереджуються переважно на доступі та залишають форматування, захоплення, очищення та підготовку до подальшої обробки на вашому власному коді.
Робочий процес розробникаОдна API поверхня може охоплювати тестування цілей, ескалацію, рендеринг, маршрутизацію, сесії, заголовки, форматування відповідей та перевірки статусу. Шлях від прототипу до виробництва залишається компактним.Інструменти з пріоритетом проксі, ринкові платформи акторів та платформи краулінгу можуть бути потужними, але часто вимагають більше коду "клею" або важчої моделі експлуатації.
Найкраще підходитьКоманди, які хочуть практичної доставки веб-даних: починайте з малого, вимірюйте вартість за корисний результат і масштабуйте лише ті контролі, які покращують результат.Команди з фіксованими контрактами на великий обсяг, спеціальною проксі-інфраструктурою або широкими потребами в краулінгу ринку можуть віддати перевагу більш спеціалізованій платформі.

Контроль витрат

Зберігайте парсинг контенту доступним, підбираючи вагу запиту до доказів

Не кожен вхід для парсера потребує рендерингу браузера, скріншотів, PDF, сесій або преміум-доставки. ScraperFly підтримує поетапний шлях: почніть з безкоштовних кредитів, перевірте реальні сторінки, використовуйте оплату за фактом, поки джерела нерівномірні, і переходьте до щомісячних кредитів для повторюваного захоплення, коли мікс цілей буде підтверджено.

Легкий HTML-запит, що повертає просту відповідь
01

Базовий запит

Використовуйте базовий запит, коли публічний HTML вже містить необхідні вам поля.

Найлегший профіль запиту; зберігайте його, коли відповідь завершена.

Рендеринг JavaScript, що створює повний DOM
02

Рендеринг

Використовуйте рендеринг, коли сирий HTML є оболонкою, а JavaScript завершує сторінку.

Важчий профіль; використовуйте його лише тоді, коли вихід браузера змінює результат.

Кілька запитів з збереженням куків та стану відвідувача
03

Станова сесія

Використовуйте сесії, коли куки, згода, локалізація або пагінація змінюють відповідь.

Важчий профіль стану; зберігайте його лише тоді, коли важлива безперервність.

Маршрутизація запитів через гео та маршрути вищої якості
04

Преміум маршрутизація та гео

Використовуйте преміум маршрутизацію або гео лише тоді, коли походження, країна, репутація або регіональний контент змінюють результат.

Найважчий профіль маршрутизації; застосовуйте його лише до цілей, які доводять, що вони його потребують.

Фактори вартості запиту парсера

Більше роботи з інфраструктурою

Рендеринг браузера, вибір маршрутизації та довші очікування означають, що платформа повинна виконувати більше, ніж просто повертати просту відповідь.

Більша невизначеність цілі

Редиректи, порожні стани, обмеження швидкості та сторінки викликів часто вимагають більш потужних варіантів доставки або повторних спроб.

Більше стану для збереження

Cookies, сесії, згода та багатосторінкові потоки додають рухомі частини, яких немає у простому безстатевому запиті.

Більше доказів для повернення

Скріншоти, PDF, рендерений вихід та багатші артефакти відповіді корисні, але вони важчі за простий HTML.

Контролі, які повинні заробити своє місце

Вибірка перед масштабуванням

Спочатку протестуйте невелику вибірку URL та групуйте цілі за найменшим профілем, який повертає повні дані.

Не рендерити за замовчуванням

Перевірте сирий HTML перед увімкненням рендерингу. Багато публічних сторінок вже містять необхідні вам дані.

Ескалація за доказами

Підвищуйте лише тоді, коли відповідь показує відсутній контент, залежність стану, гео варіацію або проблеми з маршрутизацією.

Вимірюйте корисні результати

Оптимізуйте навколо дійсних записів, що доставляються, а не сирого обсягу запитів. Легший профіль найкращий лише тоді, коли він залишається повним.

Часті запитання про парсер

Загальні питання про парсинг веб-контенту з ScraperFly

Практичні відповіді для команд, які перетворюють публічні сторінки на готові до парсера вхідні дані без надмірних заяв про автоматичне витягування, нормалізацію схем або логіку краулера.

Швидкі відповіді

Захоплення проти витягування

Де ScraperFly вписується в стек парсерів.

Чи пише ScraperFly мої правила парсера?

Ні. ScraperFly захоплює публічні сторінки та повертає формати відповідей. Ваша програма відповідає за правила витягування, валідацію, нормалізацію та зберігання.

Чи може він замінити повний краулер?

Ні. ScraperFly обробляє захоплення запитів. Планування краулінгу, стратегія виявлення, дедуплікація та сповіщення належать до нижнього рівня.

Вибір вхідних даних парсера

Відповідність форми відповіді споживачу.

Чи слід мені парсити HTML чи Markdown?

Використовуйте HTML, коли важливі селектори та структура. Використовуйте Markdown, коли читабельні заголовки, списки та посилання краще підходять для перегляду або робочих процесів AI.

Для чого корисні метадані?

Метадані допомагають журналам та моніторам зрозуміти статус, фінальне URL, тип контенту, час, розмір відповіді та контекст запиту.

Сторінки JavaScript

Використовуйте виконання в браузері лише тоді, коли це змінює результат.

Коли я повинен увімкнути рендеринг?

Увімкніть рендеринг, коли корисний публічний контент відсутній у вихідному HTML і з'являється після виконання JavaScript на стороні браузера.

Чи повинен кожен запит парсера рендерити?

Ні. Почніть з вихідного HTML і додайте рендеринг відповідно до цілі, коли докази відповіді підтверджують це.

Вартість та надійність

Тримайте профілі запитів практичними.

Як я можу контролювати витрати парсера?

Використовуйте найменший вихід, який працює, додавайте важчі контролі лише тоді, коли вони покращують відповідь, і залишайте скріншоти або PDF для записів, які потребують доказів.

Як мені налагодити поганий вхід парсера?

Порівняйте статус, фінальне URL, тип контенту, розмір відповіді, вихідний HTML, рендерений вихід і зразок повернутого формату перед зміною правил парсера.








