






MARKDOWN-AUSGABE
Öffentliche Seiten in Markdown umwandeln, die Ihre Pipeline tatsächlich lesen kann
ScraperFly bietet Teams einen praktischen Weg von einer öffentlichen URL zu sauberem Markdown. Anstatt rohen Seitenmarkup in einen AI-Prompt, ein Dokumentationstool, eine Inhaltsüberprüfung oder einen Suchindex zu senden, kann Ihre Anwendung eine Antwort anfordern, die nützliche Überschriften, Absätze, Listen und Links in einer lesbaren Form behält.
Der wichtige Teil ist die Kontrolle. Beginnen Sie mit einer leichten Anfrage, überprüfen Sie, was das Ziel zurückgibt, und aktivieren Sie dann die Browserdarstellung, Wartezeiten, Sitzungen, Header, Länderauswahl oder stärkere Routen nur, wenn diese Kontrollen das Markdown verbessern, das Ihr Workflow erhält.
Was ist eine Web-Seite zu Markdown API?
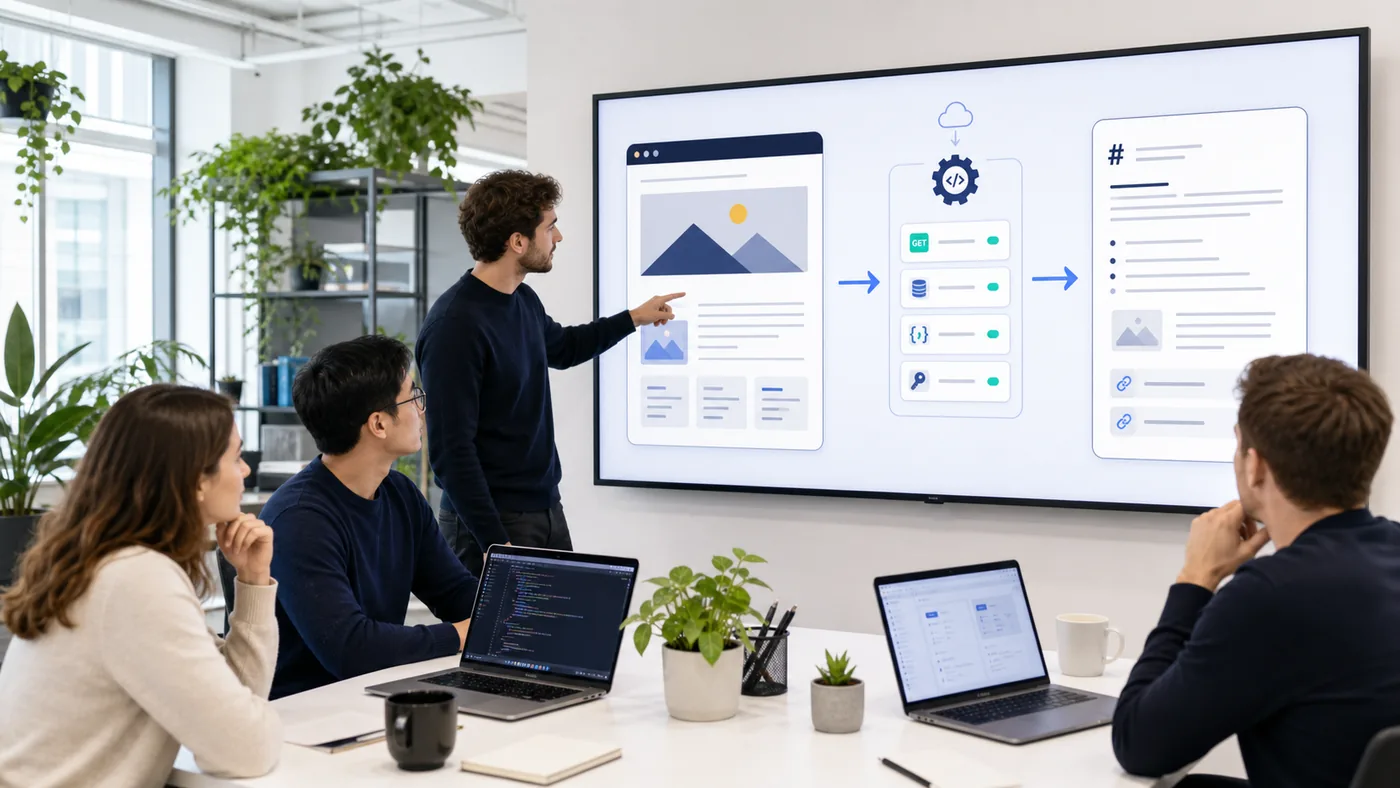
Eine Web-Seite zu Markdown API ruft eine öffentliche URL ab und gibt den erfassten Seiteninhalt als Markdown zurück. Die Antwort ist für Systeme gedacht, die lesbare Inhalte benötigen, anstatt Browser-Infrastruktur: RAG-Eingabe, AI-Agenten, interne Suche, redaktionelle Überprüfung, Dokumentationsimporte, Überwachungsnotizen und leichte Inhaltsanalysen.
Markdown ist nützlich, weil es zwischen rohem HTML und einfachem Text sitzt. Es kann Überschriften, Absatzfluss, Listen und Links bewahren, ohne jeden nachgelagerten Verbraucher zu zwingen, DOM-Verschachtelungen, wiederholte Navigation, Attribute, Skripte, Stile oder Template-Rauschen zu verstehen.
Dies ist nicht dasselbe wie das Versprechen einer perfekten Artikelextraktion oder einer benutzerdefinierten Schemaextraktion. Eine Markdown-Antwort sollte als sauberes Inhaltsformat behandelt werden. Wenn Ihr Produkt genaue Produktfelder, Byline, Daten, Preise, Bewertungen oder Struktur auf Selektorebene benötigt, validieren Sie diese Felder separat oder halten Sie HTML und Metadaten für den Parser verfügbar.
Praktische Erkenntnis: Verwenden Sie page-to-Markdown, wenn der Verbraucher lesbare Seiteninhalte benötigt, nicht exakte DOM-Beweise.
Wann sollten Teams Markdown anstelle von HTML oder Text verwenden?
Markdown ist am stärksten, wenn der Seiteninhalt gelesen, aufgeteilt, zusammengefasst, überprüft, indiziert oder in einen Sprachmodell-Workflow übergeben wird. Es gibt dem empfangenden System mehr Struktur als einfacher Text, aber weniger Rauschen als rohes HTML.
HTML ist immer noch die bessere Wahl, wenn Selektoren, Attribute, verschachtelte Tabellen, exakte Links oder DOM-Beziehungen wichtig sind. Einfacher Text ist besser, wenn der Workflow nur kompakte lesbare Kopien benötigt. JSON-Metadaten helfen bei der Anforderungsdiagnose. Screenshots und PDFs helfen, wenn der visuelle Zustand der Beweis ist.
| Workflow | Warum Markdown hilft | Wann ein anderes Format besser ist |
|---|---|---|
| RAG und AI-Eingabe | Behält Überschriften, Listen, Links und lesbare Abschnitte für eine sauberere Aufteilung. | Verwenden Sie HTML, wenn die Extraktion von Selektoren oder versteckten Attributen abhängt. |
| Redaktionelle Überprüfung | Erleichtert es Menschen, öffentliche Seiteninhalte zu scannen und zu annotieren. | Verwenden Sie Screenshot oder PDF, wenn Layout und visueller Beweis wichtig sind. |
| Dokumentationsimport | Bewegt Seitenabschnitte in ein Format, das Dokumentationstools natürlich verarbeiten können. | Verwenden Sie Text, wenn nur einfacher Text benötigt wird. |
| Suchindizierung | Bewahrt nützliche Struktur, ohne HTML-Boilerplate zum Index hinzuzufügen. | Verwenden Sie JSON-Metadaten, um die endgültige URL, den Status, den Inhaltstyp und den Anforderungskontext zu verfolgen. |
| Überwachungsnotizen | Erfasst lesbare Seitenänderungen, ohne jedes Mal ein vollständig gerendertes Artefakt zu speichern. | Verwenden Sie Screenshots für visuelle Regressionen, fehlerhafte Layouts oder Genehmigungsbeweise. |
Praktische Erkenntnis: Wählen Sie Markdown, wenn Struktur dem Leser oder Modell hilft, und behalten Sie HTML oder visuelle Formate, wenn der Beweis genau sein muss.
Wie verändert Rendering die Markdown-Ausgabe?
Ein Markdown-Konverter kann nur mit Inhalten arbeiten, die die Anfrage erfasst. Viele öffentliche Seiten senden nützliche Inhalte in der ersten HTML-Antwort. Diese Seiten sollten einfach bleiben: die URL abrufen, Markdown anfordern und die Browserausführung vermeiden, es sei denn, die Ausgabe beweist, dass etwas fehlt.
Andere Seiten liefern eine dünne HTML-Hülle und bauen die nützlichen Inhalte auf, nachdem JavaScript ausgeführt wurde. In diesem Fall kann JavaScript-Darstellung den gerenderten Seitenzustand erfassen, bevor die Antwort in Markdown umgewandelt wird. Das macht das Markdown vollständiger, aber es macht die Anfrage auch schwerer, sodass das Rendering eine Entscheidung basierend auf Beweisen sein sollte.
Nützliche Beweise umfassen das Quell-HTML, gerendertes HTML, endgültige URL, Antwortgröße, Statuscode, Screenshot-Zustand und einige repräsentative Zielproben. Wenn das Markdown bereits vollständig aus der Quellaufnahme ist, halten Sie das Profil leicht. Wenn wichtige Abschnitte erst nach der Browserausführung erscheinen, rendern Sie dieses URL-Muster absichtlich.
Praktische Erkenntnis: Rendern Sie für die Vollständigkeit von Markdown, nicht weil Rendering verfügbar ist.
Wie unterscheidet sich page-to-Markdown von einem HTML-to-Markdown-Parser?
Der Begriff HTML zu Markdown-Parser API beginnt normalerweise mit erfasstem HTML und konzentriert sich auf die Umwandlung. Eine Web-Seite zu Markdown API beginnt früher im Workflow: Sie akzeptiert eine öffentliche URL, ruft die Seite ab, behandelt Anforderungssteuerungen und gibt dann Markdown als das gewählte Antwortformat zurück.
Dieser Unterschied ist in der Produktion wichtig. Die Seitenaufnahme kann Weiterleitungen, Header, Cookies, Sitzungen, Länderauswahl, Wartezeiten, Proxy-Routing, JavaScript-Darstellung, Inhaltsprüfungen und Antwortgrößenbeschränkungen umfassen. Ein Konverter allein löst diese Lieferfragen nicht. ScraperFly ermöglicht es dem gleichen Anfrage-Modell, von einfacher Quellaufnahme zu einem vollständigeren Seitenzustand zu wechseln, wenn das Ziel beweist, dass es benötigt wird.
Wenn Ihr Team bereits vertrauenswürdiges HTML hat und nur eine Umwandlung benötigt, kann ein parserfokussierter Workflow ausreichend sein. Wenn das Problem mit der Bereitstellung einer öffentlichen URL beginnt und in lesbare Inhalte übergeht, ist page-to-Markdown das vollständigere mentale Modell.
Was sollten Teams überprüfen, bevor sie die Markdown-Erfassung skalieren?
Gute Markdown-Ausgabe ist nicht nur eine Formatierungsfrage. Sie hängt von der Zielseite, dem Antwortzustand, dem Inhalt ab, den Ihr nachgelagertes System erwartet, und der Menge an Rauschen, die die Seite um die nützlichen Abschnitte hinzufügt.
- Endgültige URL und Status. Weiterleitungen, weiche Fehler, Einwilligungsseiten oder Herausforderungsseiten können lesbares Markdown erzeugen, das dennoch der falsche Inhalt ist.
- Quell- versus gerendertem Inhalt. Vergleichen Sie die rohe Aufnahme mit der gerenderten Aufnahme, bevor Sie die Browserausführung zur Standardoption machen.
- Überschriftenstruktur. Überprüfen Sie, ob die Überschriften den nützlichen Inhalt widerspiegeln oder hauptsächlich Navigation und Template-Abschnitte wiederholen.
- Links und Listen. Stellen Sie sicher, dass wichtige Links, Listenelemente und Abschnittsgrenzen die Umwandlung in einer Form überstehen, die Ihre App verwenden kann.
- Wiederholtes Boilerplate. Navigation, Fußzeilen, Cookie-Banner, Empfehlungen und Werbung können weiterhin in Markdown erscheinen und sollten vor der Indizierung behandelt werden.
- Tabellen und komplexe Layouts. Markdown kann komplexe Strukturen vereinfachen. Halten Sie HTML verfügbar, wenn die Tabellenform oder exakte DOM-Beziehungen wichtig sind.
Diese Überprüfungen halten die Ausgabe ehrlich. Sie verhindern auch, dass ein Team Markdown als eine magische Bereinigungsstufe behandelt, wenn das eigentliche Problem die Lieferung, das Rendering, die Zielauswahl oder eine nachgelagerte Extraktionsanforderung ist.
Wie sollten Teams zwischen Markdown und anderen ScraperFly-Formaten wählen?
Der sicherste Ansatz ist, dasselbe Ziel durch mehrere Antwortformate im API Builder zu testen. Verwenden Sie Markdown für lesbare Struktur, Text für kompakte Kopien, HTML für Parserkontrolle, JSON-Metadaten für Diagnosen, Screenshots für visuelle QA und PDFs für tragbare Aufzeichnungen.
| Format | Beste Passform | Entscheidungsregel |
|---|---|---|
| Markdown | AI, RAG, Dokumente, Überprüfung und lesbare Inhalts-Workflows. | Verwenden Sie es, wenn Überschriften, Links und Abschnittsfluss die Verbraucherfahrung verbessern. |
| HTML | Selektoren, DOM-Parsing, Attribute, Tabellen und exakte Quellbeziehungen. | Verwenden Sie es, wenn der Parser strukturelle Präzision benötigt. |
| Text | Leichte Suche, Zusammenfassungen und einfache Sprachverarbeitung. | Verwenden Sie es, wenn Struktur nicht notwendig ist. |
| JSON-Metadaten | Protokollierung, Statusprüfungen, endgültige URL, Inhaltstyp und Anforderungsdiagnosen. | Verwenden Sie es neben Inhaltsformaten, um die Anfrage leichter zu debuggen. |
| Screenshot oder PDF | Visueller Beweis, QA, Archiv, Compliance oder menschliche Überprüfung. | Verwenden Sie visuelle Dateien, wenn das Erscheinungsbild wichtiger ist als maschinenlesbarer Text. |
Für einen breiteren Formatvergleich überprüfen Sie den Leitfaden zu den Antwortformaten der Web-Scraping-API. Für AI-spezifische Workflows verbinden Sie Markdown-Entscheidungen mit der Scraping API für RAG-Seite und validieren Sie, ob Ihre Inhalts-Pipeline Markdown, Text, HTML, Metadaten oder eine Mischung benötigt.
Praktische Erkenntnis: Standardisieren Sie nicht zu früh auf ein Format; testen Sie das Ziel und wählen Sie die Antwort, die Ihr Produkt sofort verwenden kann.
Wie kann ScraperFly Markdown-Workflows vorhersehbar halten?
ScraperFly ist nützlich, wenn die Markdown-Konvertierung Teil eines größeren Workflows für öffentliche Webdaten ist. Die API kann einfache Seiten leicht halten, Rendering hinzufügen, wenn JavaScript nützliche Inhalte erstellt, den Anforderungskontext mit Headern und Sitzungen bewahren, durch länderspezifische oder stärkere Lieferungen leiten, wenn nötig, und alternative Formate zurückgeben, wenn Markdown nicht ausreicht.
Diese Flexibilität ist sowohl für die Kosten als auch für die Qualität wichtig. Eine Seite, die sauber aus Quell-HTML konvertiert, sollte nicht dasselbe Anforderungsprofil wie eine gerenderte Seite haben, die Wartezeiten, Sitzungs-Kontinuität oder visuellen Beweis benötigt. Verbinden Sie die Ausgabentscheidung mit dem Anforderungsgewicht und verwenden Sie Preise erst, nachdem das Zielverhalten klar ist.
Wenn das Ziel die Inhaltsextraktion und nicht die Markdown-Formatierung ist, vergleichen Sie diese Seite mit der Web-Inhaltsparser-API. Wenn das Ziel ein tragbares Artefakt ist, verwenden Sie stattdessen die PDF- oder Screenshot-Seiten. Der beste Workflow von page-to-Markdown ist spezifisch genug, um nützlich zu sein, und flexibel genug, um unnötige Infrastruktur zu vermeiden.



