






Parser-bereite Erfassung
Öffentliche Seiten in saubere Eingaben verwandeln, denen Ihr eigener Parser vertrauen kann
Das Parsen von Website-Inhalten beginnt, bevor Extraktionsregeln geschrieben werden. Ihr Team muss wissen, was die öffentliche Seite tatsächlich zurückgibt, ob der nützliche Inhalt im Quell-HTML oder in der gerenderten Ausgabe enthalten ist und welches Antwortformat das nachgelagerte Parsen einfacher und nicht störender macht.
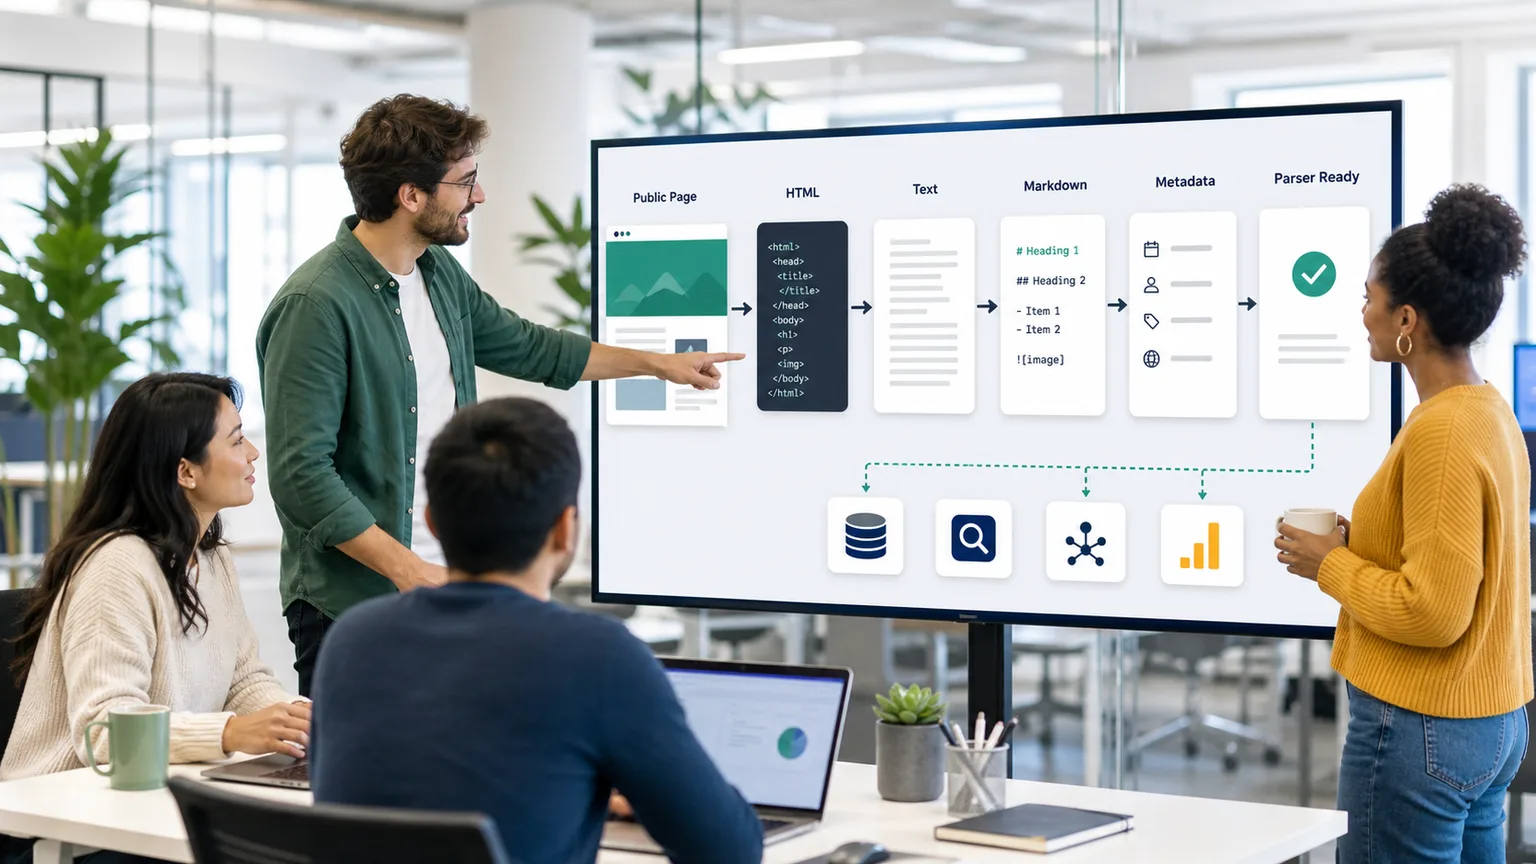
ScraperFly bietet Entwicklern eine praktische Erfassungsschicht für Inhalte öffentlicher Websites. Rufen Sie die Seite ab, inspizieren Sie die Antwort, wählen Sie HTML, Text, Markdown, Metadaten, Screenshots oder PDFs aus und halten Sie die Parsing-Logik, Klassifizierung, Anreicherung und Speicherung in Ihrem eigenen Produkt, wo die Geschäftsregeln hingehören.
Was ist eine Parse-Website-Inhalts-API?
Eine Parse-Website-Inhalts-API ist nützlich, wenn sie Ihrer Anwendung zuverlässige Seiten-Eingaben für einen Parser, eine Inhalts-Pipeline, einen Suchindex, einen KI-Workflow, ein Archiv oder ein Qualitätssicherungssystem liefert. Die API sollte die öffentliche Seite zuverlässig erfassen und genügend Struktur zurückgeben, damit Ihr nachgelagerter Code entscheiden kann, was wichtig ist.
ScraperFly konzentriert sich auf die Erfassungs- und Antwortschicht. Es kann rohes oder gerendertes HTML zurückgeben, wenn die DOM-Struktur wichtig ist, Text, wenn der Parser nur lesbaren Inhalt benötigt, Markdown, wenn Überschriften und Links bei der Überprüfung oder KI-Eingabe helfen, JSON-Metadaten, wenn Protokolle betrieblichen Kontext benötigen, und visuelle Dateien, wenn ein Mensch einen Nachweis darüber benötigt, wie die Seite erschien.
Praktische Erkenntnis: Verwenden Sie ScraperFly, um öffentliche Website-Inhalte sauber zu erfassen, und halten Sie dann zielgruppenspezifische Parsing-Regeln im System, das Ihr Datenmodell versteht.
Was sollte passieren, bevor Parsing-Regeln erstellt werden?
Der teure Fehler besteht darin, Parser gegen eine imaginierte Seitenstruktur zu schreiben. Eine öffentliche Website kann nützliche Inhalte in der ersten HTML-Antwort offenbaren, sie hinter clientseitigem Rendering verstecken, sie in der Navigation wiederholen, in Metadaten verschieben oder eine kleine Hülle zurückgeben, die Ihnen sehr wenig sagt, bis ein Browser ausgeführt wird. Die erste Aufgabe besteht darin, die Erfassungsstruktur zu beweisen.
Beginnen Sie mit einer einfachen Anfrage, inspizieren Sie den Status, die endgültige URL, den Inhaltstyp, die Antwortgröße und den Inhalt des Körpers, und entscheiden Sie dann, was der Parser konsumieren sollte. Wenn das Quell-HTML bereits den Zielinhalt enthält, halten Sie die Anfrage leicht. Wenn JavaScript das Ergebnis ändert, testen Sie die gerenderte Ausgabe. Wenn die Pipeline KI-gerichtet ist, vergleichen Sie sauberen Text und Markdown, bevor Sie Konverter erstellen.
| Frage | Was zu inspizieren ist | Bessere Entscheidung |
|---|---|---|
| Ist der nützliche Inhalt bereits vorhanden? | Quell-HTML, Antwortgröße, Überschriften, Links, Tabellen, Produktkarten, Artikeltext oder eingebettete Metadaten. | Verwenden Sie eine leichte HTML- oder Textanfrage, wenn die erste Antwort ausreicht. |
| Erstellt JavaScript die endgültige Seite? | Vergleichen Sie Quell-HTML mit gerendertem HTML und sichtbarem Seitenstatus. | Aktivieren Sie das Rendering nur, wenn die Browserausführung den erfassten Inhalt ändert. |
| Benötigt der Parser die DOM-Struktur? | Selektoren, Attribute, Listen, Links, Paginierung, strukturierte Tabellen und wiederholte Blöcke. | Verwenden Sie HTML, wenn strukturelle Beziehungen wichtig sind. |
| Ist der Verbraucher ein KI- oder Überprüfungs-Workflow? | Lesbare Überschriften, Links, Artikelabschnitte, Boilerplate und wiederholte Layout-Geräusche. | Versuchen Sie Text oder Markdown, bevor Sie eine benutzerdefinierte Bereinigungsstufe erstellen. |
| Benötigt das Ergebnis Beweise? | Status, endgültige URL, Inhaltstyp, Screenshot, PDF oder Archivartefakt. | Fügen Sie Metadaten oder visuelle Ausgaben hinzu, wenn Debugging, QA, Compliance oder Überprüfung einen Nachweis benötigen. |
Welches Ausgabeformat ist am besten für das Parsen von Website-Inhalten?
Kein einzelnes Format ist für jeden Parser am besten. HTML ist leistungsstark, wenn die Extraktionslogik eine DOM-Struktur benötigt, bringt jedoch auch Navigation, Layout, Skripte und wiederholte Vorlagen-Geräusche mit sich. Text ist kompakt und leicht zu durchsuchen, entfernt jedoch den Großteil des strukturellen Kontexts. Markdown ist nützlich für lesbare Inhalts-Workflows, da Überschriften, Links und Listen leichter zu verstehen bleiben. Metadaten helfen, die Anfrage zu debuggen, ohne den Parser zu zwingen, alles aus dem Körper abzuleiten.
Der praktische Weg besteht darin, zwei oder drei Ausgaben auf echten Zielseiten zu testen, bevor Sie in die Produktion gehen. Ein Parser für Artikelinhalte könnte Markdown bevorzugen. Ein Link-Entdeckungsjob benötigt möglicherweise HTML. Ein Überwachungsjob könnte Text mit JSON-Metadaten kombinieren. Ein QA-Workflow könnte Screenshots oder PDFs nur für Aufzeichnungen anhängen, die eine visuelle Überprüfung benötigen.
| Ausgabe | Verwenden Sie es, wenn | Beobachten Sie den Kompromiss |
|---|---|---|
| HTML | Der Parser benötigt Selektoren, Attribute, Links, Tabellen, eingebettete Daten oder wiederholte DOM-Muster. | Erfordert Bereinigung und zielgruppenspezifische Parsing-Logik. |
| Gerendertes HTML | Die Quellantwort ist unvollständig, bis JavaScript die Seite erstellt. | Schwerer als eine grundlegende Anfrage, daher aktivieren Sie es für bewährte Ziele. |
| Text | Der Workflow benötigt kompakte, lesbare Inhalte für Übereinstimmungen, Suchen, Zusammenfassungen oder Klassifizierungen. | Struktureller Kontext wird reduziert. |
| Markdown | Überschriften, Links, Listen und lesbare Abschnitte helfen KI, RAG, Dokumentation oder Analystenüberprüfung. | Kein Ersatz für präzise DOM-Extraktion. |
| JSON-Metadaten | Protokolle benötigen endgültige URL, Status, Inhaltstyp, Timing oder Antwortkontext. | Metadaten erklären die Anfrage; sie erfinden keine benutzerdefinierten Ziel-Felder. |
| Screenshot oder PDF | Ein Prüfer oder Archiv benötigt visuelle Beweise für den Zustand der öffentlichen Seite. | Weniger praktisch für maschinelles Parsen und schwerer als Textausgabe. |
Vergleichen Sie das vollständige Formatset auf der Web-Scraping-API-Antwortformat-Seite und testen Sie dann eine echte URL im API Builder.
Wann hilft Rendering einem Inhaltsparser?
Rendering hilft, wenn die Browserausführung den nützlichen Inhalt ändert. Dies ist häufig auf Seiten der Fall, die Artikeltexte, Produktkarten, Auflistungen, Bewertungen, Kommentare, Suchergebnisse oder routenspezifische Inhalte nach der ersten HTML-Antwort hydratisieren. Es ist kein Qualitätssiegel an sich. Das Rendern jeder Seite kann einen Parser langsamer, schwerer und schwieriger zu verstehen machen.
Ein guter Parser-Workflow vergleicht die rohe Quellenerfassung mit der gerenderten Erfassung, bevor er eine Standardauswahl trifft. Wenn rohes HTML die Daten enthält, halten Sie den einfachen Weg. Wenn die Seite eine leere Hülle, verzögerten Inhalt oder ein anderes finales DOM zurückgibt, nachdem clientseitiger Code ausgeführt wurde, verwenden Sie die JavaScript-Rendering-API und wählen Sie die kleinste nützliche Ausgabe nach dem Rendering aus.
Wo sollte die Parsing-Logik leben?
ScraperFly sollte nicht als schwarze Box behandelt werden, die magisch die geschäftliche Bedeutung jedes Ziels kennt. Ihr Produkt weiß, welcher Preis wichtig ist, welcher Artikelabschnitt wichtig ist, welche Bewertungsfelder akzeptabel sind, welche Seitenvarianten gültig sind und wie extrahierte Inhalte gespeichert werden sollten. Diese Logik gehört in Ihre Anwendung.
ScraperFly erleichtert den Aufbau dieser Anwendung, indem es die Anfrageebene behandelt: Abrufen öffentlicher Seiten, Rendering bei Bedarf, Beibehalten von Headern oder Sitzungen, wenn das Ziel Kontext erfordert, Routing durch ein Land, wenn öffentliche Inhalte je nach Standort unterschiedlich sind, und Rückgabe von Formaten, die die Bereinigungsarbeit reduzieren. Ihr Parser kann sich dann auf die zielgruppenspezifischen Regeln konzentrieren, die Wert schaffen.
Für die grundlegende Markup-Erfassung siehe die HTML-Scraping-API. Für lesbare nachgelagerte Eingaben vergleichen Sie die Seiten HTML zu Text Parser API und HTML zu Markdown Parser API.
Wie hält ScraperFly Parsing-Workflows praktisch?
Parsing-Projekte beginnen oft mit unbekannten Zielen. Einige Seiten sind einfach. Einige benötigen Rendering. Einige benötigen Header, Cookies, Länderauswahl oder Premium-Routing. Einige sollten nicht skaliert werden, bis die Antwortstruktur bewiesen ist. ScraperFly unterstützt diesen inkrementellen Weg, anstatt von Anfang an das schwerste Anfrageprofil zu erzwingen.
Beginnen Sie kostenlos, testen Sie repräsentative Zielseiten und halten Sie jede Quelle auf dem leichtesten Anfrageprofil, das vollständige nutzbare Inhalte zurückgibt. Verwenden Sie nutzungsabhängige Credits, während das Verhalten und das Volumen des Ziels noch ungewiss sind, und verschieben Sie dann wiederkehrende Parser-Arbeitslasten auf monatliche Credits, sobald die Nachfrage vorhersehbar ist. Das hält den Ingenieureinsatz und die Anfragekosten an Beweise gebunden, nicht an Vermutungen.
Praktische Erkenntnis: Der beste Website-Inhaltsparser beginnt mit einer bewährten Erfassungsstruktur, einer kleinen Anzahl von Antwortformaten und einem klaren Upgrade-Pfad für schwierigere Ziele.










