






Чистий текстовий вихід
Витягніть читабельний текст сторінки без зайвого розміткового шуму
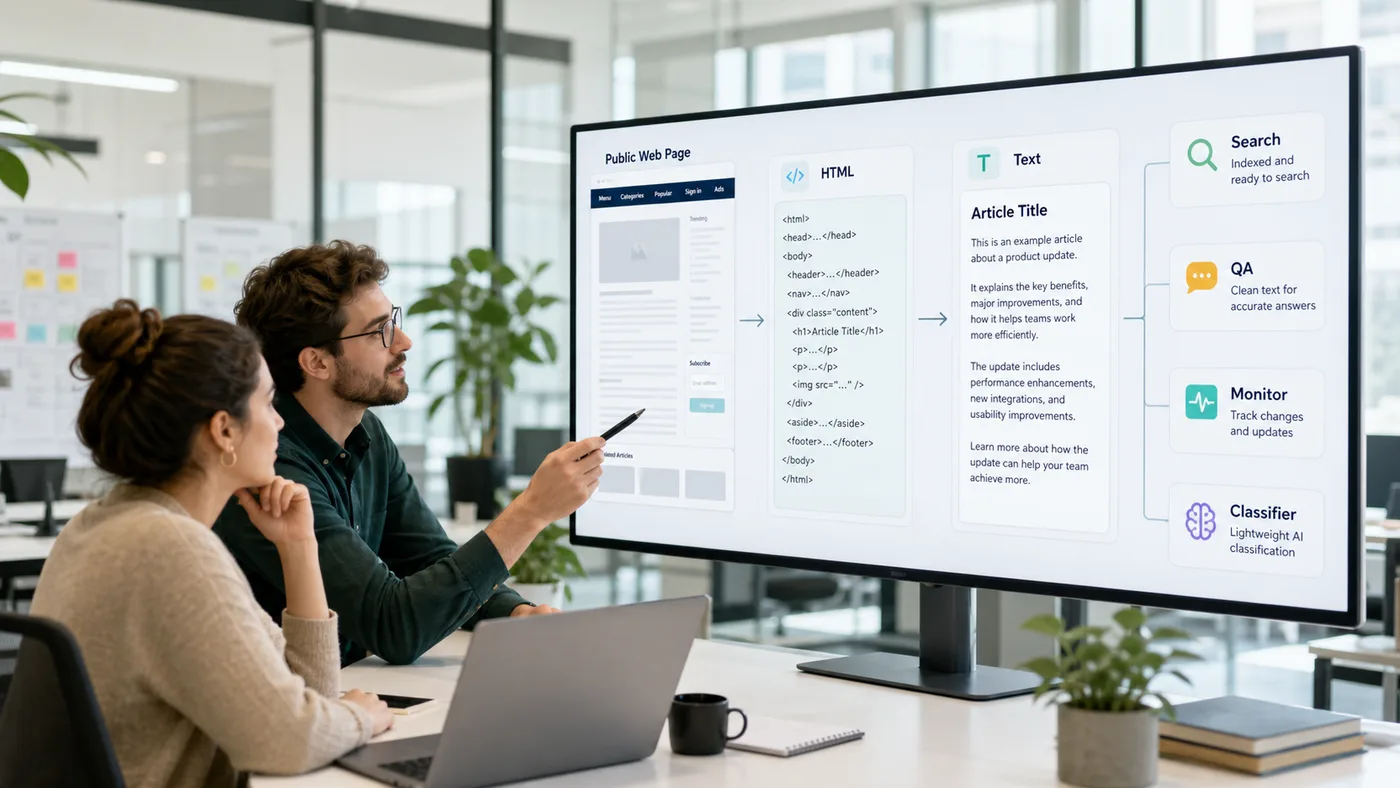
Багато робочих процесів зі скрапінгу не потребують повного DOM. Їм потрібні читабельні частини публічної сторінки: текст статті, описи продуктів, текст політики, деталі списків, контент підтримки або нотатки про оновлення, які можуть бути використані в пошуку, контролі якості, моніторингу, резюме або легкій класифікації AI.
ScraperFly допомагає командам отримувати публічну сторінку, рендерити її, коли JavaScript створює корисний контент, і повертати чистий текст як практичний формат виходу. Це дозволяє зберігати прості робочі процеси з контентом меншими, зберігаючи можливість запитувати HTML, Markdown, JSON метадані, скріншоти або PDF, коли робота потребує більшої структури або доказів.
Що таке API парсера HTML в текст?
API парсера HTML в текст отримує публічну веб-сторінку і повертає читабельний простий текст замість сирої розмітки. Мета не полягає в збереженні кожного зв'язку DOM. Мета полягає в видаленні коду макета, повторюваної навігації, скриптів, атрибутів і візуальної основи, щоб контент можна було перевірити, проіндексувати, порівняти, підсумувати або направити в подальші системи.
Шар захоплення все ще вирішує, чи є текст корисним. Якщо цільова сторінка надсилає значущий контент у вихідному HTML, текстовий вихід може залишатися легким. Якщо важливий контент з'являється лише після виконання JavaScript на стороні браузера, запит може потребувати рендерингу перед перетворенням тексту. ScraperFly зберігає обидва шляхи доступними через один API.
Коли текст кращий за HTML або Markdown?
Текст є найпростішим корисним форматом, коли робочий процес більше цікавить слова, ніж структура. Він добре підходить для пошукової індексації, моніторингу змін, перевірки якості, класифікації, виявлення дублікатів, резюме та легкого попереднього оброблення AI. Він надає додатку компактний контент, який легше зберігати та порівнювати, ніж сирий HTML.
Текст не є ідеальним, коли робочий процес потребує заголовків, посилань, цитат, списків, контексту таблиць або специфічного для DOM витягання. У таких випадках Markdown або HTML можуть містити більш корисну структуру. Найкраща виробнича установка вибирає формат відповіді від подальшого споживача, а не розглядає кожну сторінку як загальний скрап.
| Формат | Найкраще підходить для | Головна перевага | Коли вибрати інший вихід |
|---|---|---|---|
| Текст | Пошук, моніторинг, QA, резюме, класифікація, компактний аналіз. | Маленький, читабельний і легкий для порівняння. | Коли важливі заголовки, посилання або зв'язки DOM. |
| Markdown | RAG, документація, редакційний огляд, AI з читабельною структурою. | Зберігає більше форми контенту, ніж простий текст. | Коли робочий процес потребує лише компактного прозового тексту. |
| HTML | Селектори, атрибути, таблиці, посилання, перевірка джерела, структурований парсинг. | Зберігає розмітку сторінки для користувацьких правил витягання. | Коли сирий розмітка створює зайву роботу з очищення. |
| JSON метадані | Діагностика, ведення журналу, докази відповіді, QA запитів. | Пояснює статус, фінальне URL, тип контенту та контекст захоплення. | Коли додатку потрібен фактичний читабельний текст. |
Як рендеринг JavaScript впливає на витяг тексту?
Перетворення тексту може очистити лише той контент, який захоплює запит. Якщо вихідний HTML вже містить корисний текст, рендеринг додає вагу без покращення виходу. Якщо сторінка надсилає оболонку програми і заповнює видимий контент після гідратації, рендеринг може зробити фінальний текст повним.
Дисциплінований робочий процес тестує обидва стани на реальних цілях. Почніть з захоплення джерела, перевірте текст, а потім увімкніть рендеринг, коли важливий текст відсутній. Якщо контент надходить пізно, налаштування очікування може мати значення. Якщо сторінка змінюється за мовою, куки або регіоном, заголовки, сесії або маршрути країни можуть вплинути на захоплений текст більше, ніж сам рендеринг.
Для сторінок, які потребують виконання браузера, API рендерингу JavaScript пояснює рішення про рендеринг. Для порівняння тексту з HTML, Markdown, JSON, скріншотами та PDF використовуйте посібник по форматах відповіді.
Що команди повинні перевірити перед масштабуванням витягання тексту?
Чистий текст легко споживати, що робить поганий текст легким для пропуску. Перед пакетуванням великого набору URL перевірте, що основний контент присутній, повторювана навігація зменшена, мова правильна, перенаправлення не змінили сторінку, і важливі застереження або деталі цін не зникли під час очищення.
Перевірка особливо важлива для моніторингу та AI робочих процесів. Класифікатор, пошуковий індекс або резюмер можуть з радістю обробляти неповний текст, якщо запис захоплення не пояснює, що сталося. Зберігайте фінальне URL, статус, тип контенту, розмір відповіді, налаштування рендерингу та формат виходу з кожним результатом, щоб команда могла відокремити зміни цілі від помилок витягання.
| Перевірка | Чому це важливо | Корисний сигнал |
|---|---|---|
| Основний текст присутній | Пошук, резюме та моніторинг потребують фактичного контенту, а не лише тексту макета. | Порівняйте текстовий вихід з вихідними або рендереними зразками. |
| Рівень шуму | Навігація та повторюваний шаблон можуть спотворювати класифікатори та резюме. | Перегляньте повторювані фрази на кількох URL. |
| Мова та регіон | Цілі можуть варіювати копію за країною, мовою, валютою або станом згоди. | Записуйте заголовки, маршрути країни, фінальне URL та зразки видимого контенту. |
| Розмір відповіді | Маленький текстовий вихід може виявити перенаправлення, м'які блоки або порожні рендерені стани. | Встановіть очікувані розмірні діапазони для кожного типу цілі. |
| Відповідність формату | Деякі робочі процеси потребують посилань, таблиць або структури цитування. | Перейдіть на Markdown або HTML, коли простий текст видаляє занадто багато контексту. |
Де текстовий вихід вписується в виробничі робочі процеси?
Текстовий вихід корисний, коли результат скрапінгу живить систему, яка читає, порівнює або класифікує контент, а не витягує точні поля DOM. Робота з моніторингом може порівнювати текстові знімки. Пошуковий конвеєр може індексувати читабельний текст. Процес контролю якості може перевірити, чи змінилася публічна сторінка. Легкий AI робочий процес може класифікувати або підсумовувати контент без перенесення розмітки в запит.
ScraperFly зберігає цей робочий процес практичним, оскільки текстовий вихід є одним з варіантів у тій же моделі запиту. Команди можуть протестувати ціль у API Builder, вибрати текстовий вихід, додати рендеринг лише за необхідності та зберегти HTML або скріншоти для налагодження, коли текст сам по собі не може пояснити результат.
Як залишається доступним перетворення тексту?
Перетворення HTML в текст може залишатися легким, коли відповідь джерела вже містить контент. Витрати зростають, коли робочий процес додає рендеринг браузера, налаштування очікування, сесії, маршрути країни, преміум-доставку, скріншоти, PDF або повторні спроби. Ефективний шаблон полягає в тому, щоб почати просто, перевірити вихід і додати контролі лише тоді, коли вони покращують захоплений текст.
Це робить текстовий вихід хорошим вибором для нерівномірних проектів і повторюваних систем. Команди можуть перевірити кілька цілей з безкоштовними кредитами, використовувати кредити за принципом "плати за використання" для випадкової роботи з очищення, і перевести передбачувані роботи з витягання або моніторингу на місячні кредити, коли профіль запиту доведено. Сторінка цін пояснює, як цей шлях масштабується без примусу до підписки для кожного експерименту.







