






Saubere Textausgabe
Lesbaren Seiteninhalt extrahieren, ohne Markup-Rauschen weiterzugeben
Viele Scraping-Workflows benötigen nicht das gesamte DOM. Sie benötigen die lesbaren Teile einer öffentlichen Seite: Artikeltexte, Produktbeschreibungen, Richtlinientexte, Listendetails, Unterstützungsinhalte oder Aktualisierungsnotizen, die in Suche, QA, Überwachung, Zusammenfassungen oder leichte KI-Klassifizierung überführt werden können.
ScraperFly hilft Teams, die öffentliche Seite abzurufen, sie zu rendern, wenn JavaScript den nützlichen Inhalt erstellt, und sauberen Text als praktisches Ausgabeformat zurückzugeben. Das hält einfache Inhalts-Workflows kleiner und bewahrt die Option, HTML, Markdown, JSON-Metadaten, Screenshots oder PDFs anzufordern, wenn der Job mehr Struktur oder Nachweis benötigt.
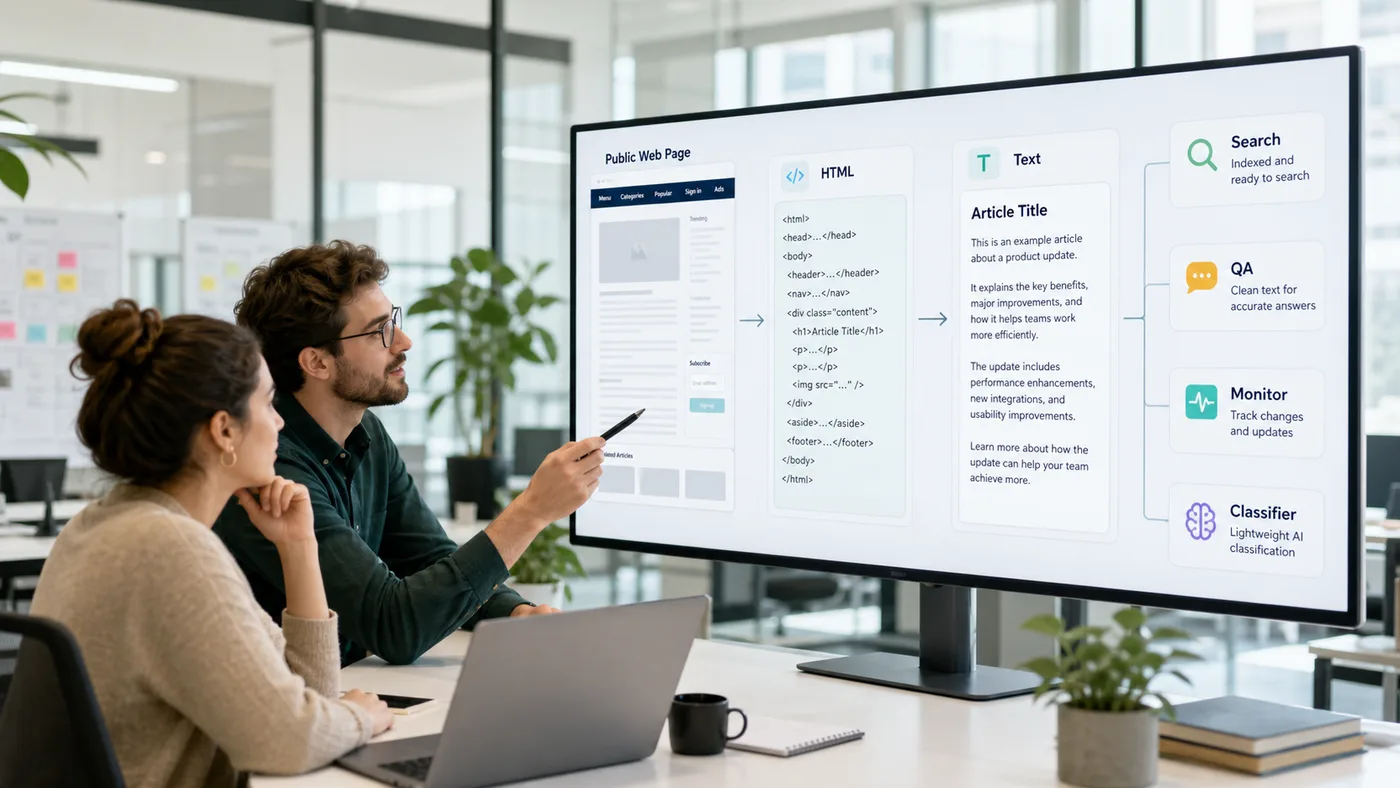
Was ist eine HTML-zu-Text-Parser-API?
Eine HTML-zu-Text-Parser-API ruft eine öffentliche Webseite ab und gibt lesbaren Klartext anstelle von rohem Markup zurück. Das Ziel ist nicht, jede DOM-Beziehung zu bewahren. Das Ziel ist es, Layout-Code, wiederholte Navigation, Skripte, Attribute und visuelle Stützen zu entfernen, damit der Inhalt inspiziert, indiziert, verglichen, zusammengefasst oder in nachgelagerte Systeme geleitet werden kann.
Die Erfassungsschicht entscheidet weiterhin, ob der Text nützlich ist. Wenn der Zielserver bedeutungsvollen Inhalt im Quell-HTML sendet, kann die Textausgabe leichtgewichtig bleiben. Wenn wichtiger Inhalt erst nach dem Ausführen von JavaScript auf der Client-Seite erscheint, muss die Anfrage möglicherweise gerendert werden, bevor die Textkonvertierung erfolgt. ScraperFly hält beide Wege über eine API-Oberfläche verfügbar.
Wann ist Text besser als HTML oder Markdown?
Text ist das einfachste nützliche Format, wenn ein Workflow mehr Wert auf Wörter als auf Struktur legt. Es eignet sich gut für die Suchindizierung, Änderungsüberwachung, QA-Überprüfung, Klassifizierung, Duplikaterkennung, Zusammenfassungen und leichte KI-Vorverarbeitung. Es bietet der Anwendung kompakten Inhalt, der einfacher zu speichern und zu vergleichen ist als rohes HTML.
Text ist nicht ideal, wenn der Workflow Überschriften, Links, Zitationen, Listen, Tabellenkontext oder DOM-spezifische Extraktion benötigt. In diesen Fällen kann Markdown oder HTML nützlichere Struktur bieten. Die beste Produktionskonfiguration wählt das Antwortformat vom nachgelagerten Verbraucher, anstatt jede Seite als generisches Scraping zu behandeln.
| Format | Am besten geeignet für | Hauptvorteil | Wann ein anderes Ausgabeformat wählen |
|---|---|---|---|
| Text | Suche, Überwachung, QA, Zusammenfassungen, Klassifizierung, kompakte Analyse. | Klein, lesbar und leicht zu vergleichen. | Wenn Überschriften, Links oder DOM-Beziehungen wichtig sind. |
| Markdown | RAG, Dokumentation, redaktionelle Überprüfung, KI-Eingang mit lesbarer Struktur. | Bewahrt mehr Inhaltsform als reiner Text. | Wenn der Workflow nur kompakte Prosa benötigt. |
| HTML | Selektoren, Attribute, Tabellen, Links, Quellinspektion, strukturierte Analyse. | Hält Seitenmarkup für benutzerdefinierte Extraktionsregeln verfügbar. | Wenn rohes Markup unnötige Aufräumarbeit verursacht. |
| JSON-Metadaten | Diagnosen, Protokollierung, Antwortnachweise, Anfrage-QA. | Erklärt Status, endgültige URL, Inhaltstyp und Erfassungs-Kontext. | Wenn die Anwendung den tatsächlichen lesbaren Inhalt benötigt. |
Wie beeinflusst das Rendern von JavaScript die Textextraktion?
Die Textkonvertierung kann nur den Inhalt bereinigen, den die Anfrage erfasst. Wenn das Quell-HTML bereits den nützlichen Text enthält, fügt das Rendern Gewicht hinzu, ohne die Ausgabe zu verbessern. Wenn die Seite ein App-Shell sendet und den sichtbaren Inhalt nach der Hydration füllt, kann die gerenderte Erfassung den endgültigen Text vervollständigen.
Ein disziplinierter Workflow testet beide Zustände an realen Zielen. Beginnen Sie mit der Quellenerfassung, inspizieren Sie den Text und aktivieren Sie das Rendern, wenn wichtiger Inhalt fehlt. Wenn der Inhalt zu spät ankommt, kann eine Warteeinstellung wichtig sein. Wenn die Seite sich nach Sprache, Cookie oder Region ändert, können Header, Sitzungen oder Länderrouting den erfassten Text mehr beeinflussen als das Rendern selbst.
Für Seiten, die eine Browserausführung erfordern, erklärt die JavaScript-Rendering-API die Renderentscheidung. Zum Vergleichen von Text mit HTML, Markdown, JSON, Screenshots und PDFs verwenden Sie den Leitfaden zu den Antwortformaten.
Was sollten Teams validieren, bevor sie die Textextraktion skalieren?
Sauberer Text ist einfach zu konsumieren, was es einfach macht, schlechten Text zu übersehen. Bevor Sie eine große URL-Gruppe batchen, validieren Sie, dass der Hauptinhalt vorhanden ist, wiederholte Navigation reduziert ist, die Sprache korrekt ist, Weiterleitungen die Seite nicht verändert haben und wichtige Haftungsausschlüsse oder Preisinformationen während der Bereinigung nicht verschwunden sind.
Die Validierung ist besonders wichtig für Überwachungs- und KI-Workflows. Ein Klassifizierer, Suchindex oder Zusammenfasser kann unvollständigen Text verarbeiten, es sei denn, der Erfassungsdatensatz erklärt, was passiert ist. Speichern Sie die endgültige URL, den Status, den Inhaltstyp, die Antwortgröße, die Rendereinstellung und das Ausgabeformat mit jedem Ergebnis, damit das Team Zieländerungen von Extraktionsfehlern trennen kann.
| Überprüfung | Warum es wichtig ist | Nützlicher Hinweis |
|---|---|---|
| Hauptinhalt vorhanden | Suche, Zusammenfassungen und Überwachung benötigen den tatsächlichen Inhalt, nicht nur Layouttext. | Vergleichen Sie die Textausgabe mit Quell- oder gerenderten Beispielen. |
| Rauschpegel | Navigation und wiederholte Standardtexte können Klassifizierer und Zusammenfassungen verzerren. | Überprüfen Sie wiederholte Phrasen über mehrere URLs hinweg. |
| Sprache und Region | Ziele können den Text je nach Land, Sprache, Währung oder Einwilligungsstatus variieren. | Protokollieren Sie Header, Länderrouting, endgültige URL und sichtbare Inhaltsbeispiele. |
| Antwortgröße | Winzige Textausgaben können Weiterleitungen, sanfte Blockierungen oder leere gerenderte Zustände offenbaren. | Setzen Sie erwartete Größenbänder für jeden Zieltyp. |
| Formatanpassung | Einige Workflows benötigen Links, Tabellen oder Zitationsstruktur. | Wechseln Sie zu Markdown oder HTML, wenn reiner Text zu viel Kontext entfernt. |
Wo passt die Textausgabe in Produktions-Workflows?
Textausgabe ist nützlich, wenn das Scraping-Ergebnis ein System speist, das Inhalte liest, vergleicht oder klassifiziert, anstatt präzise DOM-Felder zu extrahieren. Ein Überwachungsjob kann Text-Schnappschüsse vergleichen. Eine Suchpipeline kann lesbaren Text indizieren. Ein QA-Prozess kann überprüfen, ob sich eine öffentliche Seite geändert hat. Ein leichter KI-Workflow kann Inhalte klassifizieren oder zusammenfassen, ohne Markup in die Eingabe zu übertragen.
ScraperFly hält diesen Workflow praktisch, da die Textausgabe eine Option im selben Anfrage-Modell ist. Teams können das Ziel im API Builder testen, die Textausgabe wählen, das Rendern nur bei Bedarf hinzufügen und HTML oder Screenshots für Debugging verfügbar halten, wenn der Text allein das Ergebnis nicht erklären kann.
Wie bleibt die Textkonvertierung erschwinglich?
Die HTML-zu-Text-Konvertierung kann leicht bleiben, wenn die Quellantwort bereits den Inhalt enthält. Die Kosten steigen, wenn ein Workflow das Rendern im Browser, Wartezeiten, Sitzungen, Länderrouting, Premium-Lieferung, Screenshots, PDFs oder wiederholte Versuche hinzufügt. Das effiziente Muster besteht darin, einfach zu beginnen, die Ausgabe zu inspizieren und Kontrollen nur hinzuzufügen, wenn sie den erfassten Text verbessern.
Dies macht die Textausgabe zu einer guten Wahl für unregelmäßige Projekte und wiederkehrende Systeme. Teams können einige Ziele mit kostenlosen Credits validieren, nutzungsabhängige Credits für gelegentliche Aufräumarbeiten verwenden und vorhersehbare Extraktions- oder Überwachungsjobs auf monatliche Credits umstellen, wenn das Anfrageprofil bewährt ist. Die Preisseite erklärt, wie dieser Weg skaliert, ohne jedes Experiment in ein Abonnement zu zwingen.







