






Salida de texto limpio
Extrae texto legible de la página sin llevar ruido de marcado a la siguiente etapa
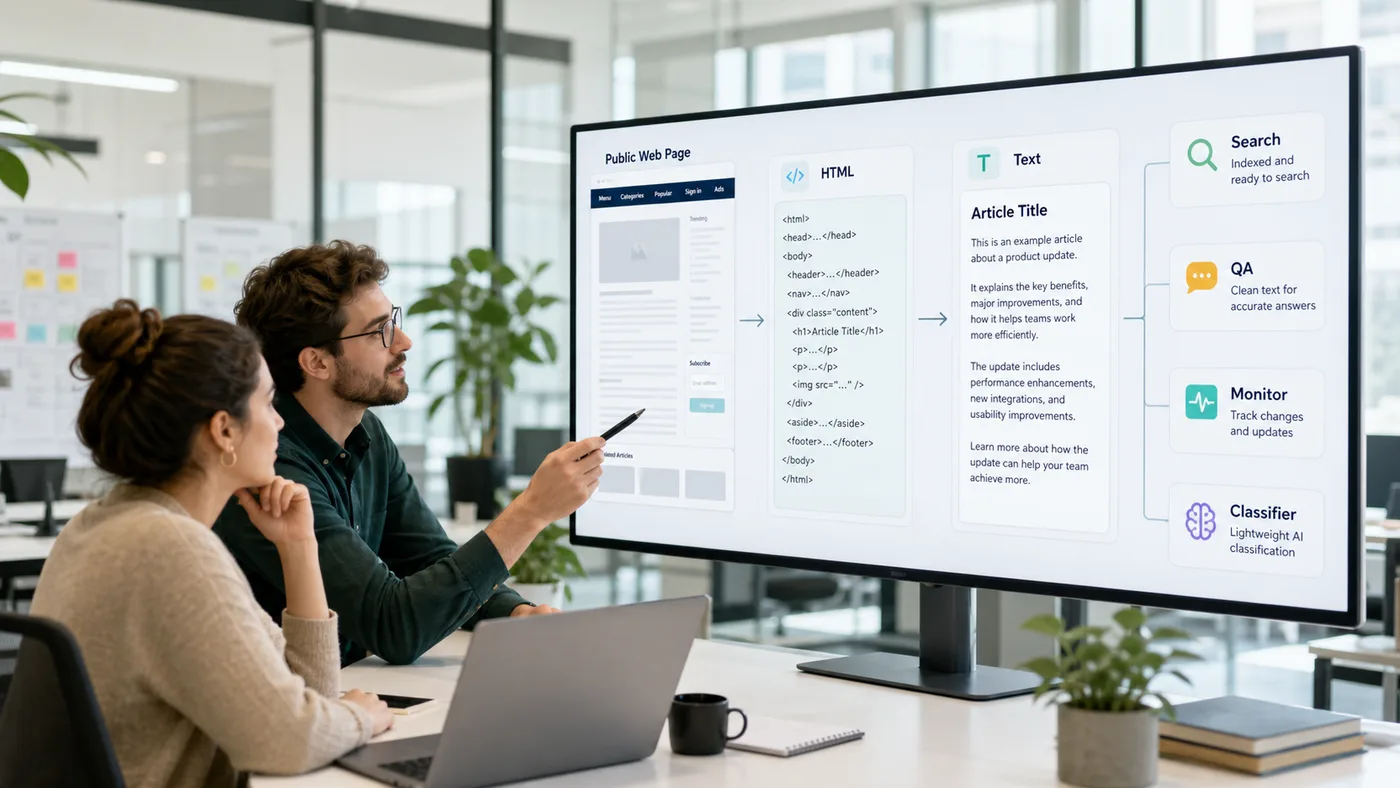
Muchos flujos de trabajo de scraping no necesitan el DOM completo. Necesitan las partes legibles de una página pública: texto de artículos, descripciones de productos, texto de políticas, detalles de listados, contenido de soporte o notas de actualización que pueden moverse a búsqueda, QA, monitoreo, resúmenes o clasificación ligera de IA.
ScraperFly ayuda a los equipos a obtener la página pública, renderizarla cuando JavaScript crea el contenido útil y devolver texto limpio como un formato de salida práctico. Eso mantiene los flujos de trabajo de contenido simples más pequeños mientras se preserva la opción de solicitar HTML, Markdown, metadatos JSON, capturas de pantalla o PDFs cuando el trabajo necesita más estructura o prueba.
¿Qué es una API de parser de HTML a texto?
Una API de parser de HTML a texto obtiene una página web pública y devuelve texto plano legible en lugar de marcado en bruto. El objetivo no es preservar cada relación del DOM. El objetivo es eliminar el código de diseño, la navegación repetida, scripts, atributos y andamiaje visual para que el contenido pueda ser inspeccionado, indexado, comparado, resumido o dirigido a sistemas posteriores.
La capa de captura aún decide si el texto es útil. Si el objetivo envía contenido significativo en HTML de origen, la salida de texto puede mantenerse ligera. Si el contenido importante aparece solo después de que se ejecute JavaScript del lado del navegador, la solicitud puede necesitar renderización antes de la conversión de texto. ScraperFly mantiene ambos caminos disponibles a través de una única superficie de API.
¿Cuándo es mejor el texto que HTML o Markdown?
El texto es el formato útil más simple cuando un flujo de trabajo se preocupa más por las palabras que por la estructura. Es adecuado para indexación de búsqueda, monitoreo de cambios, revisión de QA, clasificación, detección de duplicados, resúmenes y preprocesamiento ligero de IA. Proporciona a la aplicación contenido compacto que es más fácil de almacenar y comparar que HTML en bruto.
El texto no es ideal cuando el flujo de trabajo necesita encabezados, enlaces, citas, listas, contexto de tablas o extracción específica del DOM. En esos casos, Markdown o HTML pueden llevar una estructura más útil. La mejor configuración de producción elige el formato de respuesta del consumidor posterior en lugar de tratar cada página como un scraping genérico.
| Formato | Mejor adaptado a | Principal ventaja | Cuándo elegir otra salida |
|---|---|---|---|
| Texto | Búsqueda, monitoreo, QA, resúmenes, clasificación, análisis compacto. | Pequeño, legible y fácil de comparar. | Cuando los encabezados, enlaces o relaciones del DOM importan. |
| Markdown | RAG, documentación, revisión editorial, entrada de IA con estructura legible. | Preserva más forma de contenido que texto plano. | Cuando el flujo de trabajo solo necesita prosa compacta. |
| HTML | Selectores, atributos, tablas, enlaces, inspección de origen, análisis estructurado. | Mantiene el marcado de la página disponible para reglas de extracción personalizadas. | Cuando el marcado en bruto crea trabajo de limpieza innecesario. |
| Metadatos JSON | Diagnósticos, registro, evidencia de respuesta, QA de solicitudes. | Explica estado, URL final, tipo de contenido y contexto de captura. | Cuando la aplicación necesita el cuerpo legible real. |
¿Cómo afecta la renderización de JavaScript a la extracción de texto?
La conversión de texto solo puede limpiar el contenido que la solicitud captura. Si el HTML de origen ya contiene el texto útil, la renderización agrega peso sin mejorar la salida. Si la página envía un shell de aplicación y llena el contenido visible después de la hidratación, la captura renderizada puede hacer que el texto final esté completo.
Un flujo de trabajo disciplinado prueba ambos estados en objetivos reales. Comienza con la captura de origen, inspecciona el texto, luego habilita la renderización cuando falta contenido importante. Si el contenido llega tarde, puede importar una configuración de espera. Si la página cambia por idioma, cookie o región, los encabezados, sesiones o enrutamiento por país pueden afectar el texto capturado más que la renderización en sí.
Para páginas que requieren ejecución en el navegador, la API de renderización de JavaScript explica la decisión de renderización. Para comparar texto contra HTML, Markdown, JSON, capturas de pantalla y PDFs, utiliza la guía de formatos de respuesta.
¿Qué deben validar los equipos antes de escalar la extracción de texto?
El texto limpio es fácil de consumir, lo que hace que el texto malo sea fácil de pasar por alto. Antes de agrupar un gran conjunto de URL, valida que el contenido principal esté presente, que la navegación repetida se haya reducido, que el idioma sea correcto, que las redirecciones no hayan cambiado la página y que las advertencias importantes o detalles de precios no hayan desaparecido durante la limpieza.
La validación es especialmente importante para monitoreo y flujos de trabajo de IA. Un clasificador, índice de búsqueda o resumidor puede procesar felizmente texto incompleto a menos que el registro de captura explique lo que sucedió. Almacena la URL final, estado, tipo de contenido, tamaño de respuesta, configuración de renderizado y formato de salida con cada resultado para que el equipo pueda separar los cambios de objetivo de los errores de extracción.
| Verificación | Por qué es importante | Señal útil |
|---|---|---|
| Cuerpo principal presente | Búsqueda, resúmenes y monitoreo necesitan el contenido real, no solo texto de diseño. | Compara la salida de texto contra muestras de origen o renderizadas. |
| Nivel de ruido | Navegación y boilerplate repetido pueden distorsionar clasificadores y resúmenes. | Revisa frases repetidas en múltiples URL. |
| Idioma y región | Los objetivos pueden variar el texto por país, idioma, moneda o estado de consentimiento. | Registra encabezados, enrutamiento por país, URL final y muestras de contenido visible. |
| Tamaño de respuesta | Una salida de texto pequeña puede revelar redirecciones, bloqueos suaves o estados renderizados vacíos. | Establece bandas de tamaño esperadas para cada tipo de objetivo. |
| Ajuste de formato | Algunos flujos de trabajo necesitan enlaces, tablas o estructura de citas. | Cambia a Markdown o HTML cuando el texto plano elimina demasiado contexto. |
¿Dónde encaja la salida de texto en los flujos de trabajo de producción?
La salida de texto es útil cuando el resultado del scraping alimenta un sistema que lee, compara o clasifica contenido en lugar de extraer campos DOM precisos. Un trabajo de monitoreo puede comparar instantáneas de texto. Un pipeline de búsqueda puede indexar copia legible. Un proceso de QA puede inspeccionar si una página pública cambió. Un flujo de trabajo ligero de IA puede clasificar o resumir contenido sin llevar marcado al prompt.
ScraperFly mantiene ese flujo de trabajo práctico porque la salida de texto es una opción en el mismo modelo de solicitud. Los equipos pueden probar el objetivo en el API Builder, elegir salida de texto, agregar renderización solo cuando sea necesario y mantener HTML o capturas de pantalla disponibles para depuración cuando el texto solo no puede explicar el resultado.
¿Cómo se mantiene asequible la conversión de texto?
La conversión de HTML a texto puede mantenerse ligera cuando la respuesta de origen ya contiene el contenido. El costo aumenta cuando un flujo de trabajo agrega renderización en el navegador, tiempos de espera, sesiones, enrutamiento por país, entrega premium, capturas de pantalla, PDFs o reintentos repetidos. El patrón eficiente es comenzar simple, inspeccionar la salida y agregar controles solo cuando mejoren el texto capturado.
Esto hace que la salida de texto sea una buena opción para proyectos desiguales y sistemas recurrentes. Los equipos pueden validar algunos objetivos con créditos gratuitos, usar créditos de pago por uso para trabajos de limpieza ocasionales y mover trabajos de extracción o monitoreo predecibles a créditos mensuales cuando el perfil de solicitud esté probado. La página de precios explica cómo ese camino se escala sin forzar cada experimento a una suscripción.







