






Captura lista para el analizador
Convierte páginas públicas en entradas limpias en las que tu propio analizador puede confiar
El análisis del contenido del sitio web comienza antes de que se escriban las reglas de extracción. Tu equipo necesita saber qué devuelve realmente la página pública, si el contenido útil está en HTML fuente o en la salida renderizada, y qué formato de respuesta facilitará el análisis posterior en lugar de hacerlo más ruidoso.
ScraperFly proporciona a los desarrolladores una capa de captura práctica para el contenido de sitios web públicos. Obtén la página, inspecciona la respuesta, elige HTML, texto, Markdown, metadatos, capturas de pantalla o PDFs, y mantén la lógica de análisis, clasificación, enriquecimiento y almacenamiento dentro de tu propio producto donde pertenecen las reglas comerciales.
¿Qué es una API de análisis de contenido de sitios web?
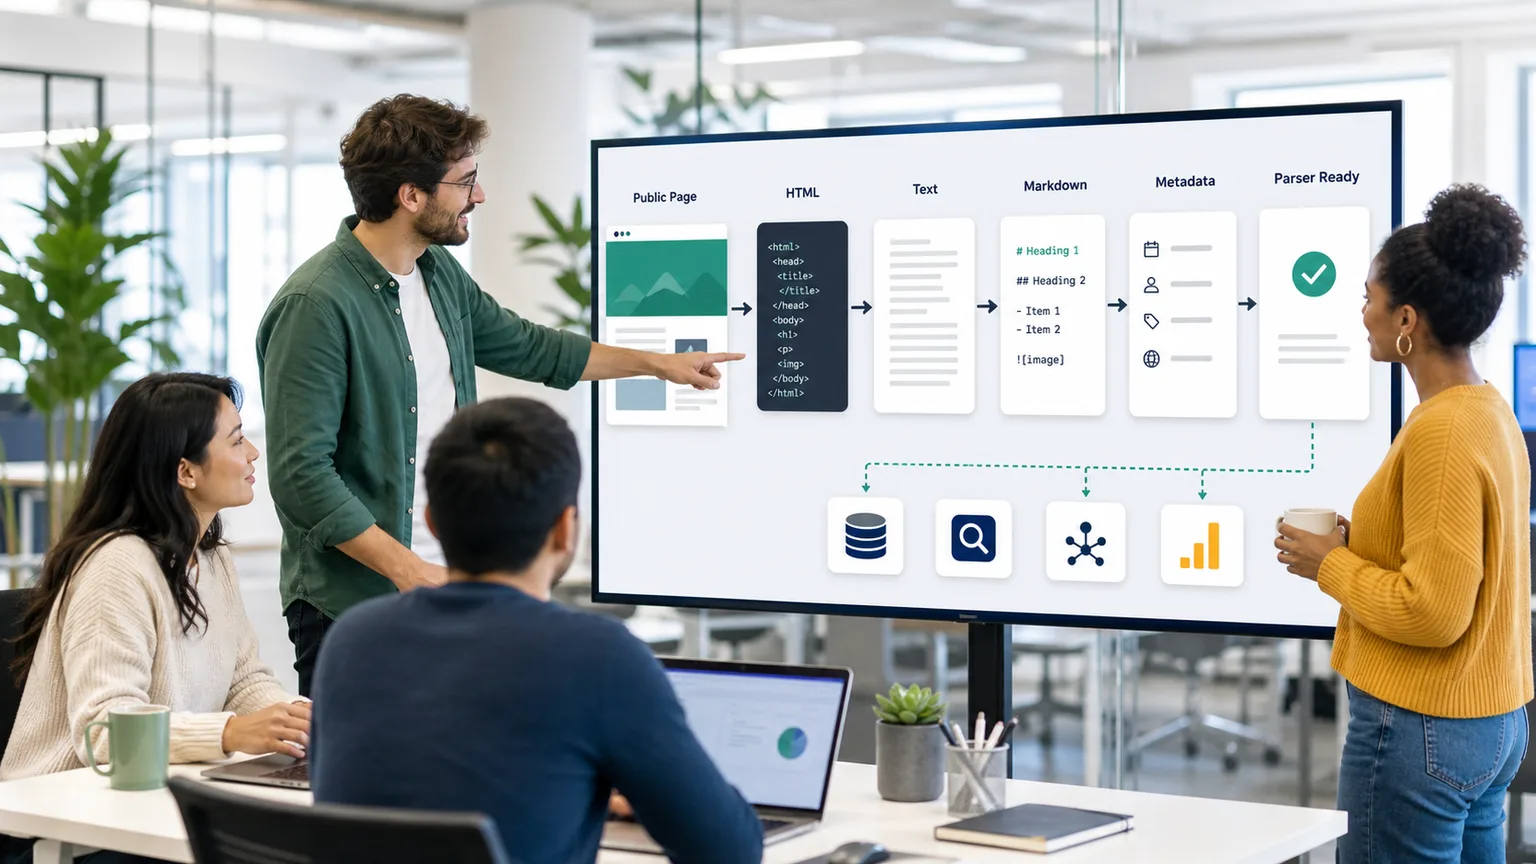
Una API de análisis de contenido de sitios web es útil cuando proporciona a tu aplicación una entrada de página confiable para un analizador, canal de contenido, índice de búsqueda, flujo de trabajo de IA, archivo o sistema de revisión de calidad. La API debe capturar la página pública de manera confiable y devolver suficiente estructura para que tu código posterior decida qué es importante.
ScraperFly se centra en la capa de captura y respuesta. Puede devolver HTML crudo o renderizado cuando la estructura del DOM es importante, texto cuando el analizador solo necesita contenido legible, Markdown cuando los encabezados y enlaces ayudan a la revisión o ingestión de IA, metadatos JSON cuando los registros necesitan contexto operativo, y archivos visuales cuando un humano necesita prueba de cómo apareció la página.
Conclusión práctica: utiliza ScraperFly para capturar contenido de sitios web públicos de manera limpia, luego mantén las reglas de análisis específicas del objetivo en el sistema que entiende tu modelo de datos.
¿Qué debería suceder antes de construir reglas de análisis?
El error costoso es escribir analizadores contra una forma de página imaginada. Un sitio web público puede exponer contenido útil en la primera respuesta HTML, ocultarlo detrás de la renderización del lado del cliente, repetirlo en la navegación, moverlo a metadatos, o devolver una pequeña estructura que te dice muy poco hasta que se ejecute un navegador. El primer trabajo es probar la forma de captura.
Comienza con una solicitud simple, inspecciona el estado, la URL final, el tipo de contenido, el tamaño de la respuesta y el contenido del cuerpo, luego decide qué debe consumir el analizador. Si el HTML fuente ya contiene el contenido objetivo, mantén la solicitud ligera. Si JavaScript cambia el resultado, prueba la salida renderizada. Si el canal está orientado a IA, compara texto limpio y Markdown antes de construir convertidores.
| Pregunta | Qué inspeccionar | Mejor decisión |
|---|---|---|
| ¿Está el contenido útil ya presente? | HTML fuente, tamaño de respuesta, encabezados, enlaces, tablas, tarjetas de producto, cuerpo del artículo o metadatos incrustados. | Utiliza una solicitud HTML o de texto ligera cuando la primera respuesta sea suficiente. |
| ¿JavaScript crea la página final? | Compara HTML fuente con HTML renderizado y estado visible de la página. | Habilita la renderización solo cuando la ejecución del navegador cambie el contenido capturado. |
| ¿Necesita el analizador estructura DOM? | Selectores, atributos, listas, enlaces, paginación, tablas estructuradas y bloques repetidos. | Utiliza HTML cuando las relaciones estructurales son importantes. |
| ¿Es el consumidor un flujo de trabajo de IA o revisión? | Encabezados legibles, enlaces, secciones de artículos, texto estándar y ruido de diseño repetido. | Prueba texto o Markdown antes de construir una capa de limpieza personalizada. |
| ¿Necesita el resultado evidencia? | Estado, URL final, tipo de contenido, captura de pantalla, PDF o artefacto de archivo. | Agrega metadatos o salida visual cuando la depuración, QA, cumplimiento o revisión necesiten prueba. |
¿Cuál es el mejor formato de salida para analizar contenido de sitios web?
No hay un formato único que sea el mejor para cada analizador. HTML es poderoso cuando la lógica de extracción necesita estructura DOM, pero también trae navegación, diseño, scripts y ruido de plantilla repetido. El texto es compacto y fácil de buscar, pero elimina la mayor parte del contexto estructural. Markdown es útil para flujos de trabajo de contenido legible porque los encabezados, enlaces y listas siguen siendo más fáciles de entender. Los metadatos ayudan a depurar la solicitud sin forzar al analizador a inferir todo del cuerpo.
El camino práctico es probar dos o tres salidas en páginas objetivo reales antes de la producción. Un analizador para contenido de artículos puede preferir Markdown. Un trabajo de descubrimiento de enlaces puede necesitar HTML. Un trabajo de monitoreo puede combinar texto con metadatos JSON. Un flujo de trabajo de QA puede adjuntar capturas de pantalla o PDFs solo para registros que necesiten revisión visual.
| Salida | Úsalo cuando | Observa el compromiso |
|---|---|---|
| HTML | El analizador necesita selectores, atributos, enlaces, tablas, datos incrustados o patrones DOM repetidos. | Requiere limpieza y lógica de análisis específica del objetivo. |
| HTML renderizado | La respuesta fuente está incompleta hasta que JavaScript construye la página. | Más pesado que una solicitud básica, así que habilítalo para objetivos probados. |
| Texto | El flujo de trabajo necesita contenido legible compacto para coincidencias, búsqueda, resúmenes o clasificación. | El contexto estructural se reduce. |
| Markdown | Encabezados, enlaces, listas y secciones legibles ayudan a IA, RAG, documentación o revisión de analistas. | No es un reemplazo para la extracción precisa de DOM. |
| Metadatos JSON | Los registros necesitan URL final, estado, tipo de contenido, tiempo o contexto de respuesta. | Los metadatos explican la solicitud; no inventan campos personalizados de destino. |
| Captura de pantalla o PDF | Un revisor o archivo necesita prueba visual del estado de la página pública. | Menos conveniente para el análisis automático y más pesado que la salida de texto. |
Compara el conjunto completo de formatos en la página de formatos de respuesta de la API de web scraping, luego prueba una URL real en el API Builder.
¿Cuándo ayuda la renderización a un analizador de contenido?
La renderización ayuda cuando la ejecución del navegador cambia el contenido útil. Esto es común en páginas que hidratan cuerpos de artículos, tarjetas de productos, listados, reseñas, comentarios, resultados de búsqueda o contenido específico de rutas después de la primera respuesta HTML. No es un distintivo de calidad por sí mismo. Renderizar cada página puede hacer que un analizador sea más lento, más pesado y más difícil de razonar.
Un buen flujo de trabajo de analizador compara la captura de origen cruda con la captura renderizada antes de elegir un valor predeterminado. Si el HTML crudo contiene los datos, mantén el camino simple. Si la página devuelve una estructura vacía, contenido retrasado o un DOM final diferente después de que se ejecute el código del lado del cliente, utiliza la API de renderización de JavaScript y elige la salida útil más pequeña después de la renderización.
¿Dónde debería vivir la lógica de análisis?
ScraperFly no debe ser tratado como una caja negra que mágicamente conoce el significado comercial de cada objetivo. Tu producto sabe qué precio importa, qué sección del artículo es importante, qué campos de revisión son aceptables, qué variantes de página son válidas y cómo debe almacenarse el contenido extraído. Esa lógica pertenece a tu aplicación.
ScraperFly facilita la construcción de esa aplicación al manejar la capa de solicitud: obteniendo páginas públicas, renderizando cuando es necesario, preservando encabezados o sesiones cuando el objetivo requiere contexto, enrutando a través de un país cuando el contenido público difiere según la ubicación, y devolviendo formatos que reducen el trabajo de limpieza. Tu analizador puede entonces centrarse en las reglas específicas del objetivo que crean valor.
Para la captura básica de marcado, consulta la API de scraping de HTML. Para entradas legibles posteriores, compara las páginas de API de analizador de HTML a texto y API de analizador de HTML a Markdown.
¿Cómo mantiene ScraperFly los flujos de trabajo de análisis prácticos?
Los proyectos de análisis a menudo comienzan con objetivos desconocidos. Algunas páginas son simples. Algunas necesitan renderización. Algunas necesitan encabezados, cookies, orientación por país o enrutamiento premium. Algunas no deberían escalarse hasta que se pruebe la forma de respuesta. ScraperFly apoya ese camino incremental en lugar de forzar el perfil de solicitud más pesado desde el primer día.
Comienza gratis, prueba páginas objetivo representativas y mantén cada fuente en el perfil de solicitud más ligero que devuelva contenido utilizable completo. Utiliza créditos de pago por uso mientras el comportamiento y volumen del objetivo aún son inciertos, luego mueve las cargas de trabajo recurrentes del analizador a créditos mensuales una vez que la demanda sea predecible. Eso mantiene el esfuerzo de ingeniería y el costo de solicitud atados a la evidencia, no a suposiciones.
Conclusión práctica: el mejor analizador de contenido de sitios web comienza con una forma de captura probada, un pequeño conjunto de formatos de respuesta y un camino claro de actualización para objetivos más difíciles.










