






Вхід даних RAG
Надайте системам отримання чистіший контекст публічного вебу
Робота RAG починається ще до створення векторів, ранжування або генерації відповідей. Перше рішення полягає в тому, чи може сторінка джерела взагалі створити корисний контент: чистий текст, Markdown з заголовками та посиланнями, HTML для кастомного парсингу або JSON-метадані, які допомагають конвеєру зрозуміти відповідь.
ScraperFly зосереджується на цьому першому етапі. Отримайте публічну сторінку, рендеруйте JavaScript, коли контент створюється браузером, виберіть найменший формат відповіді, якому можуть довіряти системи нижнього рівня, і тримайте погані сторінки подалі від бази знань, перш ніж вони стануть поганими відповідями.
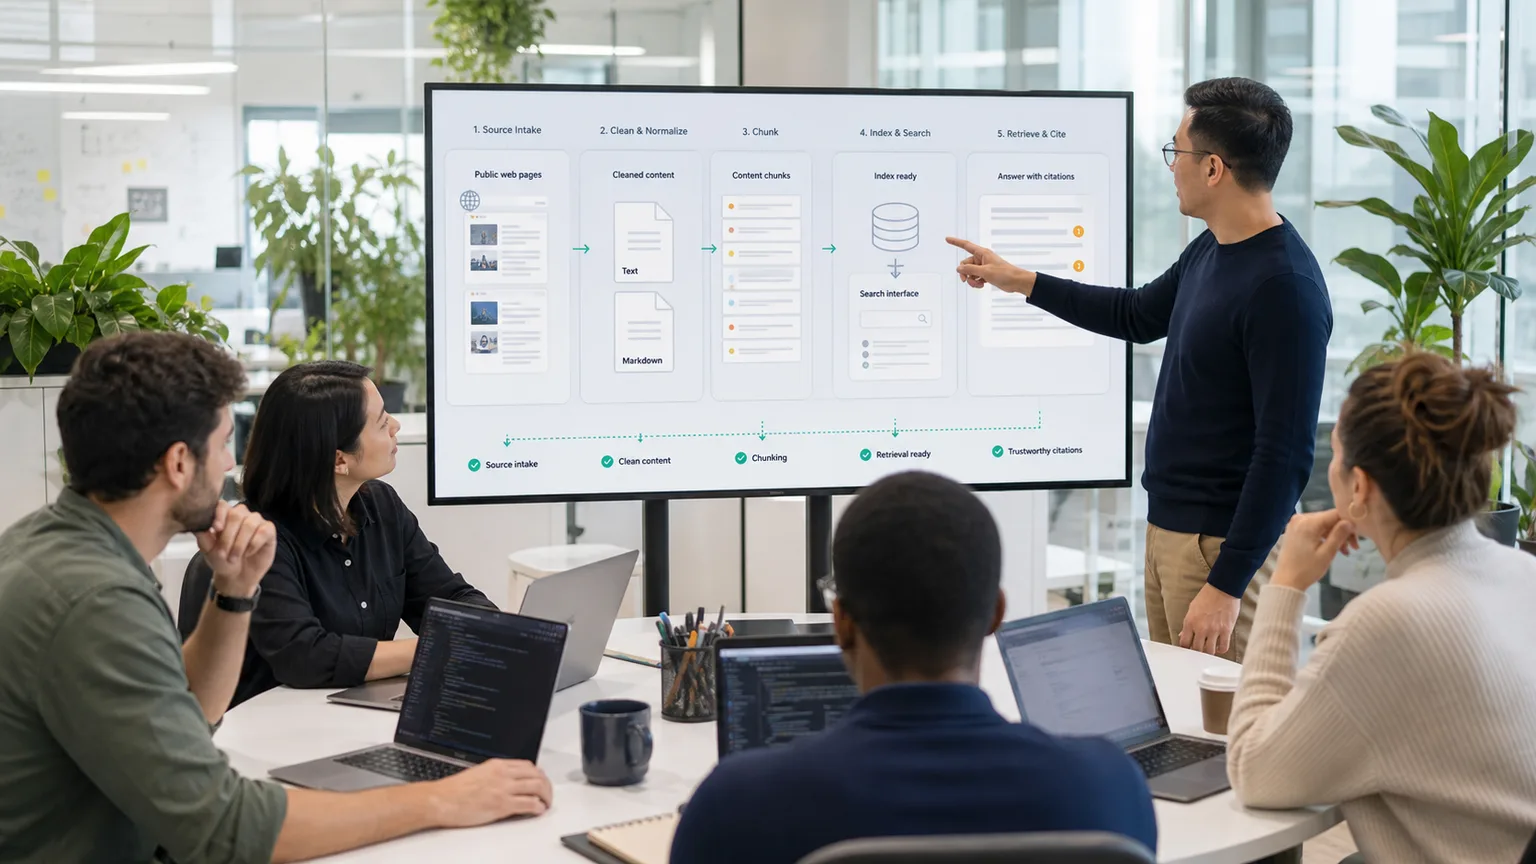
Яку роль відіграє API для веб-скрапінгу в RAG?
API для веб-скрапінгу надає системі RAG вихідний матеріал, необхідний перед початком роботи шару AI. Він отримує публічні сторінки, обробляє доставку запитів, повертає формат відповіді та надає достатньо контексту, щоб вирішити, чи можна використовувати сторінку для розбиття, індексації, отримання та цитування.
Ця роль є більш вузькою та практичною, ніж повна платформа RAG. ScraperFly не потрібно володіти векторами, зберіганням векторів, ранжуванням отримання або генерацією відповідей, щоб бути цінним. Він допомагає командам постачати ці системи чистішим вихідним контентом та кращими доказами запитів.
Який формат відповіді найкращий для вхідних даних RAG?
Найкращий формат залежить від того, що потрібно зберегти в конвеєрі. Чистий текст є компактним і легким для розбиття. Markdown зберігає корисні заголовки, посилання, списки та порядок читання. HTML краще, коли системі все ще потрібні селектори, таблиці, DOM-взаємозв'язки або кастомний екстракційний процес. JSON-метадані допомагають перевірити фінальне URL, статус, тип контенту, заголовки, посилання, текст та Markdown перед виконанням правил інгестії.
Вибір формату на ранньому етапі запобігає поширеній проблемі RAG: заповненню індексу навігацією, текстом нижнього колонтитула, повторюваними шаблонами, банерами cookie, дублікатами карток та порожніми шаблонами. Мета полягає не в тому, щоб зібрати найбільшу відповідь. Мета полягає в тому, щоб захопити форму джерела, яку ваш робочий процес отримання може насправді використовувати.
| Формат | Найкраще використання RAG | На що звертати увагу |
|---|---|---|
| Текст | Просте розбиття, індексація пошуку, компактний контекст | Може видалити корисну структуру та посилання |
| Markdown | Готовий до LLM огляд джерела, частини RAG, сторінки, схожі на документацію | Все ще потребує дуплікації та перевірок якості |
| HTML | Кастомний парсинг, селектори, таблиці, метадані, екстракція посилань | Може включати шум макета та шаблони |
| JSON-метадані | Діагностика, перевірка джерела, рішення про інгестію | Не замінює специфічну для цілей логіку екстракції |
| Скриншот або PDF | Доказ QA та візуальний огляд | Зазвичай не ідеально як основний вхід для отримання |
Як команди повинні перевіряти якість джерела перед індексацією?
Конвеєри RAG тихо зазнають невдачі, коли погані сторінки джерела потрапляють в індекс. Успішна HTTP-відповідь все ще може бути безкорисною, якщо це порожня оболонка, перенаправлення, стіна згоди, заблокована сторінка, дублікат навігації або сторінка, де важливий контент з'являється лише після виконання JavaScript.
Перед масштабуванням інгестії протестуйте репрезентативні URL. Порівняйте сирий HTML з рендереним виходом. Перегляньте зразки тексту та Markdown. Перевірте фінальне URL, статус, тип контенту, розмір відповіді, заголовки, посилання, повторювані секції, дати та мову. Зберігайте приклади прийнятих та відхилених сторінок, щоб правила інгестії базувалися на доказах, а не на припущеннях.
| Перевірка якості | Чому це важливо | Корисний вихід ScraperFly |
|---|---|---|
| Повнота контенту | Запобігає відсутності відповідей та слабким цитатам | HTML, рендерений HTML, Markdown, текст |
| Шум шаблонів | Зменшує нерелевантні частини та повторюваний контекст | Текст, Markdown, JSON-метадані |
| Ідентичність джерела | Допомагає у прийнятті рішень про цитування та свіжість | Фінальне URL, статус, метадані, посилання |
| Залежність від JavaScript | Показує, чи потрібен рендеринг браузера | Сирий HTML у порівнянні з рендереним виходом |
Коли рендеринг JavaScript важливий для RAG?
Рендеринг важливий, коли корисний публічний контент не присутній у початковій HTML-відповіді. Багато сучасних сторінок спочатку надсилають оболонку, а потім завантажують тіла статей, деталі продуктів, коментарі, панелі документації або результати пошуку після виконання коду на стороні браузера. Індексація вихідного HTML з цих сторінок може створити порожній або оманливий контекст.
Правильний підхід полягає в тому, щоб довести розрив, перш ніж дозволити широке виконання браузера. Почніть з простого запиту, перевірте вихідну відповідь, а потім увімкніть рендеринг JavaScript лише для класів джерел, які цього потребують. Це дозволяє статичним сторінкам залишатися недорогими, надаючи динамічним сторінкам чистий шлях до конвеєра RAG.
Як ScraperFly вписується в робочий процес RAG у виробництві?
ScraperFly вписується на рівні вхідних даних. Команди можуть використовувати його для тестування цільових URL, вибору форматів відповіді, обробки рендерингу за потреби, збереження контексту запиту та збору доказів джерела перед тим, як контент перейде до розбиття, векторів, отримання, ранжування та генерації відповідей.
Використовуйте API Builder, щоб порівняти формати перед написанням коду інгестії. Перегляньте формати відповіді API для веб-скрапінгу, щоб вирішити між HTML, текстом, Markdown, JSON, скриншотами та PDF. Для контенту, готового до моделі, порівняйте HTML до Markdown та HTML до тексту робочі процеси, а потім використовуйте цінову політику та калькулятор вартості кредитів перед масштабуванням повторюваної інгестії.










