






Поступление источников RAG
Обеспечьте системам извлечения более чистый контекст публичного веба
Работа RAG начинается до создания встраиваний, ранжирования или генерации ответов. Первое решение заключается в том, может ли исходная страница предоставить полезный контент: чистый текст, Markdown с заголовками и ссылками, HTML для пользовательского парсинга или метаданные JSON, которые помогают системе понять ответ.
ScraperFly сосредоточен на этом первом этапе. Получите публичную страницу, отрендерите JavaScript, когда контент создается в браузере, выберите самый легкий формат ответа, которому могут доверять последующие системы, и исключите плохие страницы из базы знаний, прежде чем они станут плохими ответами.
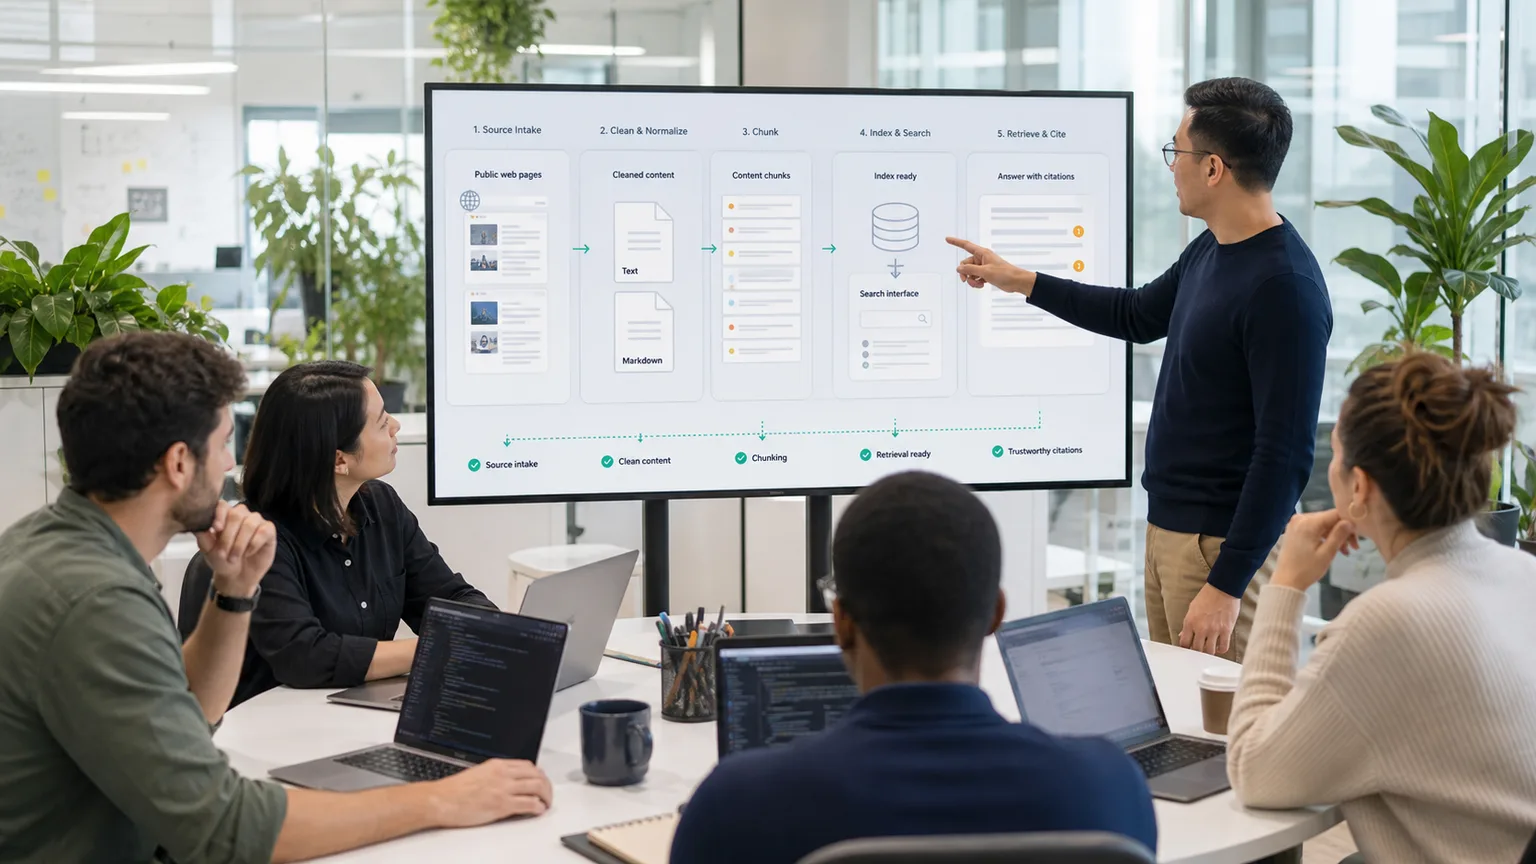
Что вносит API веб-скрапинга в RAG?
API веб-скрапинга предоставляет системе RAG исходный материал, необходимый до начала работы слоя ИИ. Он извлекает публичные страницы, обрабатывает доставку запросов, возвращает формат ответа и предоставляет достаточно контекста, чтобы решить, можно ли использовать страницу для разбиения, индексации, извлечения и цитирования.
Эта роль более узкая и практичная, чем полноценная платформа RAG. ScraperFly не нужно владеть встраиваниями, хранилищем векторов, ранжированием извлечения или генерацией ответов, чтобы быть ценным. Он помогает командам обеспечивать эти системы более чистым исходным контентом и лучшими доказательствами запросов.
Какой формат ответа лучше всего подходит для поступления RAG?
Лучший формат зависит от того, что нужно сохранить в пайплайне. Чистый текст компактен и легко разбивается. Markdown сохраняет полезные заголовки, ссылки, списки и порядок чтения. HTML лучше, когда системе все еще нужны селекторы, таблицы, отношения DOM или пользовательский извлечение. Метаданные JSON помогают проверить финальный URL, статус, тип контента, заголовки, ссылки, текст и Markdown перед запуском правил инжекции.
Ранний выбор формата предотвращает распространенную проблему RAG: заполнение индекса навигацией, текстом подвала, повторяющимся шаблоном, баннерами cookie, дублирующими карточками и пустыми шаблонами. Цель не в том, чтобы скрапить самый большой ответ. Цель состоит в том, чтобы захватить форму источника, которую ваш рабочий процесс извлечения действительно может использовать.
| Формат | Лучшее использование RAG | На что обратить внимание |
|---|---|---|
| Текст | Простое разбиение, индексация поиска, компактный контекст | Может удалить полезную структуру и ссылки |
| Markdown | Готовый к LLM обзор источника, куски RAG, страницы, похожие на документацию | Все еще требует дедупликации и проверки качества |
| HTML | Пользовательский парсинг, селекторы, таблицы, метаданные, извлечение ссылок | Может включать шум макета и шаблоны |
| Метаданные JSON | Диагностика, проверка источника, решения по инжекции | Не заменяет логику извлечения, специфичную для цели |
| Скриншот или PDF | Доказательство QA и визуальный обзор | Обычно не идеален в качестве основного входа для извлечения |
Как командам проверить качество источника перед индексацией?
Пайплайны RAG тихо терпят неудачу, когда плохие исходные страницы попадают в индекс. Успешный HTTP-ответ все еще может быть бесполезным, если это пустая оболочка, перенаправление, стена согласия, заблокированная страница, дублированная навигация или страница, где важный контент появляется только после выполнения JavaScript.
Перед масштабированием инжекции протестируйте репрезентативные URL. Сравните сырой HTML с отрендеренным выводом. Просмотрите образцы текста и Markdown. Проверьте финальный URL, статус, тип контента, размер ответа, заголовки, ссылки, повторяющиеся разделы, даты и язык. Храните примеры принятых и отклоненных страниц, чтобы правила инжекции основывались на доказательствах, а не на предположениях.
| Проверка качества | Почему это важно | Полезный вывод ScraperFly |
|---|---|---|
| Полнота контента | Предотвращает пропуск ответов и слабые цитаты | HTML, отрендеренный HTML, Markdown, текст |
| Шум шаблона | Снижает количество нерелевантных кусков и повторяющегося контекста | Текст, Markdown, метаданные JSON |
| Идентичность источника | Помогает в решениях по цитированию и свежести | Финальный URL, статус, метаданные, ссылки |
| Зависимость от JavaScript | Показывает, необходимо ли рендеринг в браузере | Сравнение сырого HTML с отрендеренным выводом |
Когда рендеринг JavaScript важен для RAG?
Рендеринг важен, когда полезный публичный контент отсутствует в начальном HTML-ответе. Многие современные страницы сначала отправляют оболочку, а затем загружают тела статей, детали продуктов, комментарии, панели документации или результаты поиска после выполнения кода на стороне браузера. Индексация исходного HTML с этих страниц может создать пустой или вводящий в заблуждение контекст.
Правильный подход заключается в том, чтобы доказать разрыв, прежде чем включать выполнение браузера в широком масштабе. Начните с простого запроса, проверьте исходный ответ, затем включите рендеринг JavaScript только для классов источников, которым это необходимо. Это позволяет сохранить статические страницы недорогими, обеспечивая динамическим страницам чистый путь в RAG-пайплайн.
Как ScraperFly вписывается в производственный рабочий процесс RAG?
ScraperFly вписывается на уровень поступления источников. Команды могут использовать его для тестирования целевых URL, выбора форматов ответов, обработки рендеринга при необходимости, сохранения контекста запроса и сбора доказательств источника перед тем, как контент перейдет в разбиение, встраивания, извлечение, ранжирование и генерацию ответов.
Используйте API Builder, чтобы сравнить форматы перед написанием кода инжекции. Просмотрите форматы ответов API веб-скрапинга, чтобы решить между HTML, текстом, Markdown, JSON, скриншотами и PDF. Для контента, готового к модели, сравните HTML с Markdown и HTML с текстом, затем используйте цены и калькулятор стоимости кредитов перед масштабированием повторяющейся инжекции.










