






Entrada de fonte RAG
Dê aos sistemas de recuperação um contexto mais limpo da web pública
O trabalho RAG começa antes das incorporações, classificação ou geração de respostas. A primeira decisão é se a página de origem pode produzir conteúdo útil: texto limpo, Markdown com cabeçalhos e links, HTML para análise personalizada ou metadados JSON que ajudam o pipeline a entender a resposta.
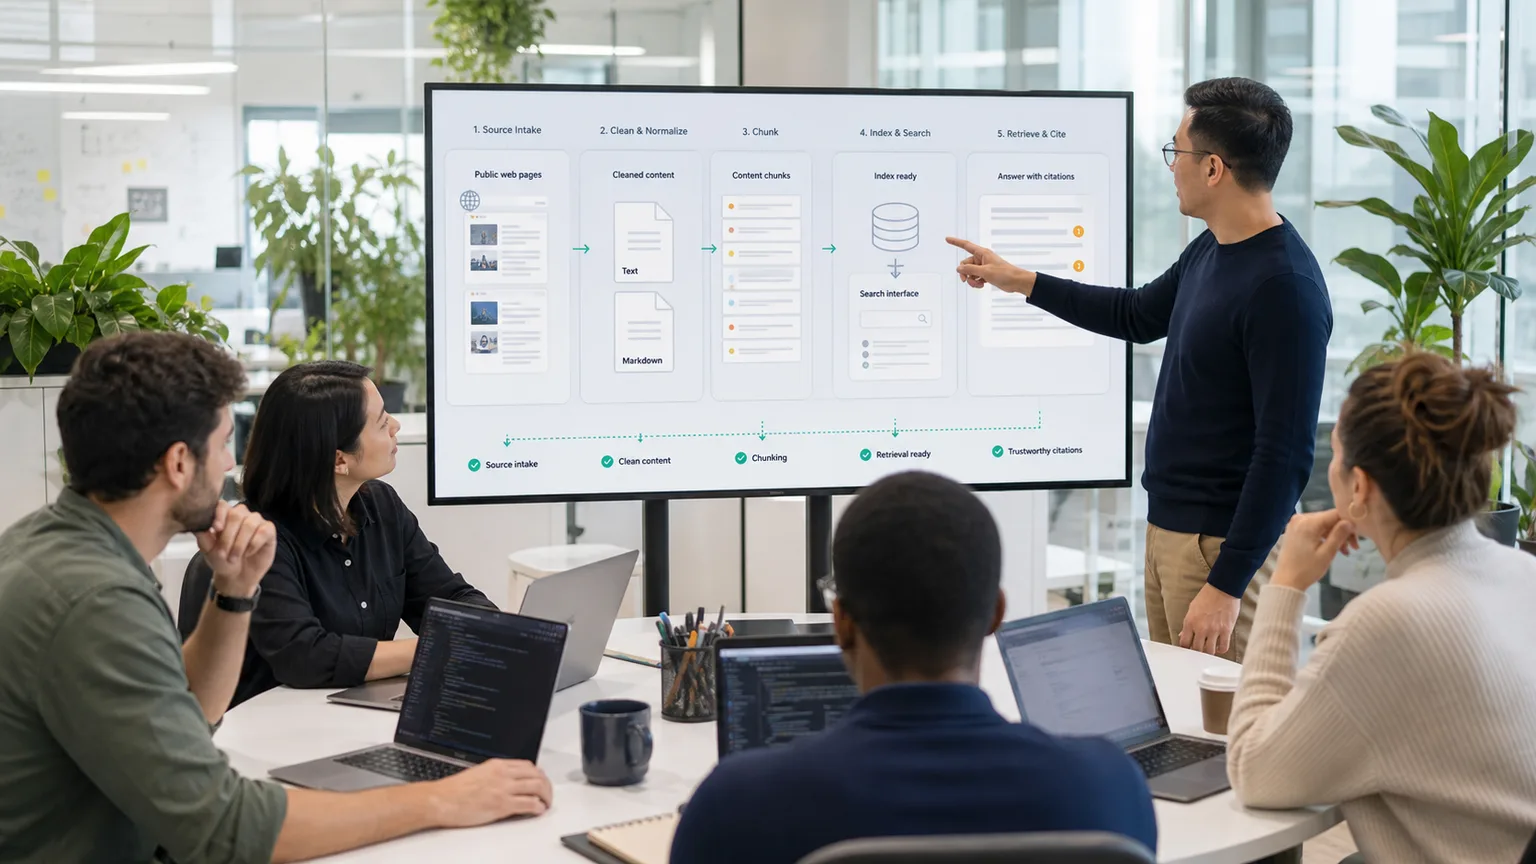
ScraperFly foca nessa primeira milha. Busque a página pública, renderize JavaScript quando o conteúdo for gerado pelo navegador, escolha o formato de resposta mais leve que os sistemas a jusante possam confiar e mantenha páginas ruins fora da base de conhecimento antes que se tornem respostas ruins.
O que uma API de web scraping contribui para RAG?
Uma API de web scraping fornece a um sistema RAG o material de origem necessário antes que a camada de IA comece. Ela recupera páginas públicas, gerencia a entrega de solicitações, retorna um formato de resposta e fornece contexto suficiente para decidir se a página é utilizável para fragmentação, indexação, recuperação e citação.
Esse papel é mais restrito e prático do que uma plataforma RAG completa. ScraperFly não precisa possuir incorporações, armazenamento de vetores, classificação de recuperação ou geração de respostas para ser valiosa. Ela ajuda as equipes a alimentar esses sistemas com conteúdo de origem mais limpo e melhor evidência de solicitação.
Qual formato de resposta é melhor para entrada RAG?
O melhor formato depende do que o pipeline precisa preservar. Texto limpo é compacto e fácil de fragmentar. Markdown mantém cabeçalhos, links, listas e ordem de leitura úteis. HTML é melhor quando o sistema ainda precisa de seletores, tabelas, relacionamentos DOM ou extração personalizada. Metadados JSON ajudam a inspecionar URL final, status, tipo de conteúdo, cabeçalhos, links, texto e Markdown antes que as regras de ingestão sejam executadas.
Escolher o formato cedo previne um problema comum de RAG: encher o índice com navegação, texto de rodapé, boilerplate repetido, banners de cookies, cartões duplicados e templates vazios. O objetivo não é raspar a maior resposta. O objetivo é capturar a forma da fonte que seu fluxo de trabalho de recuperação pode realmente usar.
| Formato | Melhor uso RAG | O que observar |
|---|---|---|
| Texto | Fragmentação simples, indexação de busca, contexto compacto | Pode remover estrutura e links úteis |
| Markdown | Revisão de fonte pronta para LLM, fragmentos RAG, páginas semelhantes a documentação | Ainda precisa de desduplicação e verificações de qualidade |
| HTML | Análise personalizada, seletores, tabelas, metadados, extração de links | Pode incluir ruído de layout e boilerplate |
| Metadados JSON | Diagnósticos, inspeção de fonte, decisões de ingestão | Não substitui a lógica de extração específica do alvo |
| Captura de tela ou PDF | Prova de QA e revisão visual | Normalmente não é ideal como entrada primária de recuperação |
Como as equipes devem validar a qualidade da fonte antes da indexação?
Pipelines RAG falham silenciosamente quando páginas de origem ruins entram no índice. Uma resposta HTTP bem-sucedida ainda pode ser inútil se for uma casca vazia, um redirecionamento, uma parede de consentimento, uma página bloqueada, navegação duplicada ou uma página onde o conteúdo importante aparece apenas após a execução do JavaScript.
Antes de escalar a ingestão, teste URLs representativas. Compare HTML bruto com saída renderizada. Revise amostras de texto e Markdown. Verifique URL final, status, tipo de conteúdo, tamanho da resposta, cabeçalhos, links, seções repetidas, datas e idioma. Mantenha exemplos de páginas aceitas e rejeitadas para que as regras de ingestão sejam baseadas em evidências e não em suposições.
| Verificação de qualidade | Por que é importante | Saída útil do ScraperFly |
|---|---|---|
| Completude do conteúdo | Previne respostas ausentes e citações fracas | HTML, HTML renderizado, Markdown, texto |
| Ruído de boilerplate | Reduz fragmentos irrelevantes e contexto repetido | Texto, Markdown, metadados JSON |
| Identidade da fonte | Ajuda nas decisões de citação e frescor | URL final, status, metadados, links |
| Dependência de JavaScript | Mostra se a renderização do navegador é necessária | HTML bruto comparado com saída renderizada |
Quando a renderização de JavaScript é importante para RAG?
A renderização é importante quando o conteúdo público útil não está presente na resposta HTML inicial. Muitas páginas modernas enviam uma casca primeiro, depois carregam corpos de artigos, detalhes de produtos, comentários, painéis de documentação ou resultados de busca após a execução do código do lado do navegador. Indexar o HTML de origem dessas páginas pode criar contexto vazio ou enganoso.
A abordagem certa é provar a lacuna antes de habilitar a execução do navegador amplamente. Comece com uma solicitação simples, inspecione a resposta da fonte, depois habilite renderização de JavaScript apenas para classes de fonte que precisam disso. Isso mantém páginas estáticas baratas enquanto dá às páginas dinâmicas um caminho limpo para o pipeline RAG.
Como o ScraperFly se encaixa em um fluxo de trabalho RAG de produção?
ScraperFly se encaixa na camada de entrada de fonte. As equipes podem usá-lo para testar URLs de destino, escolher formatos de resposta, lidar com renderização quando necessário, preservar o contexto da solicitação e coletar evidências de fonte antes que o conteúdo se mova para fragmentação, incorporações, recuperação, classificação e geração de respostas.
Use o API Builder para comparar formatos antes de escrever o código de ingestão. Revise formatos de resposta da API de web scraping para decidir entre HTML, texto, Markdown, JSON, capturas de tela e PDFs. Para conteúdo pronto para modelo, compare HTML para Markdown e HTML para texto workflows, depois use preços e o calculador de custo de crédito antes de escalar a ingestão recorrente.










